Anderson 视角
能够理解场景的 AI 图像抠像

 将 Unite.AI 添加到您在 Google 上的首选来源
要点AI 抠图现在利用场景理解来取代绿幕。
查看更多
- AI 抠图现在利用场景理解来取代绿幕。
- 新的 SPG-IM 流程大幅优于无 trimap 方法。
- 文本标签为昂贵的像素标注提供了一种低成本替代方案。
在电影《Alien3》(1992 年)的 2003 年 DVD 版附赠纪录片中,视觉特效传奇人物理查德·埃德伦德心有余悸地回忆起光化学抠像过程中的“相扑摔跤”。这种工艺从20 世纪 30 年代末至 20 世纪 80 年代末主导着视觉特效制作。埃德伦德把这一过程时好时坏的特点比作“相扑摔跤”,并将其与 20 世纪 90 年代初取而代之的数字蓝幕/绿幕技术相比较(此后,他也曾再次提到这个比喻)。
要把前景元素(例如人物或飞船模型)从背景中分离出来,以便将抠出的图像合成到背景底片上,最初的做法是让前景物体处于纯色的蓝色或绿色背景前进行拍摄。
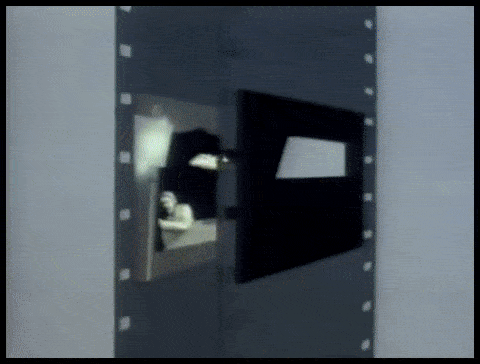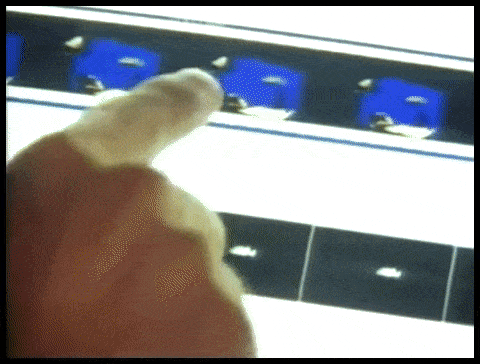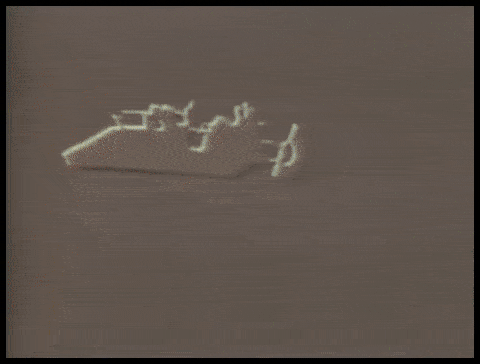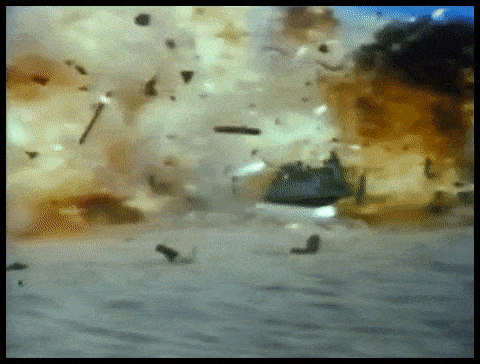
ILM 为《绝地归来》(1983 年)中的一个视觉特效镜头进行的繁复光化学抠像处理。
拍摄完成后,背景颜色会通过化学方法分离出来,并用作模板,在光学印片机中重新印制前景物体(或人物),使其成为透明胶片画格中的“漂浮”对象。
这种方法称为彩色分离叠加(CSO),不过后来,这个术语更多地用于指称 20 世纪 70 年代和 80 年代低成本电视节目中粗糙的“色键”视频特效;这类特效依靠模拟手段实现,而非化学或数字技术。

1970 年,英国儿童节目《Blue Peter》展示彩色分离叠加技术。 来源:https://www.bbc.co.uk/archive/blue_peter_noakes_CSO/zwb9vwx
无论用于电影还是视频素材,完成上述处理后,抠出的画面都可以插入其他任何影像中。
尽管迪士尼成本显著更高且专有的钠蒸气抠像工艺(专门以黄色为键色,也曾用于阿尔弗雷德·希区柯克 1963 年的恐怖片《The Birds》)能呈现更清晰的画面和更利落的遮罩,光化学抠像仍然费时费力,而且效果并不可靠。

迪士尼的专有钠蒸气抠像工艺要求背景颜色接近光谱中的黄色端。图中,安吉拉·兰斯伯里在拍摄《Bedknobs and Broomsticks》(1971 年)中一个包含视觉特效的片段时,被钢丝吊在空中。 来源
超越数字抠像
20 世纪 90 年代的数字革命淘汰了化学处理,却没有消除对绿幕的需求。此时,人们已可以在 Photoshop 等图像编辑软件中,搜索颜色处于一定容差范围内的像素,从而去除绿色(或其他颜色的)背景;新一代视频合成套件也能够自动抠除有色背景。几乎一夜之间,光学印片行业的六十年历史便成了过去。
过去十年间,GPU 加速计算机视觉研究的发展正推动抠像技术迈入第三个时代,研究人员肩负起开发新系统的任务:无需绿幕,也能提取高质量遮罩。仅在 arXiv 上,与机器学习前景提取创新相关的论文就每周都有发表。
让我们入镜
学术界和产业界对 AI 抠像的浓厚兴趣已经影响到消费市场:我们都熟悉一些粗糙但实用的实现方式,例如Zoom和Skype的视频通话滤镜,可以把客厅背景换成热带岛屿等场景。
不过,效果最好的遮罩仍然需要绿幕,正如Zoom 上周三指出的那样。

左图是一名男子站在绿幕前,通过 Zoom 的“虚拟背景”功能,头发得到了良好的抠像效果。右图是一名女子站在普通的家庭场景前,系统通过算法抠出她的头发,但准确度较低,而且需要更强的计算能力。 来源:https://support.zoom.us/hc/en-us/articles/210707503-Changing-your-Virtual-Background-image
Zoom Support 平台上的一篇后续帖子提醒用户,不使用绿幕进行抠像,也需要采集设备具备更强的计算能力。
抠像的必要性
提升自然场景抠像系统的质量、可移植性和资源效率(即无需绿幕即可分离人物),其意义远不止于视频会议滤镜,还关乎更多行业和应用领域。
在数据集开发方面,提升对面部、整个头部和全身的识别能力,有望确保无关的背景元素不会被一并用于训练人类主体的计算机视觉模型;更精准的分离将大幅改进语义分割技术,使其能够区分并识别不同类别(即“猫”、“人物”、“船”),并改进基于VAE和Transformer的图像合成系统,例如 OpenAI 的新产品DALL-E 2;更出色的提取算法还将减少昂贵的视觉特效制作流程对人工逐帧描摹(rotoscoping)的需求。
事实上,多模态(通常是文本与图像)方法正日益兴起,并已开始应用于图像处理。这类方法会将“猫”等类别同时编码为图像和相关文本描述。近期的一个例子是Text2Live架构,它采用多模态(文本与图像)训练,能够生成视频,内容包括水晶天鹅和玻璃长颈鹿等众多可能的对象。
具备场景感知能力的 AI 抠像
许多关于 AI 自动抠像的研究都聚焦于边界识别,以及对图像或视频帧中基于像素划分的区域进行评估。然而,中国的一项新研究提出了一套提取流程,借助基于文本的场景描述(过去 3 至 4 年来,这种多模态方法在计算机视觉研究领域日益受到关注),提升了轮廓界定的精度和抠像质量,并声称在多个方面优于以往方法。

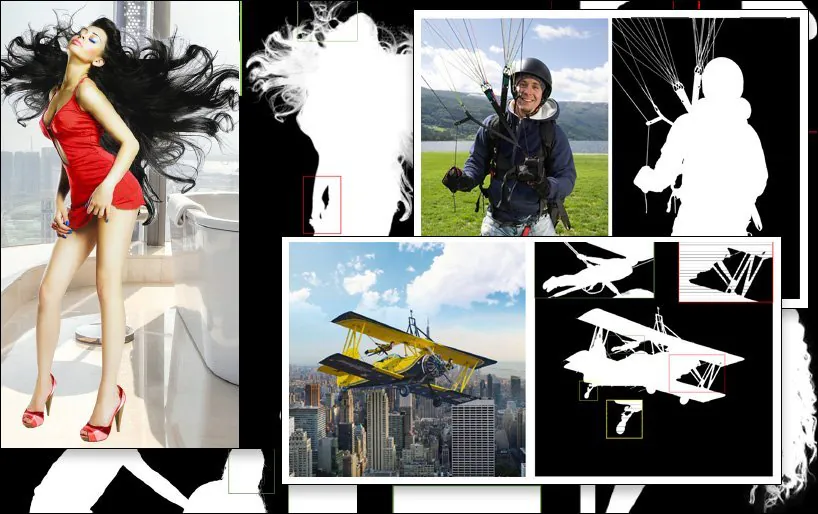
SPG-IM 提取示例(最后一张图,右下角),与此前的竞争方法进行比较。 来源:https://arxiv.org/pdf/2204.09276.pdf
提取研究这一细分领域面临的挑战,是开发将人工标注和人为干预降至最低(理想情况下完全无需此类操作)的工作流程。除了成本方面的影响,新论文的研究人员还指出,不同文化背景的外包众包工作者所做的标注和人工分割,可能会导致图像被以不同方式标记甚至分割,进而造成算法表现不一致且效果不理想。
一个例子是人们对“前景对象”定义的主观理解:

摘自新论文:此前的LFM和MODNet方法(“GT”代表 Ground Truth,即真实标注,是一种“理想”结果,通常通过人工或非算法方法获得)对前景内容的定义各不相同,效果也参差不齐;相比之下,新的 SPG-IM 方法能够借助场景上下文,更有效地界定“近处内容”。
为解决这一问题,研究人员开发了一套两阶段流程,名为Situational Perception Guided Image Matting(SPG-IM)。这一两阶段编码器/解码器架构由 Situational Perception Distillation(SPD)和 Situational Perception Guided Matting(SPGM)组成。

SPG-IM 架构。
首先,SPD 会对视觉特征到文本特征的转换进行预训练,为相应图像生成恰当的描述。之后,通过将该流程与一种新颖的显著性预测技术相结合,即可预测前景掩码。
随后,SPGM 根据原始 RGB 图像输入,以及第一个模块生成的掩码,输出估算的 Alpha 抠像结果。
其目标是通过场景感知提供指导,让系统理解图像由哪些内容构成,从而能够根据特定任务的已知特征来处理相关难题,例如从背景中提取复杂的头发。

在下方的示例中,SPG-IM 能够识别出绳索是“降落伞”不可或缺的一部分,而 MODNet 无法保留并界定这些细节。同样,在上方的示例中,MODNet 任意丢失了游乐场设施的完整结构。
这篇新论文题为情境感知引导的图像抠图,由 OPPO Research Institute、PicUp.ai 和 Xmotors 的研究人员共同撰写。
智能自动抠图
SPG-IM 还提出了一种自适应焦点变换(AFT)细化网络,可分别处理局部细节和全局上下文,从而实现“智能抠图”。

理解场景上下文——在本例中是“女孩与马”——有望比以往的方法更轻松地提取前景。
论文指出:
“我们认为,来自视觉转文本任务(例如图像描述)的视觉表征,能够聚焦于更全面的语义信号,包括 a) 物体与物体之间,以及 b) 物体与周围环境之间的关系,从而生成兼顾全局信息和局部细节的描述。此外,与图像抠图中成本高昂的像素标注相比,文本标签可以以极低的成本大规模收集。”
该架构的 SPD 分支与密歇根大学的VirTex Transformer 文本解码器联合预训练;该解码器通过语义信息丰富的图像描述学习视觉表征。

VirTex 通过图像与描述配对数据联合训练 ConvNet 和 Transformer,并将所得知识迁移至目标检测等下游视觉任务。 来源:https://arxiv.org/pdf/2006.06666.pdf
除其他测试和消融研究外,研究人员还将 SPG-IM 与最先进的基于三元图的方法进行了比较,包括 Deep Image Matting(DIM)、IndexNet、Context-Aware Image Matting(CAM)、Guided Contextual Attention(GCA)、FBA 和 Semantic Image Matting(SIM)。
测试的其他既有框架还包括无需三元图的方法LFM、HAttMatting和MODNet。为确保比较公平,研究人员根据各方法的不同原理对测试方法进行了调整;对于无法获取代码的方法,则依据论文所述架构复现了相关技术。
这篇新论文指出:
“我们的 SPG-IM 大幅优于所有具有竞争力的无三元图方法([LFM]、[HAttMatting]和[MODNet])。与此同时,在公开数据集(即 Composition-1K、Distinction-646 和 Human-2K)以及我们的 Multi-Object-1K 基准上,就全部四项指标而言,我们的模型也显著优于最先进(SOTA)的基于三元图和掩码引导的方法。”
论文还接着指出:
“显然可以看出,即使没有三元图的引导,我们的方法仍能保留精细细节(例如发梢、透明纹理和边界)。此外,与其他具有竞争力的无三元图模型相比,我们的 SPG-IM 能更好地保留全局语义完整性。”


首次发布于2022年4月24日。