Anderson 视角
AI帮助紧张的演讲者在视频会议中“读懂”观众

 将 Unite.AI 添加到您在 Google 上的首选来源
2013年,一项关于常见恐惧症的调查发现,公开演讲的前景比死亡的前景更可怕,对于大多数受访者来说,这种症状被称为公开演讲恐惧症。
由于COVID-19疫情,人们从面对面会议转向在线视频会议,使用Zoom和Google Spaces等平台,令人惊讶的是,这并没有改善这种情况。当会议中有大量参与者时,我们的自然威胁评估能力会因低分辨率的参与者行和图标以及难以读懂微妙的视觉信号(如面部表情和身体语言)而受到损害。例如,Skype被认为是传递非语言暗示的糟糕平台。
公开演讲的表现受到感知兴趣和响应的影响,这些影响已经被充分记录下来,并且对我们大多数人来说是直观明显的。模糊的观众反应会导致演讲者犹豫并转而使用填充性言语,无法确定他们的论点是否得到同意、鄙视或漠不关心,往往使演讲者和听众都感到不舒服。
由于COVID-19疫情的突然转向在线视频会议,问题可能会变得更加严重,过去两年中,计算机视觉和情感研究社区中已经提出了几种改善观众反馈的方案。
硬件导向的解决方案
然而,大多数这些解决方案都需要额外的设备或复杂的软件,这可能会引起隐私或后勤问题,这是一种相对高成本或资源受限的方法,早于疫情。2001年,麻省理工学院提出了Galvactivator,一种手戴设备,可以推断出观众参与者的情绪状态,在一天的研讨会中进行了测试。

麻省理工学院2001年的Galvactivator测量皮肤电导反应,试图了解观众情绪与参与度。 来源: https://dam-prod.media.mit.edu/x/files/pub/tech-reports/TR-542.pdf
学术界也投入了大量精力使用点击反馈器作为观众反应系统(ARS),一种提高观众参与度的措施(这也会增加参与度,因为它迫使观众成为一个主动的反馈节点),同时也被视为鼓励演讲者的手段。
其他尝试连接演讲者和观众的方法包括心率监测、使用复杂的身体穿戴设备来利用脑电图、“欢呼表”、基于计算机视觉的情绪识别用于办公桌工人,以及使用观众发送的表情符号在演讲者的演讲中。

2017年的EngageMeter是慕尼黑大学与斯图加特大学的联合研究项目。 来源: http://www.mariamhassib.net/pubs/hassib2017CHI_3/hassib2017CHI_3.pdf
作为观众分析领域中一个有利可图的子领域,私营部门对凝视估计和跟踪特别感兴趣——每个观众成员(他们可能最终会说话)都接受眼动追踪,以此作为参与度和赞同的指标。
所有这些方法都相当高摩擦。许多方法都需要定制的硬件、实验室环境、专门的软件框架和昂贵的商业API订阅——或这些限制性因素的任何组合。
因此,基于视频会议的常用工具开发最小化系统的兴趣在过去18个月中显著增加。
以不显眼的方式报告观众的认可
为此,东京大学和卡内基梅隆大学之间的新研究合作提供了一种新系统,可以使用仅具有网络摄像头的网站上的轻量级凝视和姿势估计软件来搭载标准视频会议工具(如Zoom)。这样就避免了对本地浏览器插件的需求。
用户的点头和估计的眼球注意力被转化为代表性数据,并以“实时”的方式呈现给演讲者,允许演讲者对内容吸引观众的程度进行“实时”测试——以及演讲者可能正在失去观众兴趣的讨论时段的模糊指标。
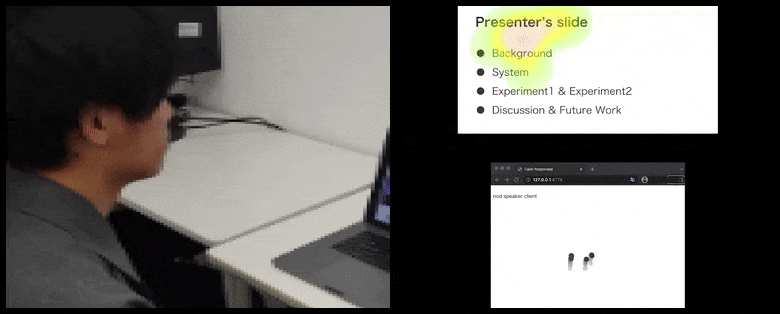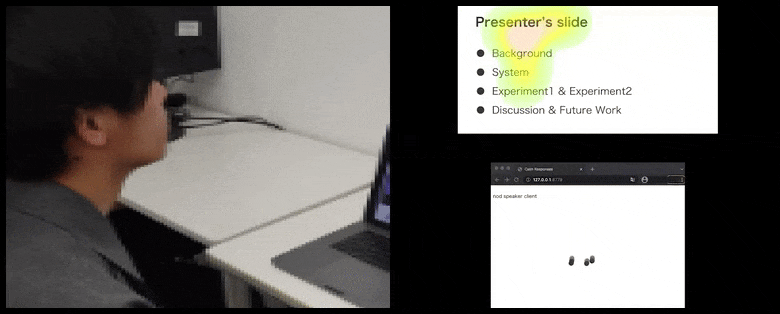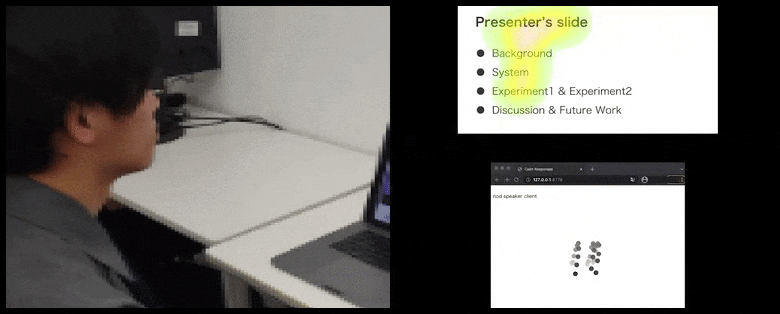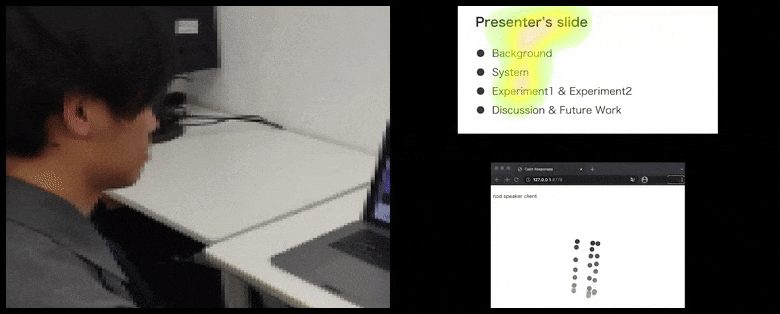
CalmResponses把用户的注意力和点头数据加入观众反馈集合,并转化为有助于演讲者的可视化信息。详情和示例见文末嵌入的视频。 来源: https://www.youtube.com/watch?v=J_PhB4FCzk0
在在线讲座等学术场景中,学生可能不愿通过视频展示背景或当时的外貌,因此演讲者看不到他们。CalmResponses可以报告其视线方向和点头情况,而不向其他参与者分享他们的视频画面。不过,系统仍需使用网络摄像头在本地捕捉这些动作。
该论文的标题是《CalmResponses:远程通信中的集体观众反应》 ,这是东京大学两名研究人员与卡内基梅隆大学一名研究人员的联合工作。
作者提供了一个基于Web的演示,并在GitHub上发布了源代码。
CalmResponses框架
CalmResponses对点头的兴趣,而不是其他可能的头部姿势,是基于一些研究(其中一些可以追溯到达尔文时代),表明超过80%的所有听众的头部运动都是点头(即使他们正在表达不同意)。同时,多项研究表明,眼动是兴趣或参与度的可靠指标。
CalmResponses使用HTML、CSS和JavaScript实现,包括三个子系统:观众客户端、演讲者客户端和服务器。观众客户端通过WebSockets将眼球凝视或头部运动数据从用户的网络摄像头传输到云应用平台Heroku。

CalmResponses在右侧以动画显示观众点头。此处的可视化不仅面向演讲者,也面向全体观众。 来源: https://arxiv.org/pdf/2204.02308.pdf
对于项目的眼球跟踪部分,研究人员使用了WebGazer,一种轻量级、基于JavaScript的浏览器内眼球跟踪框架,可以直接从网站以低延迟运行(请参见上面的研究人员自己的基于Web的实现)。由于简单实现和粗略的反应识别的需求超过了对凝视和姿势估计的高精度需求,输入姿势数据在被用于整体反应估计之前会根据平均值进行平滑处理。
点头动作通过JavaScript库clmtrackr进行评估,该库通过正则化标志点均值漂移将面部模型拟合到图像或视频中检测到的面部。出于经济和低延迟的考虑,作者的实现中只持续追踪检测到的鼻部标志点,因为这足以跟踪点头动作。

用户鼻尖位置的移动形成轨迹,加入与点头相关的观众反馈集合,并向所有参与者汇总展示。
热力图
虽然点头活动由动态移动点表示(请参见上面的图像和视频),视觉注意力以热力图的形式报告,显示演讲者和观众在共享的演示屏幕或视频会议环境中关注的总体焦点。

所有参与者都能看到总体注意力的方向。论文未说明用户能看到其他参与者的画廊视图时是否也能使用这一功能;这种情况下可能因各种原因显示出对某一参与者的表面关注。
测试
为CalmResponses制定了两个测试环境,构成隐含的消融研究,并采用三种不同条件:在“B(基线)”条件中,作者复制了一个典型的在线学生讲座,学生们大多数关闭了网络摄像头,演讲者无法看到观众的面部;在“CR-E(眼动反馈)”条件中,演讲者可以看到凝视反馈(热力图);在“CR-N(点头和眼动反馈)”条件中,演讲者可以看到来自观众的点头和凝视活动。
第一个实验包括基线条件和CR-E(眼动反馈)条件;第二个实验包括基线条件和CR-N(点头和眼动反馈)条件。从演讲者和观众那里获得了反馈。
在每个实验中,评估了三个因素:演讲的客观和主观评估(包括演讲者关于演讲进展的自我报告问卷);“填充性言语”的事件数量,表明暂时的不安全感和犹豫;以及定性评论。这些标准是演讲质量和演讲者焦虑的常用评估指标。
测试池由38人组成,年龄在19-44岁之间,包括29名男性和9名女性,平均年龄为24.7岁,所有人都是日本人或中国人,且都精通日语。他们被随机分成六组,每组5–7名参与者,且没有个人熟悉关系。
测试是在Zoom上进行的,第一轮实验中有五名演讲者,第二轮实验中有六名演讲者。

填充性言语条件用橙色框标出。总体上,填充性言语的减少与系统提供的观众反馈增加大致成比例。
研究人员指出,一位演讲者的填充性言语显著减少,在“CR-N(点头和眼动反馈)”条件下,演讲者很少说出填充性短语。请参见论文中报告的详细和详尽的结果;然而,最明显的结果是来自演讲者和观众参与者的主观评估。
观众的评论包括:
“我觉得自己参与了演讲”[AN2];“我不确定演讲者的表现是否有所改善,但其他人的头部运动可视化让我产生了一种团结感。”[AN6]
“我不确定演讲者的表现是否有所改善,但其他人的头部运动可视化让我产生了一种团结感。”
研究人员指出,该系统引入了一种新的人工暂停到演讲者的演讲中,因为演讲者倾向于参考视觉系统来评估观众反馈,然后再继续下去。
他们还指出,在实验环境中很难避免“白大褂效应”,一些参与者感到受到潜在的安全影响的约束,因为他们的生物数据被监测。
结论
像这样的系统的一个显著优势是,所有非标准的辅助技术在使用后完全消失。没有残留的浏览器插件需要卸载,也没有理由让参与者怀疑是否应该在各自的系统上保留它们;也没有必要指导用户完成安装过程(尽管基于Web的框架需要用户花一两分钟进行初始校准),或导航用户可能没有足够的权限在本地安装软件的可能性,包括基于浏览器的插件和扩展。
虽然评估的面部和眼球运动可能不如在使用专用本地机器学习框架(如YOLO系列)时那样精确,但这种几乎无摩擦的方法为典型的视频会议场景中的广泛情绪和态度分析提供了足够的准确性。最重要的是,它非常廉价。
请查看下面的项目视频以获取更多详细信息和示例。
最初发布于2022年4月11日。