Основи ШІ
Що таке підкріплювальне навчання за допомогою людського зворотного зв’язку (RLHF)?

 Додайте Unite.AI до бажаних джерел у Google
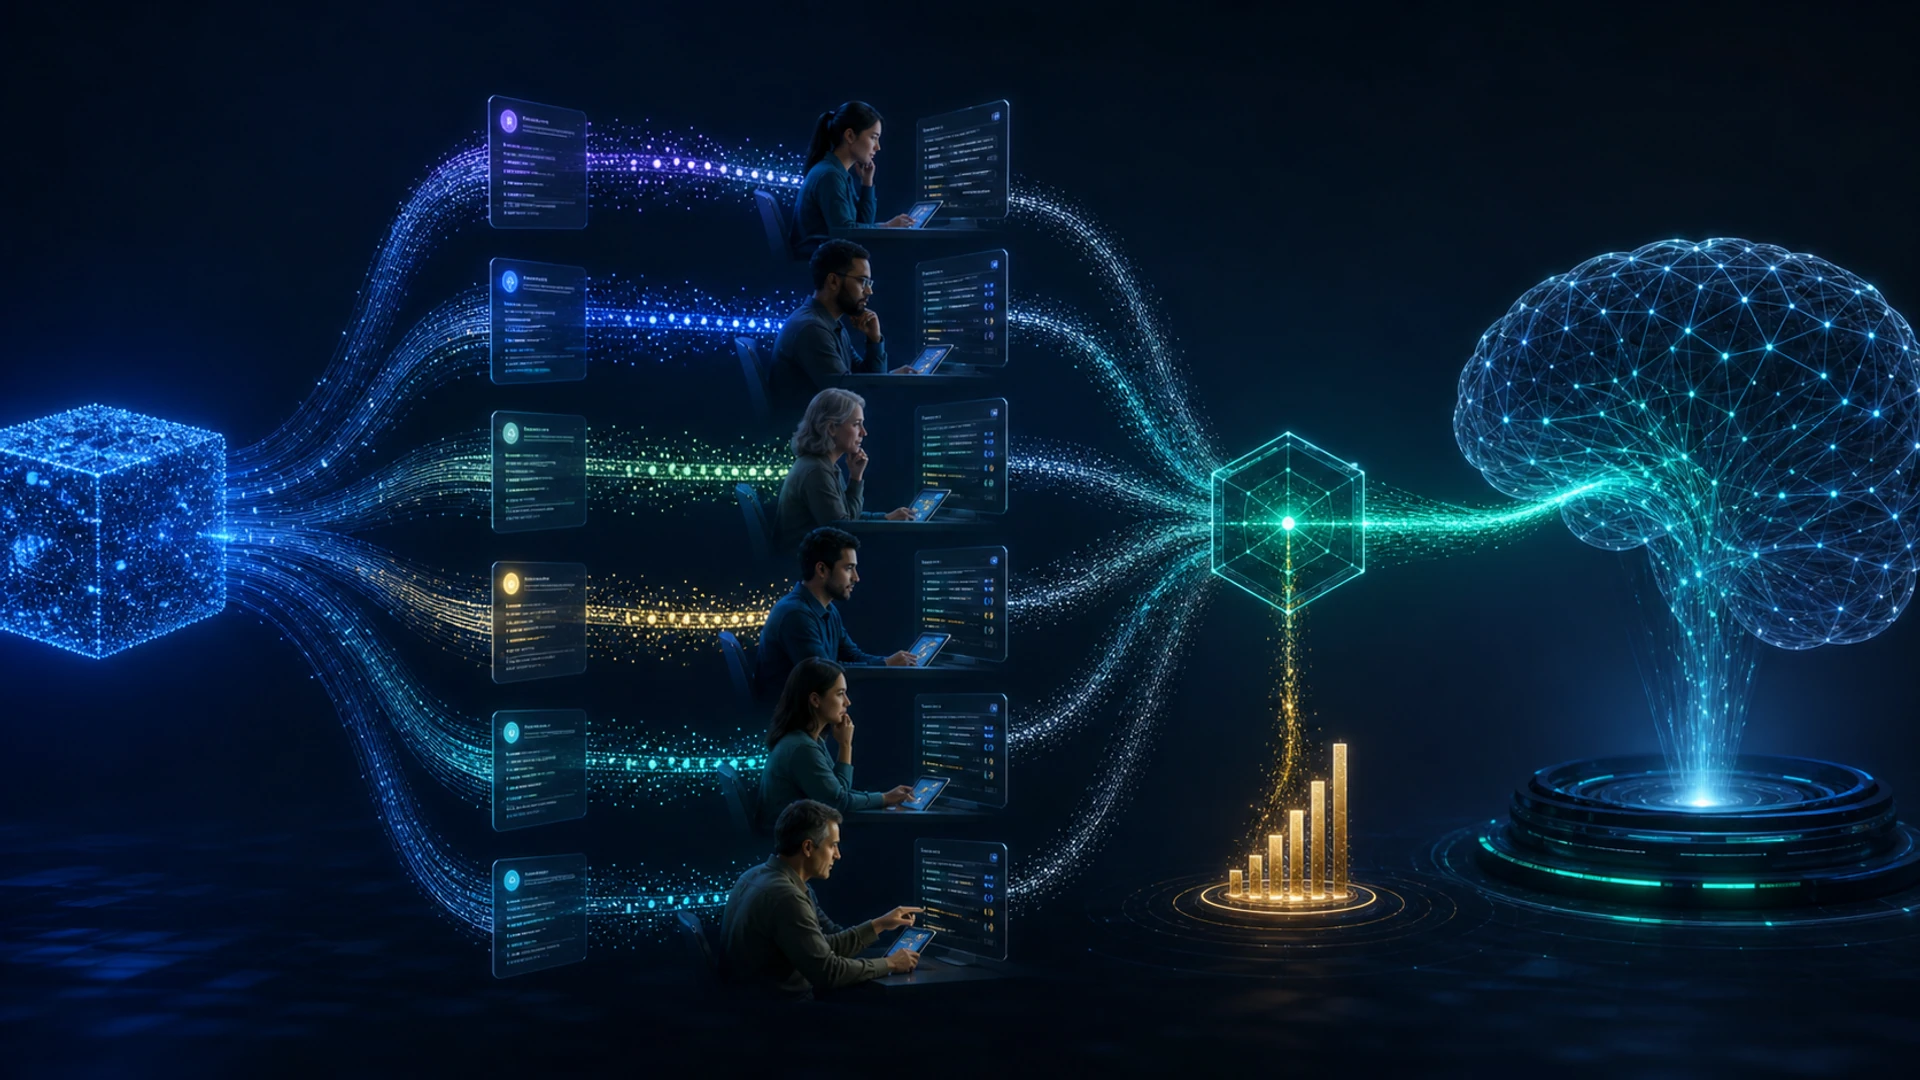
Підкріплювальне навчання за допомогою людського зворотного зв’язку (RLHF) — це сімейство методів, які використовують людські оцінки для оптимізації моделі, коли бажану поведінку важко визначити простим автоматичним винагородою. Для мовних моделей люди зазвичай порівнюють кандидатські відповіді, і навчена модель уподобань перетворює ці порівняння у навчальний сигнал.
RLHF може зробити попередньо навчену модель більш корисною або краще відповідною написаній політиці, проте це не гарантує правдивості чи узгодженості з кожним користувачем. Результат залежить від того, хто надає зворотний зв’язок, як вибираються підказки, що може представляти модель винагороди та як обмежується оптимізація.
Ключові висновки
- RLHF зазвичай слідує після передтренування та налаштування інструкцій під наглядом.
- Парні уподобання навчають модель винагороди або уподобань; оптимізація політики потім надає перевагу виходам з вищими оцінками.
- Хакерство винагороди, розбіжності анотаторів, зсув розподілу та надмірна оптимізація залишаються важливими ризиками.
- Оцінюйте остаточну політику безпосередньо за якістю завдання, безпекою, калібруванням та ефектами на підгрупи.
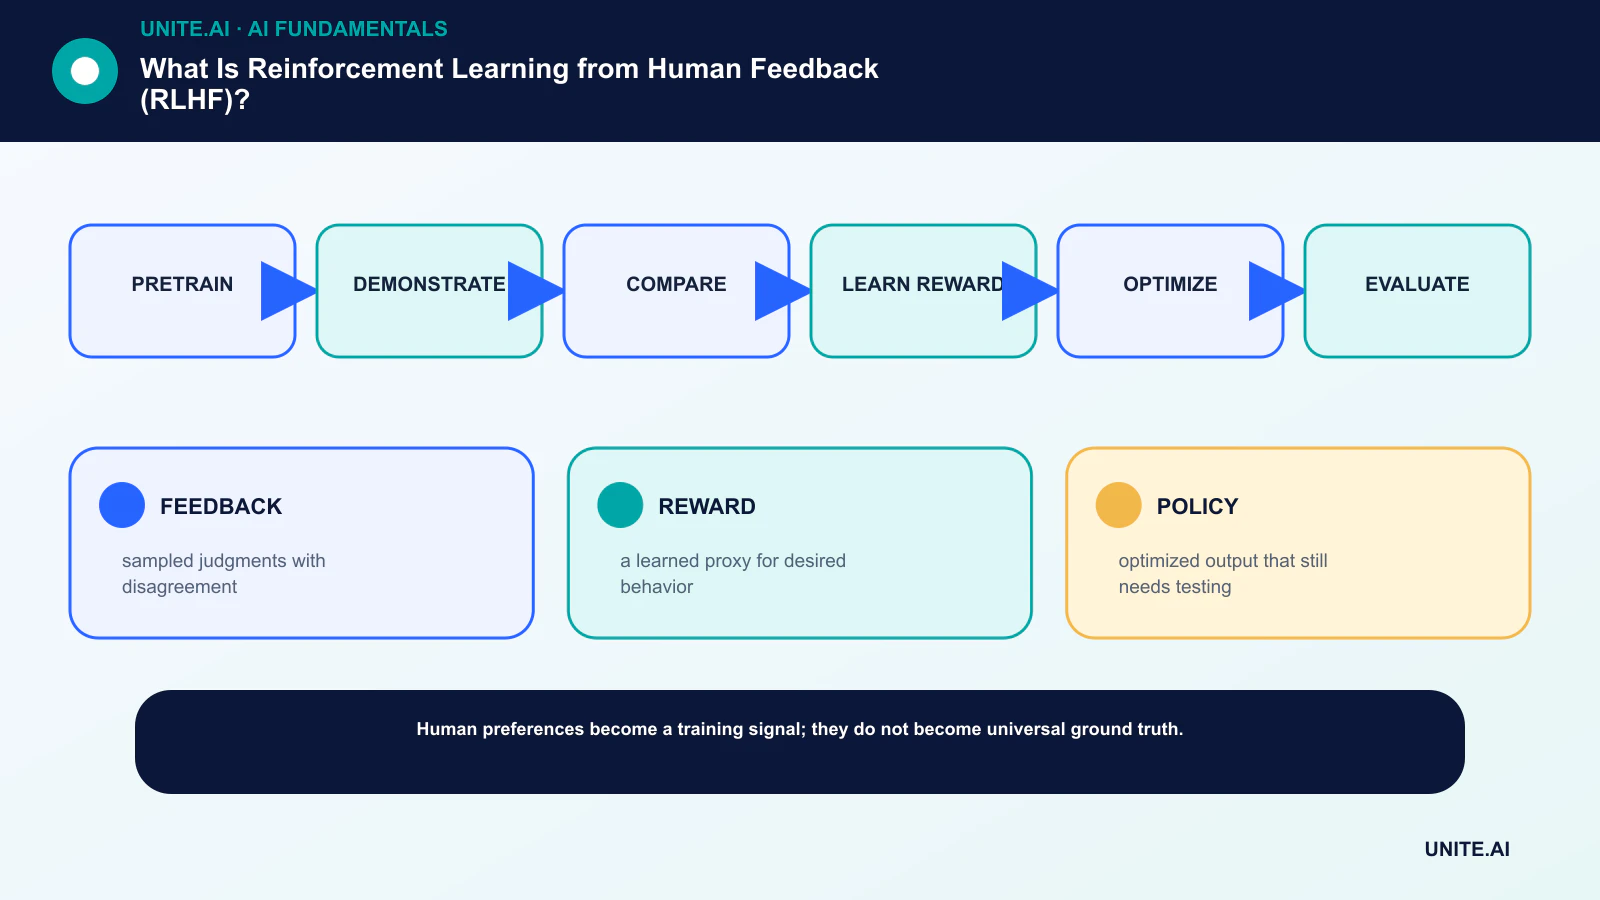
Загальний конвеєр RLHF
Мовна модель спочатку вивчає широку статистичну структуру під час передтренування. Після цього контрольоване донавчання використовує демонстрації бажаних відповідей. Для збору уподобань анотатори ранжують або вибирають між результатами за однаковою підказкою.
Модель винагороди навчається передбачати ці порівняння. Алгоритм підкріплювального навчання, такий як PPO, може оптимізувати мовну модель щодо цієї навченої винагороди, тоді як штраф запобігає надмірному відхиленню від референтної політики.
Зворотний зв’язок — це вимірювання, а не істина
Анотатори можуть не погоджуватись, оскільки інструкції неоднозначні, експертиза різна або цінності справді конфліктують. Позиція, багатослівність, впевненість та стиль можуть упереджувати уподобання. Якісна програма навчає оцінювачів, вимірює згоду, аудитує приклади та зберігає невизначеність.
Вибірка також має значення. Якщо набір уподобань виключає складні мови, домени або шкідливий контент, модель винагороди не зможе надійно їх контролювати. Дисципліна Data-science так само важлива, як і оптимізатор.
Режими відмов
Політика може використовувати слабкості навченої винагороди, генеруючи результати, які отримують високі оцінки, не задовольняючи первинний намір. Надмірна оптимізація може зменшити різноманітність, посилити переважний стиль або змусити модель впевнено погоджуватись.
Сама модель винагороди може давати збій поза межами розподілу навчальних даних. Команди повинні тестувати адверсаріальні підказки, фактичні завдання, межі відмов, калібрування та поведінку при різних рівнях оптимізації, а не покладатися лише на один агрегований відсоток перемоги уподобань.
Альтернативи та доповнення
Пряма оптимізація уподобань навчається на парах уподобань без створення окремої політики через онлайн‑цикл підкріплювального навчання. Відбір відхилень, контрольоване донавчання уподобань, зворотний зв’язок на основі правил та процесний контроль пропонують інші компроміси.
Жоден метод не усуває потребу у підказках, пошуку, інструментах та контролі на рівні застосунків. Післятренувальна фаза формує поведінку; розгорнуті системи все ще потребують обґрунтованих доказів, дозволів, моніторингу та ескалації до людей.
Як навчаються моделі уподобань
Для підказки x та двох відповідей y₁ і y₂ модель уподобань присвоює скалярні оцінки і навчається так, щоб переважна відповідь отримувала вищу оцінку. Поширена функція втрат базується на ймовірності, що одна оцінка перевищує іншу. Це перетворює багато парних суджень у функцію, яка може оцінювати новостворені результати.
Модель навчається на будь‑яких сигналах, які передбачають зібрані вибори. Якщо оцінювачі віддають перевагу впевненому стилю, довшим відповідям, певним культурним нормам або знайомим точкам зору, ці кореляції можуть стати ознаками винагороди. Збалансовані інструкції, контр‑приклади, експертна перевірка та аудити поверхневих уподобань зменшують, але не усувають проблему.
Дані уподобань можуть включати нічиї, ранжування, критики, скалярні мітки або демонстрації. Вибір пар важливий: порівняння між явно різними відповідями дають менше інформації про тонкі межі якості, тоді як лише складні пари можуть зробити навчання нестабільним. Активна вибірка може цілитися у інформативні розбіжності, але може змінити розподіл даних.
Оптимізація політики та регуляризація
RLHF на базі PPO вибирає відповіді поточної політики, оцінює їх за допомогою моделі винагороди та оновлює політику, щоб збільшити очікувану винагороду. Штраф Кульбака‑Лейблера або подібне обмеження тримає політику ближче до контрольованого референту, обмежуючи руйнівний дрейф і запобігаючи експлуатації вузьких слабкостей моделі винагороди.
Сила оптимізації — це вибір продукту. Надто мала залишає бажану поведінку незмінною; надто велика може призвести до хакерства винагороди, повторюваних формулювань, підхалимства або зменшення різноманітності. Під час навчання слід порівнювати якість та метрики безпеки з винагородою та відхиленням, а не обирати контрольну точку лише за винагородою.
Методи прямих уподобань виводять цільову функцію з пар уподобань та референтної моделі без явного онлайн‑циклу RL. Вони можуть спростити навчання, проте все ще успадковують якість уподобань, охоплення та припущення щодо референтної політики. Конституційний або штучно‑згенерований зворотний зв’язок змінює того, хто надає мітки; це не усуває потребу верифікувати цінності та помилки за участю людей.
Оцінка та управління даними
Використовуйте сліпі порівняння, тестування за конкретними завданнями, адверсаріальні підказки, перевірки фактичності, точність і повноту відмов, а також огляд підгруп. По можливості розділяйте оцінювачів від навчальних даних. Відсоток перемоги над старішою моделлю може приховувати абсолютні помилки, коли обидва кандидати погані.
Документуйте залучення анотаторів, їх компенсацію, експертизу, географію, мову, інструкції, вплив шкідливого контенту, розбіжності, арбітраж та контроль якості. Робота зі зворотним зв’язком може нести психологічний ризик, а відповідні операції з даними включають підтримку працівників та право відмовитися від тривожних завдань.
Після розгортання стежте за дрейфом уподобань та надмірною генералізацією. Політика, налаштована для випадкової допомоги, може поводитися погано в медичних чи юридичних контекстах. Тримайте межі доменів, пошук, дозволи та ескалацію поза припущенням RLHF і переобучайте лише тоді, коли нові докази виправдовують зміну.
Конкретний конвеєр навчання та оцінки RLHF
Типовий проєкт починається з попередньо натренованої мовної моделі та набору інструкцій, що використовується для контрольованого донавчання. Анотатори потім порівнюють кандидатські відповіді за допомогою письмової рубрики, що охоплює правильність, релевантність, стиль, безпеку та невизначеність. Парні уподобання навчають модель винагороди або безпосередньо оптимізують політику. Вибірка повинна включати звичайні завдання, складні граничні випадки, адверсаріальні підказки, кілька мов та області, у яких анотатори законно розходяться у думках.
Точність моделі винагороди на відкладених порівняннях є необхідною, але не достатньою. Оптимізована політика може експлуатувати помилки навченої винагороди, ставати надмірно багатослівною, відмовлятись від безпечних запитів або втрачати можливості. Слідкуйте за еталонами завдань, людськими уподобаннями, калібруванням, безпекою, різноманітністю та відхиленням від референтної моделі протягом навчання. Періодично збирайте нові порівняння від змінної політики, щоб дані уподобань охоплювали результати, які модель фактично генерує.
Документуйте, хто надавав уподобання, їх інструкції, компенсацію, розбіжності, контроль якості та культурні або доменні обмеження. Залучайте експертних рецензентів там, де помилки можуть мати спеціалізовану шкоду. Проводьте червону команду як для моделі винагороди, так і для остаточної політики, підтримуйте тести регресії поведінки та етапи розгортання. RLHF формує поведінку відповідно до виміряних уподобань; це не доводить правдивість, не усуває упередження і не вирішує ширшу проблему визначення того, що модель повинна робити у кожному контексті.
Практичний чек‑лист впровадження
Перетворіть концепцію у чіткий, тестований робочий процес: передтренування → демонстрація → порівняння → навчання винагороди → оптимізація → оцінка. Призначте відповідального, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії прийняття та зупинки, протестуйте типові відмови та визначте моніторинг, відкат і перегляд перед розширенням сфери. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності разом з людьми, які розробляють, експлуатують, захищають та на які впливає система. Тестуйте звичайні випадки, граничні умови, збої залежностей та зловживання; зберігайте докази та нерозв’язані ризики. Визначте, хто може схвалювати випуск, змінювати поріг, перевизначати результат або зупиняти роботу. Перегляньте рішення після надходження реальних даних, оскільки технічно успішний пілот не гарантує надійної роботи у масштабі.
- ЗВОРОТНИЙ ЗВ’ЯЗОК: вибіркові оцінки з розбіжностями.
- ВИНАГОРОДА: навчений проксі для бажаної поведінки.
- ПОЛІТИКА: оптимізований результат, який ще потребує тестування.
Часті запитання
Чи є RLHF тим же, що донавчання?
RLHF — це форма післятренування, яка використовує винагороди, отримані з уподобань. Контрольоване донавчання безпосередньо навчає на цільових виходах; багато конвеєрів використовують обидва підходи.
Чи робить RLHF модель правдивою?
Він може покращити поведінку, виміряну процесом зворотного зв’язку, проте модель все ще може бути неправильною, переконливою або стратегічно експлуатувати винагороду. Правдивість потребує прямої оцінки та обґрунтування.
Основні джерела