Основи ШІ
Що таке ІТ-операції (ITOps)?

 Додайте Unite.AI до бажаних джерел у Google
IT operations (ITOps) — це робота з управління технологічними сервісами, від яких залежить організація. Вона охоплює обчислення, мережі, ідентифікацію, кінцеві пристрої, хмарні платформи, бази даних, сховища, резервні копії та операційні процеси, які забезпечують доступність, безпеку та підтримуваність цих компонентів.
Сучасні ITOps не обмежуються лише центром мережевих операцій, що стежить за панелями інструментів. Команди все більше керують програмно‑визначеною інфраструктурою, сервісами платформ, автоматизацією та розподіленою власністю, залишаючись відповідальними за інциденти, ємність, безперервність та рівні сервісу.
Ключові висновки
- ITOps керує сервісами та їх залежностями в локальних, хмарних та крайових середовищах.
- Спостережуваність, конфігурація та інвентаризація забезпечують контекст, необхідний для інтерпретації збоїв.
- Управління інцидентами відновлює сервіс; управління проблемами вирішує повторювані або системні причини.
- ITOps перетинається з ITSM, SRE, DevOps, SecOps та AIOps, але не ідентичний жодному з них.
Сервіси, активи та конфігурація
Операції починаються з розуміння, які сервіси існують, хто їх власник, які користувачі залежать від них і яка інфраструктура їх підтримує. Інвентаризація активів фіксує компоненти; управління конфігурацією реєструє відповідні взаємозв’язки та контрольований стан.
Інвентар, який ніколи не узгоджується, стає оманливим. Автоматизуйте виявлення там, де це корисно, визначайте авторитетні джерела та фіксуйте рівень впевненості або актуальність, замість того щоб вдавати, що кожна карта залежностей повна.
Спостережуваність та цілі сервісу
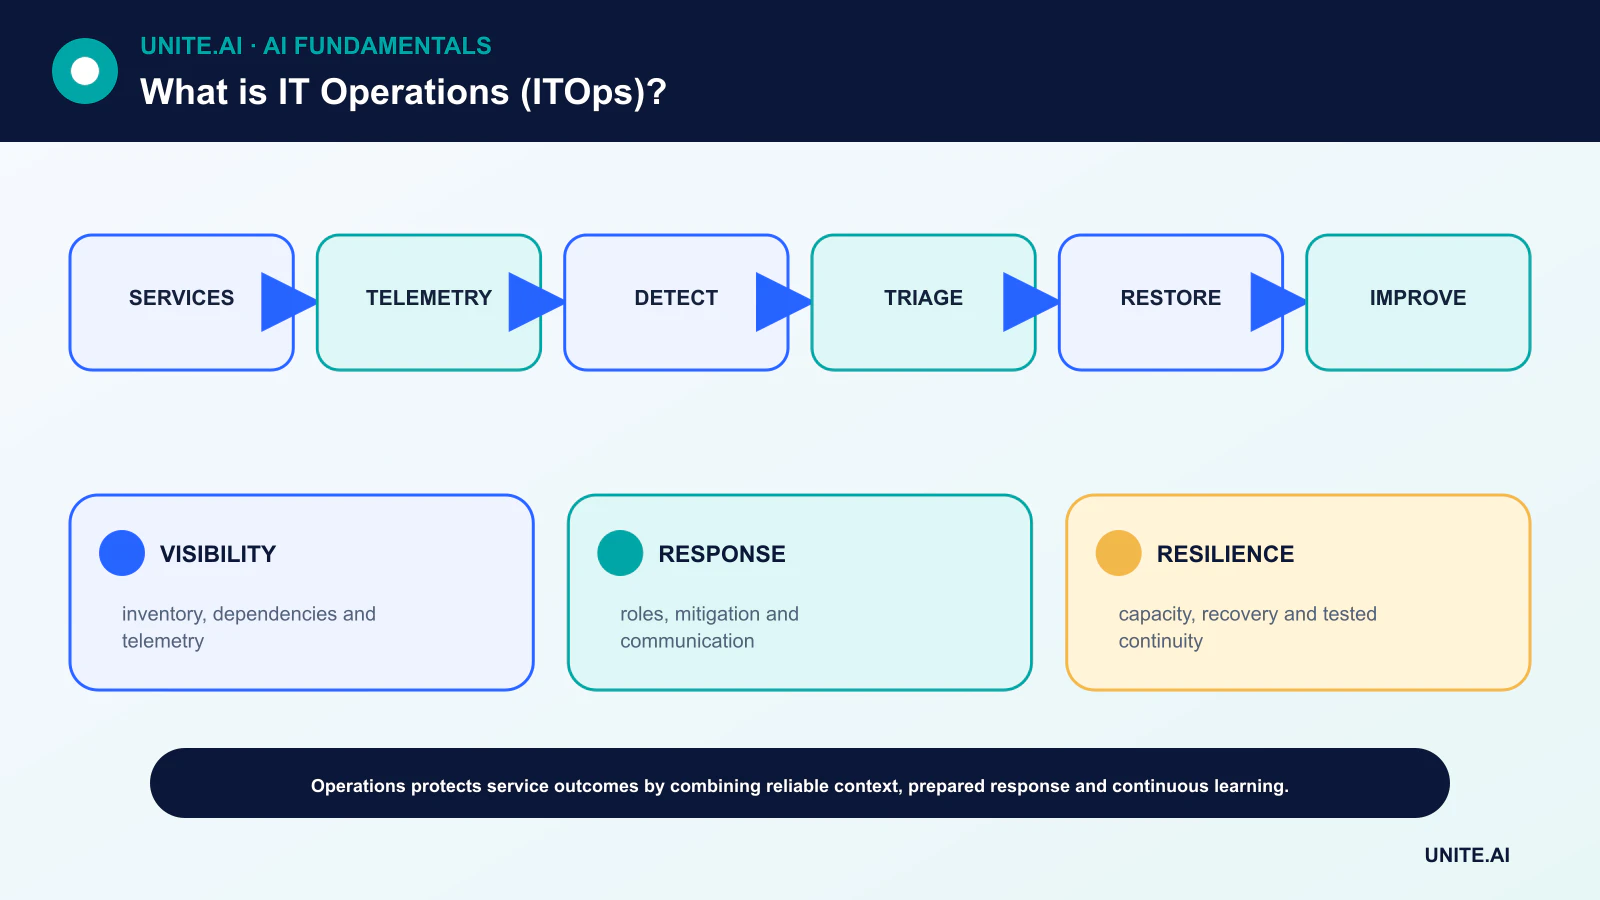
Метрики кількісно описують поведінку, журнали реєструють події, а трасування слідує за роботою між сервісами. Синтетичні перевірки можуть тестувати шлях користувача. Корисна спостережуваність починається з питань та цілей сервісу, після чого збирає сигнали, необхідні для їх відповіді.
Система сповіщень повинна виявляти умови, які потребують своєчасних дій. Пороги без впливу на користувачів створюють шум, а відсутність контексту залежностей уповільнює діагностику. AIOps може допомогти у кореляції, проте їй потрібна достовірна телеметрія та операційний зворотний зв’язок.
Управління інцидентами, проблемами та змінами
Управління інцидентами координує виявлення, триаж, пом’якшення, комунікацію та відновлення. Чіткі ролі зменшують плутанину під тиском. Тимчасове обходне рішення може відновити сервіс, поки подальше розслідування проблеми вирішує глибші причини.
Управління змінами оцінює та фіксує ризики, не перетворюючи кожну зміну у чергу. Стандартні, автоматизовані та низькоризикові зміни можуть слідувати попередньо затвердженим шляхам; зміни з великим впливом вимагають більшої доказовості, планування та підготовки відкату.
Ємність, стійкість та безперервність
Команди прогнозують попит на ресурси, усувають вузькі місця та тестують поведінку під навантаженням. Резервні копії корисні лише тоді, коли тестується їх відновлення. Надмірність допомагає лише тоді, коли режими відмови незалежні і переключення справді працює.
Безперервність бізнесу визначає пріоритети, час відновлення та допустиму втрату даних. Залежності від ідентифікації, DNS, хмарних контрольних площин та постачальників мають бути включені в вправи, а не вважатися доступними.
ITOps, ITSM, SRE та DevOps
Управління ІТ‑сервісами (ITSM) надає процеси для узгодження сервісів з потребами організації. Інженерія надійності сайту (SRE) застосовує програмну інженерію до операцій і використовує цілі рівня сервісу та бюджети помилок. DevOps об’єднує зворотний зв’язок розробки та операцій.
SecOps зосереджується на загрозах та реагуванні, тоді як ITOps підтримує ширшу здоров’я сервісу. Організаційні схеми різняться; важливою вимогою є чітка власність та спільні докази між цими дисциплінами.
Операційна модель ITOps
ІТ‑операції підтримують технологічні сервіси організації доступними, продуктивними, безпечними та відновлюваними. Обсяг зазвичай включає кінцеві пристрої, ідентифікацію, мережі, сервери, хмари, сховища, співпрацю, бази даних, моніторинг, службу підтримки, резервне копіювання та сервіси постачальників. Сучасні ITOps охоплюють власну інфраструктуру та керовані платформи, тому відповідальність має бути чіткою, навіть коли операції аутсорсингуються. Конфігурація або інвентаризація сервісів пов’язує технічні компоненти з власниками, користувачами, залежностями, класифікацією даних та критичністю для бізнесу.
Управління сервісами організує інциденти, запити, проблеми, зміни, активи, знання та рівні сервісу. Управління інцидентами відновлює сервіс; управління проблемами розслідує повторювані причини; впровадження змін оцінює та координує ризики. Ставлення кожної зміни до повільного затвердження створює обходи, тоді як неконтрольована автоматизація призводить до некерованих збоїв. Стандартні низькоризикові зміни можуть бути попередньо затверджені та автоматизовані; високоризикові зміни потребують доказів, комунікації, відкату та планування згідно з впливом.
Надійність, ємність та безперервність
Моніторинг має орієнтуватися на користувацькі сервіси та їх залежності, а не лише на кількість пристроїв. Визначайте доступність, затримку, ємність, актуальність та цілі підтримки разом з бізнес‑власниками. Сповіщайте про практичні симптоми та споживання бюджету помилок; збагачуйте події інформацією про власника та недавні зміни. Моделі планування ємності враховують попит, насичення, ліцензії та час підготовки. Еластичність хмари зменшує затримку у забезпеченні, але не усуває квоти, регіональні обмеження чи контроль витрат.
Безперервність бізнесу вимагає протестованих резервних копій, відновлення, відновлення ідентифікації, альтернативних мереж, контактів з постачальниками та ручних процедур. Визначайте цілі часу відновлення (RTO) та точки відновлення (RPO) для кожного сервісу. Резервна копія не є доказом відновлення, доки вона не відновлена та не підтверджена. Тренуйте сценарії викупу (ransomware), втрати регіону, прострочених сертифікатів, відключення ідентифікації та відмови постачальника. За можливості відстежуйте конфігурацію та інфраструктуру як код, щоб відновлення було відтворюваним.
Безпека, автоматизація та метрики
Використовуйте принцип найменших привілеїв, управління патчами та вразливостями, контроль кінцевих пристроїв, сегментацію мереж, журналювання та реагування на інциденти. Автоматизуйте повторювану роботу з ідемпотентністю, обмеженнями, затвердженнями та аудитом. Вимірюйте доступність сервісу, повторюваність інцидентів, виконання запитів, невдачі змін, відновлення, вплив патчів, ємність, витрати та задоволеність користувачів — а не лише закриття тикетів. ITOps успішний, коли технології передбачувано підтримують роботу та можуть відновитися після збою, а не коли інфраструктура виглядає зайнятою або панелі інструментів мають багато зелених індикаторів.
Практичний приклад: відновлення сервісу співпраці
Компанія визначає ціль часу відновлення у чотири години та ціль точки відновлення у одну годину для платформи співпраці. Вона інвентаризує ідентифікацію, DNS, мережу, дані, ключі, конфігурацію, інтеграції та залежності від постачальників. У вправі з відновлення передбачається, що основний регіон та обліковий запис адміністратора недоступні. Оператори активують незалежно захищену аварійну ідентифікацію, відновлюють конфігурацію сервісу та дані в ізольованому регіоні та перевіряють дозволи, повідомлення, інтеграції та доступ клієнтів. Власники бізнесу перевіряють відновлений сервіс за допомогою реалістичних шляхів користувачів, а не лише спираються на перевірки стану інфраструктури.
Вправа фіксує фактичну втрату даних, витрачений час, ручні кроки, невдалі контакти та приховані залежності. Резервна копія, яка відновлює файли, але не ключі шифрування або політику ідентифікації, позначається як неповна. Коригувальні дії отримують власників та дати, а посібник оновлюється та повторно тестується. Включені шаблони моніторингу та комунікації. Організація вимірює докази відновлення, а не успішність завдання резервного копіювання, розуміючи, що надійний ITOps має відновлювати сервіс, який потрібен користувачам, у реалістичних умовах збою.
Докази впровадження та готовність до експлуатації
Вирішення щодо впровадження в продуктивне середовище потребує більше, ніж успішна демонстрація. Визначте цільових користувачів, операційне середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої несправності. Встановіть відтворювану базову лінію та версіонований набір оцінки перед налаштуванням. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відключення залежностей, неправильне використання та групи або середовища, які найчастіше залишаються без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожну трансформацію та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, винятки, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, збережіть безпечний резерв та перевірте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має розкривати якість вводу, поведінку виходу, версію моделі або правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переглядайте знову, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, апаратне забезпечення або цілі. Підтримувана система також потребує задокументованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткого моменту, коли її слід вимкнути або замінити.
Поширені запитання
Яка основна мета ITOps?
Надавати та відновлювати надійні технологічні сервіси в межах узгоджених обмежень безпеки, продуктивності, безперервності та вартості.
Чи управляється хмарна інфраструктура повністю провайдером хмари?
Ні. Провайдери керують лише частинами базової платформи, тоді як клієнти залишаються відповідальними за конфігурацію, ідентифікацію, дані, робочі навантаження, моніторинг та багато рішень на рівні сервісу.
Основні джерела