
Основи ШІ
Що таке автоматизація інцидентів? Робочі процеси, обмежувальні механізми та випадки використання

 Додайте Unite.AI до бажаних джерел у Google
Автоматизація інцидентів використовує програмне забезпечення для виявлення, збагачення, маршрутизації, координації та іноді усунення операційних або безпекових інцидентів. Вона з’єднує сигнали моніторингу з інструкціями (runbooks), системами тікетування, комунікацією, контролем доступу та діями відновлення, щоб реагувальники витрачали менше часу на копіювання даних і більше часу на прийняття рішень.
Автоматизація не означає усунення людської відповідальності. Безпечна програма розрізняє низькоризикові детерміністичні кроки від дій, які можуть вплинути на клієнтів або продуктивність, і застосовує схвалення, обмежені облікові дані, аудиторські журнали, тайм‑ауты та відкат відповідно до впливу.
Основні висновки
- Автоматизуйте повторюване збір доказів перед спробою автономного усунення.
- Використовуйте серйозність, впевненість, радіус ураження та можливість відкату для вибору рівня схвалення.
- Ставте кожну інструкцію (runbook) у статус версійованого коду продуктивного середовища з тестами та власником.
- Вимірюйте виявлення, підтвердження, відновлення, повторення та вплив на користувачів — а не лише обсяг сповіщень.
Від сигналу до координованої реакції
Робочий процес може дедуплікувати сповіщення, приєднувати останні розгортання та журнали, визначати власника сервісу, відкривати запис інциденту, викликати чергову команду, створювати канал комунікації та запускати хронологію. Ці кроки знижують когнітивне навантаження без автоматичного проведення ризикованої діагностики.
Кореляція повинна зберігати докази. Якщо платформа надмірно агресивно групує симптоми, це може приховати одночасні інциденти. Пов’яжіть автоматизацію з власністю IT‑операцій і зберігайте необроблені сигнали, які можуть знадобитися реагувальникам.
Вибір дій за ризиком
Запити лише для читання, знімки та оборотні перенаправлення трафіку, як правило, простіше автоматизувати, ніж видалення даних, обертання широких облікових даних або зміна схеми у продакшн‑середовищі. Визначте передумови, тайм‑аут виконання, постумови та відкат для кожної дії.
Використовуйте ідентифікатори сервісів з найменшими привілеями та розділяйте авторизацію від рушійної частини робочого процесу. Кроки з великим впливом мають вимагати визначеного затверджувача. Якщо AIOps пропонує причину або виправлення, реагувальникам все одно потрібні підтверджуючі докази та безпечний спосіб відхилити його.
Створення надійних інструкцій
Інструкція (runbook) повинна описувати вхідні дані, залежності, власника, область, поведінку при збоях та створювані докази. Протестуйте її у середовищі підготовки та під час імітаційних днів. Ідемпотентні кроки цінні, оскільки їх повторне виконання не завдає додаткової шкоди.
Версіонуйте та переглядайте автоматизацію, як інше програмне забезпечення. Слідкуйте за закінченням терміну облікових даних, змінами API, обмеженнями швидкості, частковим виконанням та прихованими зв’язками між сервісами. Ручні процедури залишаються необхідними, коли сама платформа автоматизації недоступна.
Навчання після відновлення
Автоматизація має зберігати часово‑мічену запис про сигнали, рішення, дії, схвалення та результати. Безвиновний огляд може тоді розрізнити умови, що сприяли інциденту, від фінального тригера та перетворити уроки у протестовані вдосконалення.
Корисними метриками є середній час підтвердження та відновлення, відсоток безпечних кроків, автоматизованих, рівень невдалих дій, повторні інциденти та вплив на клієнтів. Поєднайте результати з плануванням DevOps, а не оптимізуйте лише кількість закритих тікетів.
Типи автоматизації інцидентів
Автоматизація подій нормалізує та збагачує вхідні сигнали. Автоматизація координації створює запис інциденту, викликає власників, відкриває канали комунікації та публікує оновлення статусу. Діагностична автоматизація виконує запити лише для читання або створює знімки. Автоматизація усунення змінює стан системи, тоді як автоматизація відновлення перевіряє здоров’я сервісу та закриває тимчасові заходи.
Ці категорії не повинні мати спільного рівня довіри за замовчуванням. Збагачення часто може виконуватись автоматично; перехід у продакшн може вимагати перевірки впевненості та затверджувача; відновлення даних зазвичай потребує командира інциденту та власника застосунку. Керування має базуватись на потенційному впливі, а не на тому, чи крок реалізовано правилом або моделлю машинного навчання.
Інциденти безпеки додають вимоги щодо збереження доказів. Автоматизація має уникати модифікації скомпрометованого хоста до того, як буде зафіксовано волатильні дані, розкриття чутливих індикаторів у публічних каналах або карантину спільної інфраструктури без розуміння радіуса ураження. Операційні та судово‑медичні інструкції можуть перекриватися, проте їх порядок може відрізнятись.
Проєктування робочих процесів та контрольна площина
Моделюйте інструкцію як явні стани з передумовами та кінцевими результатами. Кожна дія має повідомляти про початок, успішне завершення, помилку, тайм‑аут або пропуск разом з незмінним ідентифікатором виконання. Центральний оркестратор може координувати кроки, проте нижчепоточні сервіси повинні самостійно забезпечувати авторизацію та незалежно валідовувати вхідні дані.
Використовуйте обмежені, короткоживучі облікові дані та обмежуйте мережеві шляхи від двигуна автоматизації. Розділяйте середовища розробки, тестування та продакшн. Секрети не повинні з’являтися у чат‑транскриптах або журналах. Для дій з великим впливом вимагайте схвалення двох осіб або ролі «break‑glass», використання якої створює негайний аудиторський слід.
Проектуйте з урахуванням часткових збоїв. Тікет може бути створений, коли виклик чергової команди не вдається; перенаправлення трафіку може успішно завершитись в одному регіоні і вийти з тайм‑ауту в іншому. Компенсаційні дії, процеси узгодження та чітка відповідальність запобігають тому, щоб робочий процес повідомляв про успіх лише через завершення оркестрації.
Приклади, тестування та зрілість
Зрілій перший приклад використання – вичерпання з’єднань бази даних: збір метрик пулу, останніх розгортань, повільних запитів та інформації про власника; відкриття інциденту; пропозиція оборотного масштабування або дії з трафіком; вимога схвалення; потім перевірка рівня помилок та затримки. Така ж схема підходить для прострочення сертифікатів, тиску на диск, невдалих завдань або підозрілої активності облікових записів.
Тестуйте інструкції за допомогою юніт‑тестів, мок‑апі, інцидентів у підготовчому середовищі, імітаційних днів та контрольованих виробничих тренувань. Вводьте застарілі дані, відмови в дозволах, повільні залежності, дублюючі події та конфліктні інциденти. Підтвердіть, що повторні спроби безпечні і реагувальники можуть взяти ручний контроль без протидії автоматизації.
Зрілість розвивається від сповіщення до збагачення, до керованих дій та обмеженого авто‑усунення. Просування має залежати від доказів: стабільна діагностика, низький рівень невдалих дій, підтверджений відкат і чітка користувацька вигода. Автономне закриття має бути рідкісним, доки система не зможе довести успішне відновлення та зберегти достатньо доказів для подальшого навчання.
Практичний приклад: автоматизація інциденту у виробничому сервісі
Розглянемо платіжний API, у якого після розгортання зростає рівень помилок. Моніторинг генерує структуроване сповіщення, що містить сервіс, середовище, регіон, версію, бюджет помилок і посилання на інструкцію. Автоматизація збагачує його записом змін, станом залежностей, останніми журналами та інформацією про власника, а потім групує дублікати сповіщень в один інцидент. Детерміністична політика може негайно призупинити подальший реліз; відкат має вимагати доказів того, що нова версія є причиною, і що відкат безпечний.
Робочий процес призначає командира інциденту, відкриває канали комунікації, записує хронологію та пропонує діагностичні кроки. Автоматизоване усунення починається з низькоризикових оборотних дій, наприклад, перенаправлення трафіку на здоровий інстанс. Кожна дія потребує авторизації, обмежень одночасності, тайм‑ауту, перевірених постумов та відкату. Генеративні резюме можуть допомогти реагувальникам, проте первинна телеметрія та команди залишаються видимими, щоб команда могла спростувати неправильний наратив.
Вимірюйте час виявлення, підтвердження, пом’якшення та відновлення; обсяг сповіщень; подавлення дублікатів; успішність усунення; повторюваність; та шкоду, спричинену автоматизацією. Проводьте імітаційні дні для прострочених облікових даних, часткових регіонів, вводячих в оману сповіщень та невдалих відкатів. Після відновлення зберігайте фактичну хронологію, визначайте технічні та організаційні умови, що сприяли, оновлюйте інструкції та тести, і відстежуйте виконання коригувальних робіт до завершення, а не розглядайте швидке пом’якшення як кінець роботи над надійністю.
Практичний чек‑лист впровадження
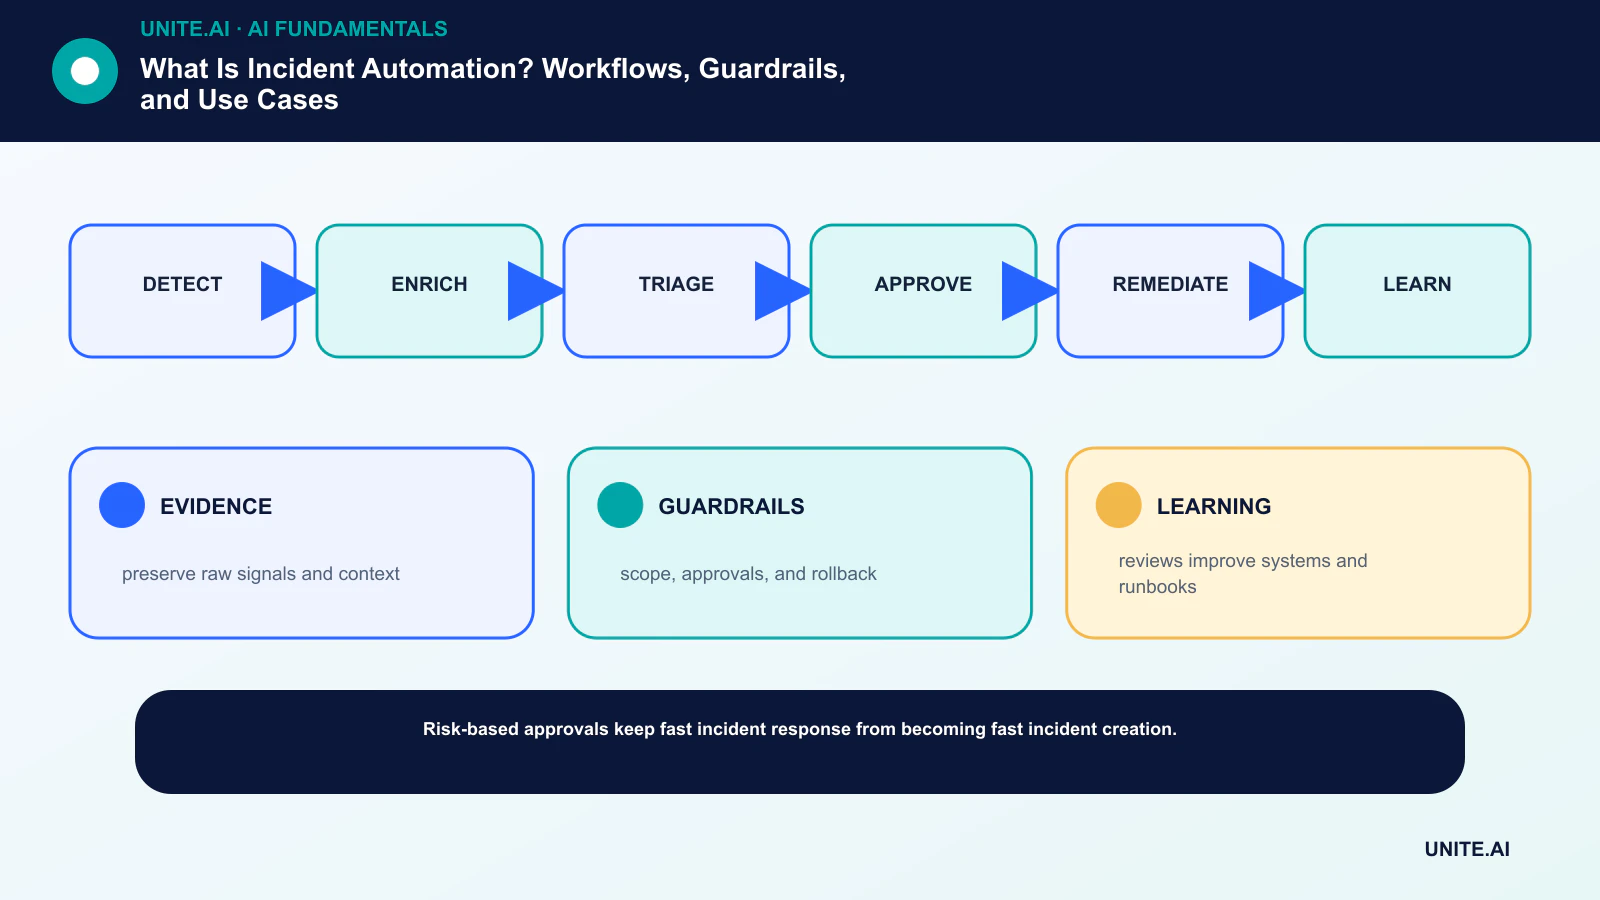
Перетворіть концепцію у обмежений, тестований робочий процес: виявлення → збагачення → триаж → схвалення → усунення → навчання. Призначте відповідального власника, задокументуйте дані та залежності, встановіть просту базову лінію, визначте критерії прийняття та зупинки, протестуйте представницькі збої та визначте моніторинг, відкат і огляд перед розширенням сфери. Фіксуйте версії та припущення, щоб інша команда могла відтворити результат і зрозуміти, що змінилося.
Перед запуском проведіть задокументований огляд готовності разом з людьми, які розробляють, експлуатують, забезпечують безпеку та постраждають від системи. Тестуйте звичайні випадки, граничні умови, збої залежностей та зловживання; зберігайте докази та нерозв’язані ризики. Визначте, хто може схвалювати випуск, змінювати поріг, переопреділяти результат або зупиняти роботу. Перегляньте рішення після отримання реальних даних, оскільки технічно успішний пілот не гарантує надійної роботи у більшому масштабі.
- EVIDENCE: зберігати необроблені сигнали та контекст.
- GUARDRAILS: область, схвалення та відкат.
- LEARNING: огляди покращують системи та інструкції.
Поширені запитання
Чи є автоматизація інцидентів тим же, що AIOps?
Ні. AIOps застосовує аналітику або машинне навчання до даних операцій. Автоматизація інцидентів – це ширший рівень виконання та координації; вона може використовувати прості правила, результати AIOps або обидва варіанти.
Що слід автоматизувати в першу чергу?
Почніть з високочастотних, низькоризикових, добре зрозумілих кроків, таких як збагачення, пошук власника, збір доказів, оновлення статусу та оборотна діагностика.
Основні джерела











