
Основи ШІ
Генеративні проти дискримінативних моделей машинного навчання

 Додайте Unite.AI до бажаних джерел у Google
Генеративна і дискримінативна описують, що модель вивчає про дані та цільові змінні. У класичній контрольованій класифікації генеративна модель навчає спільний розподіл, наприклад P(x, y) або умовний за класом P(x|y), тоді як дискримінативна модель навчає P(y|x) або пряму межу рішення.
Різниця корисна, проте сучасні системи часто поєднують цілі. Модель може навчитися генеративним представленням, а потім доопрацюватися для дискримінативного передбачення, або спільно використовувати одну основу для генерації та класифікації.
Ключові висновки
- Генеративні класифікатори моделюють, як виникають вхідні дані та мітки; дискримінативні класифікатори моделюють мітку за даними або межу.
- Генеративні припущення можуть допомогти при обмеженій кількості мічених даних, але можуть бути й помилковими.
- Дискримінативні методи часто зосереджують потужність на завданні передбачення і можуть досягати кращої асимптотичної похибки класифікації.
- GAN‑и, VAE‑и та мовні моделі є генеративними системами, проте «генеративний» не означає, що кожен компонент є генеративним класифікатором.
Факторизація ймовірності
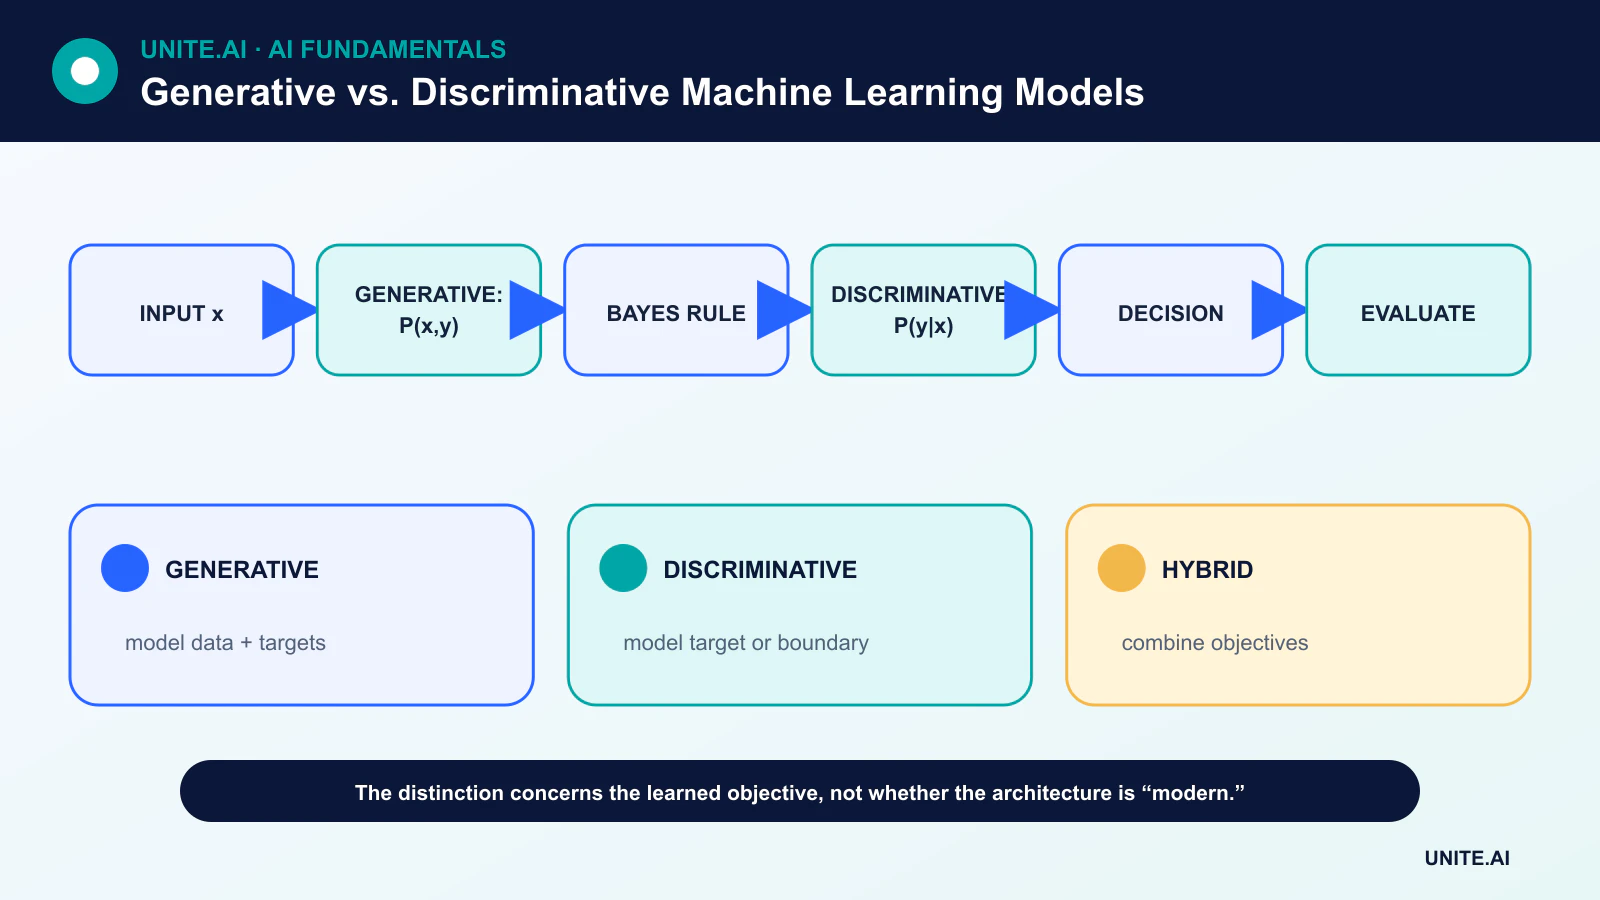
Генеративний класифікатор може оцінювати P(x|y) та P(y), а потім використовувати Теорему Байєса для отримання P(y|x). Наївний Байєс — класичний приклад. Дискримінативний класифікатор, такий як логістична регресія, оцінює P(y|x) безпосередньо; SVM навчає розділяючу межу.
Моделювання P(x,y) — це ширше завдання, ніж передбачення y за x. Додаткова структура може підтримувати генерацію зразків або розуміння відсутніх даних, проте вона також вимагає припущень щодо розподілу вхідних даних.
Ефективність даних та асимптотична поведінка
Порівняння Наївного Байєса та логістичної регресії, проведене Нґ та Джорданом, продемонструвало корисний компроміс: за їхніх припущень генеративна модель може досягти своєї граничної продуктивності з меншою кількістю прикладів, тоді як дискримінативна модель може отримати нижчу асимптотичну похибку.
Це не універсальне ранжування. Результати залежать від того, чи підходить сімейство моделей до даних, від розмірності, регуляризації, оптимізації та якості міток. Емпіричне порівняння на репрезентативному валідаційному дизайні залишається необхідним.
Представницькі сімейства моделей
Генеративні моделі включають умовні за класом розподіли, моделі прихованих марковських процесів, моделі суміші, варіаційні автокодери, авторегресивні мовні моделі, дифузійні моделі та GAN‑и.
Дискримінативні моделі включають логістичну регресію, дерева рішень, умовні випадкові поля, машини опорних векторів та нейронні класифікатори. Та сама нейронна основа може належати до будь‑якої категорії залежно від цілі навчання та виходу.
Гібридні та самонавчальні системи
Попередньо навчену мовну або візуальну модель можна навчати на немічених даних за допомогою генеративної або самонавчальної мети, а потім додати дискримінативну голову для цільового завдання. Методики напівконтрольованого навчання можуть одночасно оптимізувати мічену класифікацію та мету на немічених даних.
Гібридизація робить мітки архітектури менш інформативними, ніж весь конвеєр навчання. Документація повинна вказувати мету, дані, виходи та передбачуване використання — а не просто називати модель генеративною.
Вибір підходу
Вибирайте, орієнтуючись на завдання. Якщо мета — калібрована межа при великій кількості міток, дискримінативна модель є природною базовою лінією. Якщо важливі генерація зразків, оцінка густини, структура відсутніх даних або немічені дані, генеративний компонент може допомогти.
Порівнюйте стійкість, ефективність використання зразків, обчислювальні ресурси, правдоподібність або калібрування за потребою. Якісний згенерований зразок не доводить якість класифікатора, а високоточний класифікатор не означає реалістичну модель розподілу вхідних даних.
Напрямки ймовірності та цілі моделювання
Дискримінативна модель навчає межу або умовний розподіл P(y|x): за даними ознак x передбачає мітку y. Логістична регресія, машини опорних векторів, умовні випадкові поля та багато інших класифікаторів є дискримінативними. Генеративна модель навчає спільний розподіл P(x,y), умовний за класом розподіл P(x|y) або безумовний розподіл даних, що дозволяє генерувати зразки або виконувати задачі, пов’язані з правдоподібністю. Наївний Байєс та лінійний дискримінантний аналіз — це генеративні класифікатори; GAN‑и, варіаційні автокодери, дифузійні моделі та авторегресивні моделі генерують дані за різними цілями.
Різниця стосується того, який розподіл або правило прийняття рішень моделюється, а не того, чи використовується нейронна мережа. Генеративну мовну модель можна підказати для класифікації, тоді як дискримінативний повторний ранжер може керувати генерацією. Генеративні припущення можуть підвищити ефективність даних або обробляти відсутні змінні, але створюють ризик неправильного моделювання. Дискримінативні методи часто переважають при великій кількості мічених даних, оскільки вони безпосередньо зосереджуються на межі передбачення. Порівнюйте сімейства за однакових ознак, даних, налаштувань та обчислювальних ресурсів, а не розглядайте одну категорію як універсально кращу.
Навчання та оцінка за випадком використання
Оцінка класифікації використовує точність, повноту, калібрування, стійкість та вартість помилки. Оцінка генеративних моделей має охоплювати достовірність, різноманітність, охоплення, правдоподібність або корисність для завдання, запам’ятовування та безпеку. Модель може створювати привабливі зразки, втрачаючи частини розподілу, або досягати високої правдоподібності при поганій сприйманій якості. Корисність синтетичних даних слід перевіряти, навчаючи та оцінюючи підлеглі моделі на незалежних реальних даних, включаючи рідкісні групи. Тестові дані не повинні потрапляти у підказки генерації та відбір.
У напівавтоматичному навчанні генеративна модель може використовувати структуру немічених даних; у виявленні аномалій правдоподібність може провалитися, коли дані поза розподілом отримують високу густину з нерелевантних причин. У генерації з підкріпленням пошуку генеративна модель відповіді та дискримінативний пошуковик або повторний ранжер утворюють гібрид. Діагностуйте етапи окремо, щоб бездоганний вихід не приховував помилку пошуку. Обирайте розподіл, який робить докази та контроль видимими.
Розгортання та управління
Генеративні системи додають ризики походження контенту, інтелектуальної власності, підробки, ін’єкції підказок та модерації виходу; дискримінативні системи додають ризики порогу, відмови та нерівних помилок. Обидві потребують прав на дані, захищених артефактів, версіонування, репрезентативних тестів, моніторинг та людської влади, пропорційної наслідкам. Фіксуйте точну мету та семантику виходу у документації. Генеративне проти дискримінативного — корисна статистична різниця, проте реальні системи часто їх поєднують, і надійність залежить від усього конвеєра даних та рішень.
Практичний приклад: класифікація та генерація відповідей підтримки
Платформа підтримки використовує дискримінативний класифікатор для визначення типу проблеми та терміновості, а генеративну модель — для чернетки відповіді згідно затверджених політик. Класифікатор оцінюється за допомогою клас-специфічної повноти та калібрування; пошуковик — за повнотою доказів; генератор — за обґрунтованістю, правильністю та відмовою. Кожен етап має невідомий результат, і генеративна модель не може змінити класифікацію чи права клієнта за допомогою переконливого тексту.
Агенти бачать передбачений маршрут, джерела та чернетку, а потім затверджують або виправляють її перед відправкою. Фільтри дозволів застосовуються до пошуку, і ін’єкція підказок у тексті клієнта не може уповноважити інструменти. Моніторинг розділяє помилки маршрутизації, прогалини пошуку, непідтримувані твердження та правки агентів. Зміна політики оновлює джерела миттєво та запускає регресійні тести; налаштування залишаються для стабільної поведінки. Гібридний дизайн використовує переваги дискримінативних і генеративних підходів, зберігаючи докази та людську владу.
Докази впровадження та готовність до експлуатації
Рішення щодо впровадження потребує більшого, ніж успішна демонстрація. Визначте цільових користувачів, робоче середовище, вхідні та вихідні дані, залежності, власника та наслідки кожної важливої помилки. Встановіть відтворювану базову лінію та версійну оцінювальну вибірку до налаштування. Тестуйте звичайні випадки, граничні умови, некоректний або відсутній ввід, зсув розподілу, відмову залежностей, зловживання та групи або середовища, які найчастіше залишаються без належної підтримки. Вимірюйте якість завдання разом з калібруванням або невизначеністю, затримкою, пропускною здатністю, вартістю ресурсів, доступністю, конфіденційністю та безпекою. Фіксуйте кожне перетворення та поріг, щоб незалежний рецензент міг відтворити результат і розрізнити докази від привабливого прототипу.
Перед запуском призначте відповідальність за випуск, виключення, зміни, відкат та виведення з експлуатації. Використовуйте поетапний розгортання, зберігайте безпечний резерв та перевіряйте моніторинг за допомогою навмисно введених збоїв. Операційна телеметрія має розкривати якість вводу, поведінку виходу, версію моделі чи правила, стан залежностей, людські втручання та підтверджені результати без збору зайвих конфіденційних даних. Визначте пороги сповіщень та відповідального за реакцію, а потім перегляньте реальні докази після розгортання, а не припускайте, що офлайн‑продуктивність залишиться. Переглядайте знову щоразу, коли змінюються джерела даних, користувачі, моделі, постачальники, політики, обладнання або цілі. Підтримувана система також потребує документованих процедур відновлення, навчання на інцидентах, видалення та зберігання, а також чіткої точки, в якій її слід вимкнути або замінити.
Часті запитання
Чи є дискримінатор GAN‑а дискримінативною моделлю?
Він виконує дискримінацію під час навчання, проте весь GAN — це генеративна структура, вихід якої створює генератор.
Чи завжди дискримінативне навчання є контрольованим?
Ні. Термін описує модельоване відношення або межу, тоді як контроль описує навчальний сигнал. Сучасні цілі можуть розмивати ці категорії.
Основні джерела












