
AGI และ AI แห่งอนาคต
การทดสอบทัวริงคืออะไรและทำไมถึงสำคัญ?

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
การทดสอบทัวริงเกิดจากบทความของอัลัน ทัวริงในปี 1950 เรื่อง “Computing Machinery and Intelligence” แทนที่จะพยายามกำหนดความคิด ทัวริงได้เสนอเกมการเลียนแบบ: ผู้สอบถามมนุษย์สื่อสารด้วยข้อความเขียนกับผู้เข้าร่วมที่ไม่เปิดเผยตัวตนและตัดสินว่าผู้ใดเป็นมนุษย์และผู้ใดเป็นเครื่องจักร
การทดสอบยังคงมีอิทธิพลเพราะทำให้คำถามปรัชญาที่เป็นนามธรรมกลายเป็นการโต้ตอบที่สามารถสังเกตได้ แต่ก็มีข้อจำกัด: การดูเหมือนมนุษย์ในการสนทนาไม่ได้หมายความว่าจะซื่อสัตย์ มีความรู้ ปลอดภัย มีสติ หรือโดยรวมแล้วฉลาด
ประเด็นสำคัญ
- เกมการเลียนแบบดั้งเดิมของทัวริงเป็นการทดสอบเชิงพฤติกรรมโดยใช้ข้อความ ไม่ใช่รายการตรวจสอบคุณสมบัติทางปัญญาภายใน
- ผลลัพธ์ขึ้นอยู่กับผู้ประเมิน, คำสั่ง, ระยะเวลา, คำแนะนำของผู้เข้าร่วมและกฎการให้คะแนน
- โมเดลสามารถเลียนแบบการสนทนามนุษย์ได้แม้จะสร้างข้อเท็จจริงที่ไม่มีอยู่จริงหรือพลาดในการทดสอบความทนทานแบบง่าย
- การประเมินสมัยใหม่ต้องการเมตริกของงาน, การทดสอบเชิงศัตรู, การตรวจสอบโดยมนุษย์ และหลักฐานเฉพาะความเสี่ยงเพิ่มเติมจากการสนทนา
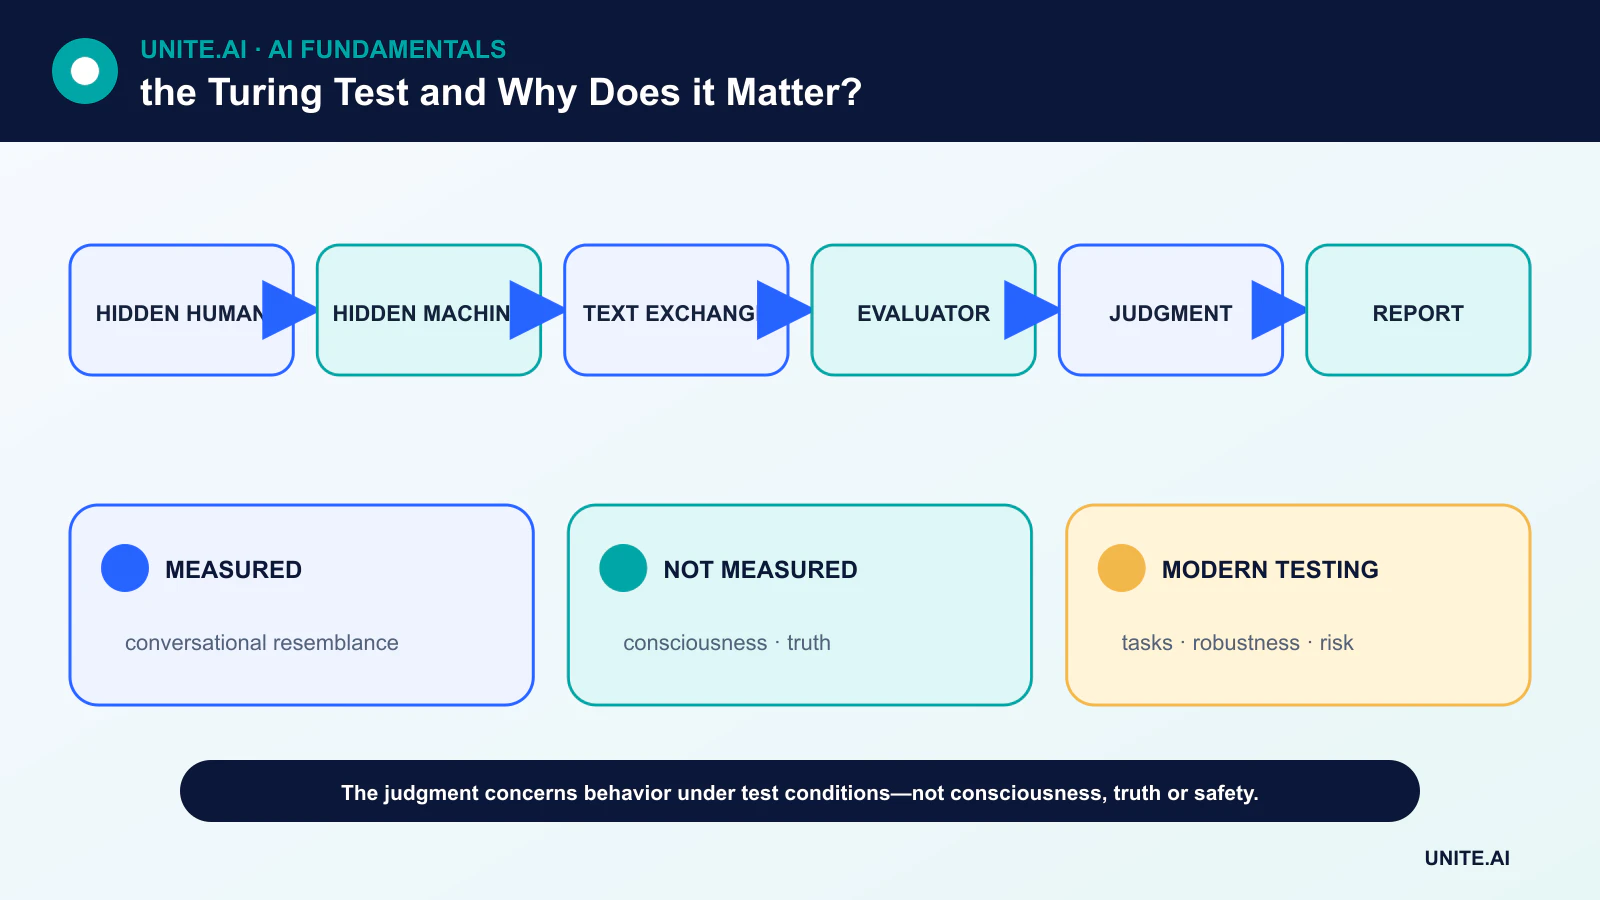
เกมการเลียนแบบของทัวริง
ในรูปแบบดั้งเดิม ผู้สอบถามสื่อสารจากระยะไกลเพื่อให้เสียงและรูปลักษณ์ไม่เปิดเผยตัวตน ทัวริงถามว่าเครื่องจักรจะสามารถทำได้ดีพอในเกมจนผู้ประเมินไม่สามารถแยกแยะได้อย่างเชื่อถือระหว่างเครื่องกับคน
การกำหนดรูปแบบเชิงปฏิบัตินี้หลีกเลี่ยงความจำเป็นในการกำหนดคำนิยามของการคิดหนึ่งเดียว มันไม่ได้อ้างว่าการแลกเปลี่ยนที่น่าเชื่อถือทุกครั้งพิสูจน์ความฉลาด, และไม่ได้กำหนดเกณฑ์การผ่านสากลที่ใช้กับการสาธิตแชทบอทใด ๆ ในภายหลัง
สิ่งที่ผลลัพธ์จริง ๆ วัดได้
การทดลองวัดความไม่แตกต่างของพฤติกรรมภายใต้เงื่อนไขที่กำหนด การสนทนาสั้น ๆ, ผู้ตัดสินที่ไม่มีประสบการณ์ หรือคำสั่งที่ผู้สร้างระบบเลือกอาจทำให้ภารกิจง่ายขึ้น รายงานที่เข้มงวดควรเปิดเผยการคัดเลือกบทสนทนา, จำนวนและพื้นฐานของผู้ตัดสิน, กลุ่มมนุษย์เปรียบเทียบ, ขีดจำกัดเวลาและวิธีสถิติที่ใช้
ระบบอาจใช้ประโยชน์จากความคาดหวัง: การหลีกเลี่ยง, อารมณ์ขัน, ความผิดพลาดในการพิมพ์และการสวมบทบาทอาจทำให้ดูเหมือนมนุษย์โดยไม่แสดงการให้เหตุผลที่เชื่อถือได้ ในทางกลับกัน คำตอบของมนุษย์ที่เป็นทางการเกินปกติอาจถูกจัดประเภทผิดว่าเป็นการสร้างโดยเครื่อง
สิ่งที่การทดสอบทัวริงไม่สามารถยืนยันได้
การทดสอบไม่ได้วัดโดยตรงถึงสติ, ประสบการณ์ส่วนบุคคล, ความแม่นยำของข้อเท็จจริง, ความเข้าใจเชิงสาเหตุ หรือการกระทำเชิงศีลธรรม มันไม่ได้เปิดเผยข้อมูลการฝึกฝน, สถาปัตยกรรมของโมเดล หรือรูปแบบความล้มเหลวนอกการสนทนา นอกจากนี้ยังให้ข้อมูลน้อยเกี่ยวกับปัญญาที่ไม่ใช่ภาษา เช่น ความสามารถในการจัดการทางกายภาพ
ระบบภาษาสมัยใหม่สร้างด้วย transformer neural networks และ deep learning แต่ผลลัพธ์ที่คล่องแคล่วยังอาจถูกสร้างจากโครงสร้างสถิติที่เรียนรู้ไว้ แทนที่จะเป็นโมเดลโลกที่ได้รับการตรวจสอบ
การประเมิน AI สมัยใหม่ขยายคำถามอย่างไร
การประเมินสมัยใหม่ใช้ชุดงานที่แยกออก, ความไม่แน่นอนที่ปรับเทียบ, การทดสอบความทนทาน, การทำ red teaming, การตรวจสอบความเป็นจริงและการศึกษาความชอบของมนุษย์ เมตริก text‑classification สามารถทดสอบพฤติกรรมที่กำหนดไว้ได้ ในขณะที่การประเมินแบบสถานการณ์สามารถตรวจสอบว่าระบบปฏิบัติตามนโยบายภายใต้ความกดดันหรือไม่
ไม่มีเกณฑ์มาตรฐานเดียวที่ครอบคลุมการใช้งานทุกกรณี การปนเปื้อนของการทดสอบอาจทำให้คะแนนเพิ่มขึ้น และเกณฑ์มาตรฐานคงที่ส่งเสริมการโอเวอร์ฟิต การประเมินควรทำซ้ำเมื่อโมเดล, ข้อมูล, คำสั่ง, เครื่องมือและกลุ่มผู้ใช้เปลี่ยนแปลง
ทำไมการทดสอบนี้ยังคงมีความสำคัญ
การทดสอบทัวริงคาดการณ์บทเรียนหลักของการประเมิน AI ไว้แล้ว: ประเมินความสามารถที่สังเกตได้แทนการพึ่งพาข้ออ้างเกี่ยวกับแก่นภายใน มันยังบังคับให้เราถามว่าพฤติกรรมมนุษย์ใดถือเป็นหลักฐานและการตั้งค่าการทดลองส่งผลต่อข้อสรุปอย่างไร
การใช้ที่ดีที่สุดในยุคปัจจุบันคือเป็นฐานข้อมูลเชิงประวัติศาสตร์และแนวคิด การผ่านเกมการเลียนแบบอาจน่าสนใจ แต่การตัดสินใจนำไปใช้จริงต้องอาศัยหลักฐานที่เชื่อมโยงกับงานจริง ผู้ใช้ที่ได้รับผลกระทบ และอันตรายที่คาดการณ์ได้
สิ่งที่การทดสอบทัวริงวัดได้
เกมการเลียนแบบของทัวริงถามว่าผู้สอบถามที่สื่อสารผ่านข้อความสามารถแยกแยะเครื่องจักรจากคนได้อย่างเชื่อถือหรือไม่ มันได้เปลี่ยนการโต้เถียงเชิงนามธรรมเกี่ยวกับว่ากลไกของเครื่องจักรคิดได้หรือไม่ให้เป็นการทดลองการสนทนาที่สังเกตได้ การทดสอบขึ้นอยู่กับผู้เข้าร่วม, ระยะเวลา, ระเบียบปฏิบัติ, หัวข้อ, และกฎการตัดสิน; ไม่มีคะแนนสากลเดียวที่ใช้ได้ทั่วโลก การผ่านหมายถึงการสร้างคำตอบที่คล้ายมนุษย์ภายใต้เงื่อนไขนั้น มันไม่ได้วัดโดยตรงถึงความแม่นยำของข้อเท็จจริง, การให้เหตุผล, สติ, ความเป็นอิสระ, การรับรู้, การเป็นรูปธรรม, ความน่าเชื่อถือ, หรือพฤติกรรมที่เป็นประโยชน์ต่อโลกจริง
การเลียนแบบของมนุษย์อาจให้รางวัลกับการหลบหลีก, บุคลิก, ความผิดพลาด, อารมณ์ขัน หรือการหลอกลวง ผู้ตัดสินอาจสับสนระหว่างมนุษย์และเครื่อง หรือได้รับอิทธิพลจากความคาดหวัง, ภาษา, และบริบททางวัฒนธรรม การสนทนาสั้น ๆ ทำให้เกิดกลเม็ดที่ล้มเหลวเมื่อสนทนายาวต่อเนื่อง ในทางกลับกัน ระบบที่มีประโยชน์สูงสำหรับคณิตศาสตร์, การแปล, หรือการจำลองโปรตีนอาจล้มเหลวเพราะไม่ได้พยายามเลียนแบบมนุษย์ ดังนั้นการทดสอบจึงวัดความสามารถทางสังคมและภาษา ที่ถูกกำหนดโดยผู้ประเมิน ไม่ใช่การจัดอันดับความฉลาดโดยสมบูรณ์
โมเดลภาษาขนาดใหญ่และการประเมินที่แข็งแกร่งขึ้น
โมเดลภาษาขนาดใหญ่สามารถรักษาการสนทนาที่คล่องแคล่วได้โดยการทำนายลำดับจากข้อมูลการฝึกฝนกว้างและการปรับแต่งต่อมา แต่ความคล่องแคล่วเป็นหลักฐานที่อ่อนแอของความจริงหรือความเข้าใจ รูปแบบที่จำไว้, การเข้าถึงเครื่องมือ, การสั่งงานแบบซ่อน, ความหน่วงเวลา, และการตั้งค่าการสุ่มตัวอย่างส่งผลต่อผลลัพธ์ การประเมินที่ควบคุมควรเปิดเผยโมเดลและระเบียบปฏิบัติ, ป้องกันการรั่วไหลของข้อมูล, รวมคำถามเชิงศัตรูและโดเมน, และให้คะแนนความไม่แน่นอนและการอ้างอิง การสาธิตที่เลือกจากการสนทนาที่ประสบความสำเร็จไม่สามารถประมาณความน่าเชื่อถือทั่วทั้งการใช้งานได้
การประเมินสมัยใหม่เป็นหลายมิติ: ความแม่นยำของงาน, การปรับเทียบ, ความทนทาน, ความสอดคล้องระยะยาว, ความปลอดภัย, ความลำเอียง, ความเป็นส่วนตัว, ความปลอดภัย, ประสิทธิภาพ, และผลลัพธ์ต่อมนุษย์ การทดสอบเชิงพฤติกรรมควรเสริมด้วยหลักฐานกระบวนการ, red teaming, เกณฑ์มาตรฐานที่ทำซ้ำได้, และการเฝ้าติดตามในโลกจริง เกณฑ์มาตรฐานอาจอิ่มตัวหรือเข้าสู่ข้อมูลการฝึกฝน ดังนั้นจึงต้องมีชุดทดสอบส่วนตัวและอัปเดตใหม่ สำหรับระบบที่ทำการกระทำ ต้องประเมินสิทธิ์การใช้เครื่องมือ, การกู้คืน, และผลกระทบแยกจากคุณภาพการสนทนา
ทำไมการทดสอบนี้ยังคงมีความสำคัญ
การทดสอบทัวริงยังคงสำคัญในเชิงประวัติศาสตร์เพราะมุ่งเน้นที่พฤติกรรมและความยากในการกำหนดความฉลาด นอกจากนี้ยังยกประเด็นต่อเนื่องเกี่ยวกับการทำให้มนุษย์เป็นลักษณะของเครื่องและการหลอกลวง อินเทอร์เฟซควรระบุเอเจนต์สังเคราะห์แทนการถือว่าการระบุตัวตนผิดพลาดเป็นความสำเร็จ โดยเฉพาะในสถานการณ์ที่มีผลสำคัญ ใช้การทดสอบเป็นเลนส์ปรัชญาและการประเมินการสนทนาหนึ่งครั้ง ไม่ใช่การรับรองความฉลาดทั่วไปหรือการเป็นบุคคล คำถามสำคัญในการนำไปใช้คือ ระบบทำอะไรได้อย่างเชื่อถือได้ ภายใต้หลักฐานและขอบเขตใด และใครจะรับผิดชอบเมื่อระบบล้มเหลว
ตัวอย่างการทำงาน: การประเมินการสนทนาที่ควบคุม
ผู้ประเมินเปรียบเทียบมนุษย์และระบบ AI หลายระบบในบทสนทนาข้อความที่มีระยะเวลา, หัวข้อ, ภาษา, และตัวตนที่ปิดบังแบบคงที่ ผู้ตัดสินบันทึกว่าพวกเขาเชื่อว่าผู้เข้าร่วมแต่ละคนเป็นมนุษย์หรือไม่ และให้คะแนนความเป็นจริง, ความสอดคล้อง, ความเป็นประโยชน์, ความไม่แน่นอน, และการหลอกลวง การใช้ผู้ตัดสินหลายคนและหลายบทสนทนาช่วยประมาณความแปรปรวน และระเบียบปฏิบัติกันไม่ให้ผู้พัฒนาโมเดลเลือกบทสนทนาที่เป็นประโยชน์ต่อพวกเขา การจัดประเภทมนุษย์ผิดพลาดให้ฐานข้อมูลที่จำเป็นสำหรับการตีความผลลัพธ์
ระบบที่ทำให้ผู้ตัดสินหลงแต่สร้างข้อเท็จจริงขึ้นใหม่จะไม่ได้รับการประกาศว่าเป็นปัญญาทั่วไป ในขณะที่โมเดลผู้เชี่ยวชาญที่เปิดเผยอย่างชัดเจนอาจมีประโยชน์สูงแม้จะล้มเหลวในการเลียนแบบ ผลลัพธ์รวมถึงคำสั่ง, โมเดล, ตัวสุ่ม, การเข้าถึงเครื่องมือ, และลักษณะของผู้ตัดสิน การทดลองถูกตั้งเป็นการทดสอบหนึ่งครั้งของการสนทนาแบบมนุษย์ การตัดสินใจนำไปใช้จริงใช้หลักฐานแยกต่างหากสำหรับความถูกต้องของงาน, ความปลอดภัย, ความเป็นส่วนตัว, และการกู้คืน และอินเทอร์เฟซระบุเอเจนต์แทนการทำให้การหลอกลวงเป็นเป้าหมายของผลิตภัณฑ์
หลักฐานการใช้งานและความพร้อมในการปฏิบัติการ
การตัดสินใจผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, ขึ้นต่อ, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละประการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่เวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีปกติ, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การหยุดทำงานของส่วนขึ้นต่อ, การใช้ในทางที่ผิด, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการปรับเทียบหรือความไม่แน่นอน, ความหน่วงเวลา, ปริมาณการทำงาน, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัว, และความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกอย่างเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูดใจ
ก่อนการเปิดตัว ให้มอบอำนาจการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวแบบขั้นเป็นขั้น, รักษาการสำรองที่ปลอดภัย, และตรวจสอบการเฝ้าติดตามด้วยการฉีดความล้มเหลวโดยเจตนา เทเลเมทรีการปฏิบัติการควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, รุ่นหรือเวอร์ชันของกฎ, สถานะส่วนขึ้นต่อ, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง แล้วตรวจสอบหลักฐานในโลกจริงหลังการเปิดใช้งานแทนการสมมติว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์, หรือเป้าหมายเปลี่ยนแปลง ระบบที่ดูแลอย่างต่อเนื่องยังต้องมีขั้นตอนการกู้คืน, การเรียนรู้จากเหตุการณ์, การลบและการเก็บรักษาที่บันทึกไว้, และจุดชัดเจนที่ควรปิดหรือแทนที่
คำถามที่พบบ่อย
AI ใดเคยผ่านการทดสอบทัวริงอย่างแน่นอนหรือไม่?
ไม่มีหน่วยงานทดสอบอย่างเป็นทางการหรือโพรโทคอลที่ได้รับการยอมรับทั่วโลก การสาธิตสาธารณะใช้กฎที่แตกต่างกัน ดังนั้นการอ้างว่า “ผ่าน” จึงไม่สามารถเปรียบเทียบโดยตรงได้
การล้มเหลวในการทดสอบพิสูจน์ว่าระบบไม่มีสติหรือไม่?
ไม่ ระบบเฉพาะทางอาจมีความสามารถสูงโดยไม่ต้องเลียนแบบสไตล์การสนทนาของมนุษย์
แหล่งอ้างอิงหลัก












