
มุมมองของ Anderson
UniTune: เทคนิคทางเลือกของ Google สำหรับการแก้ไขภาพด้วยโครงข่ายประสาท

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
ประเด็นสำคัญUniTune ปรับแต่งโมเดลการแพร่กระจายบนภาพเดียวเพื่อให้สามารถแก้ไขตามข้อความได้อย่างแม่นยำ
ดูเพิ่มเติม
- UniTune ปรับแต่งโมเดลการแพร่กระจายบนภาพเดียวเพื่อให้สามารถแก้ไขตามข้อความได้อย่างแม่นยำ
- แตกต่างจาก DreamBooth หรือ Textual Inversion, UniTune ปฏิเสธทั้งสองแนวทางเพื่อการคงรายละเอียดที่ดีกว่า
- วิธีการนี้บรรลุการแยกความหมายในระดับสูง โดยคงใบหน้าไว้ไม่เปลี่ยนแปลงระหว่างการเปลี่ยนแปลงพื้นหลังที่รุนแรง
Google Research ดูเหมือนจะโจมตีการแก้ไขภาพโดยใช้ข้อความจากหลายด้าน และอาจจะรอเพื่อดูว่าอะไรจะ “ได้ผล” หลังจากการเปิดตัว Imagic paper ในสัปดาห์นี้ ยักษ์ใหญ่ด้านการค้นหานี้ได้เสนอวิธีการแก้ไขภาพโดยใช้เทคนิคการกระจายแบบแฝง (latent diffusion-based method) เพื่อทำการแก้ไขภาพด้วย AI ที่วิธีอื่นทำไม่ได้ ผ่านคำสั่งข้อความ โดยเรียกว่า UniTune
ตามตัวอย่างที่ให้ไว้ใน เอกสารใหม่ ของโครงการ UniTune สามารถแยกท่าทางและแนวคิดเชิงความหมายออกจากเนื้อหาภาพจริงได้อย่างน่าประทับใจ:

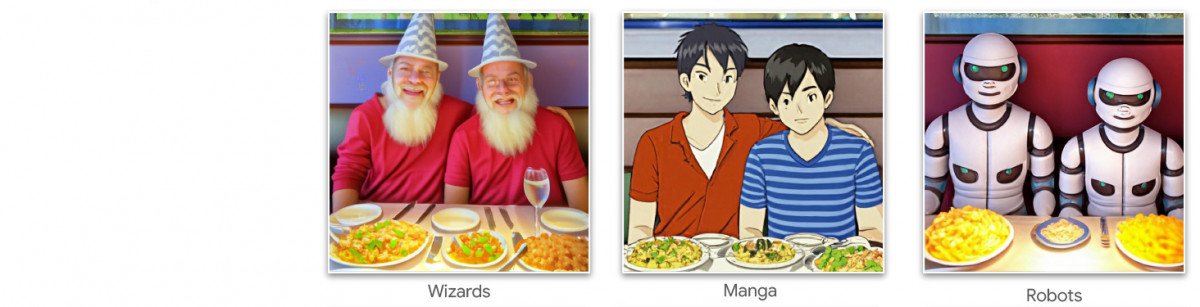

UniTune ควบคุมองค์ประกอบเชิงความหมายได้อย่างโดดเด่น โปรดสังเกตว่าในแถวบนสุดของภาพ ว่าใบหน้าของคนสองคนไม่ได้ถูกบิดเบือนโดยการเปลี่ยนแปลงอย่างมากในส่วนอื่นของภาพต้นฉบับ (ด้านขวา) Source: https://arxiv.org/pdf/2210.09477.pdf
สำหรับแฟน ๆ ของ Stable Diffusion จะได้เรียนรู้แล้วว่าการแก้ไขภาพบางส่วนโดยไม่เปลี่ยนแปลงส่วนอื่นของภาพอาจเป็นกระบวนการที่ยากและไม่แน่นอน แม้ว่าดิสทริบิวชันยอดนิยม เช่น AUTOMATIC1111 สามารถสร้างมาสก์สำหรับการแก้ไขท้องถิ่นและจำกัดได้ แต่กระบวนการนี้อาจซับซ้อนและไม่คาดเดาได้
คำตอบที่ชัดเจนสำหรับผู้ปฏิบัติงานด้านการมองเห็นของคอมพิวเตอร์ คือการแทรกชั้นของการแบ่งส่วนเชิงความหมาย ที่สามารถรับรู้และแยกสิ่งของในภาพโดยไม่ต้องมีการแทรกแซงจากผู้ใช้ และในความเป็นจริง มีหลายโครงการใหม่ ๆ ในแนวคิดนี้
ความเป็นไปได้อีกอย่างหนึ่งในการล็อกการแก้ไขภาพที่ซับซ้อนและปนกันคือการใช้โมดูล CLIP (Contrastive Language–Image Pre-training) ของ OpenAI ซึ่งเป็นหัวใจของโมเดลการกระจายแบบแฝง เช่น DALL-E 2 และ Stable Diffusion ในการทำงานเป็นฟิลเตอร์ที่จุดซึ่งโมเดลการสร้างภาพจากข้อความพร้อมที่จะส่งการแสดงผลกลับไปยังผู้ใช้ ในบริบทนี้ CLIP ควรทำงานเป็นเซ็นเทลและโมดูลควบคุมคุณภาพ โดยปฏิเสธภาพที่ผิดรูปหรือไม่เหมาะสม วิธีนี้กำลังจะนำมาใช้ (ลิงก์ Discord) ที่พอร์ทัล DreamStudio ของ Stability.ai ซึ่งทำงานผ่าน API อย่างไรก็ตาม CLIP อาจเป็นทั้งสาเหตุและทางแก้ในสถานการณ์นี้ เพราะมีส่วนกำหนดวิธีสร้างภาพด้วย และข้อกำหนดด้านฮาร์ดแวร์อาจเกินทรัพยากรที่ผู้ใช้ทั่วไปมีในเครื่อง วิธีนี้จึงอาจไม่เหมาะนัก
ภาษาที่ถูกบีบอัด
UniTune ที่เสนอแทน ‘ปรับแต่ง’ โมเดลการกระจายแบบแฝงที่มีอยู่ – ในกรณีนี้คือ Imagen ของ Google แม้นักวิจัยระบุว่าวิธีนี้เข้ากันได้กับสถาปัตยกรรมการแพร่แบบแฝงอื่นด้วย โดยมีโทเค็นแบบเฉพาะที่ถูกฉีดเข้าไป ซึ่งสามารถเรียกได้โดยการรวมเข้ากับข้อความคำสั่ง
ในทางที่ดูเหมือน Google DreamBooth ซึ่งเป็นความหลงใหลในปัจจุบันของแฟน ๆ และนักพัฒนาของ Stable Diffusion ซึ่งสามารถฉีดตัวละครหรือวัตถุใหม่เข้าไปในจุดตรวจสอบที่มีอยู่ได้ภายในหนึ่งชั่วโมง โดยอาศัยเพียงภาพต้นฉบับไม่กี่ภาพ หรือ Textual Inversion ซึ่งสร้างไฟล์ ‘sidecar’ สำหรับจุดตรวจสอบ ซึ่งถือว่าเป็นไฟล์ที่ถูกฝึกฝนมาจากโมเดล และสามารถใช้ทรัพยากรของโมเดลได้โดยการปรับเปลี่ยนคลาสสิฟายเออร์ข้อความของโมเดล ทำให้ได้ไฟล์ขนาดเล็กเมื่อเทียบกับจุดตรวจสอบของ DreamBooth ที่แม้ตัดส่วนเกินออกแล้วก็ยังมีขนาดอย่างน้อย 2 GB
ในความเป็นจริง นักวิจัยยืนยันว่า UniTune ปฏิเสธทั้งสองแนวทางนี้ พวกเขาพบว่า Textual Inversion ไม่ได้ให้รายละเอียดที่สำคัญ และ DreamBooth ‘ให้ผลแย่กว่าและใช้เวลานานกว่า’ วิธีแก้ปัญหาที่พวกเขาตัดสินใจใช้
อย่างไรก็ตาม UniTune ใช้แนวทาง “เมตาพรอมต์” เชิงความหมายแบบห่อหุ้มเช่นเดียวกับ DreamBooth การเปลี่ยนแปลงที่เรียนรู้จะถูกเรียกด้วยคำเฉพาะที่ผู้ฝึกเลือก ซึ่งไม่ชนกับคำที่มีอยู่ในโมเดลสาธารณะที่ผ่านการฝึกอย่างยากลำบากแล้ว QUOTEOPEN“ในการแก้ไข เราสุ่มตัวอย่างจากโมเดลที่ปรับแต่งแล้วด้วยพรอมต์ «[rare_tokens] edit_prompt» (เช่น «beikkpic สุนัขสองตัวในร้านอาหาร» หรือ «beikkpic มินเนียน»)”QUOTECLOSE
กระบวนการ
แม้จะน่าสงสัยว่าเหตุใด Google จึงเผยแพร่เอกสารสองฉบับที่มีการทำงานขั้นสุดท้ายเกือบเหมือนกันในสัปดาห์เดียวกัน และแม้ทั้งสองแนวทางมีความคล้ายกันมาก แต่ก็มีความแตกต่างที่ชัดเจนอย่างน้อยหนึ่งอย่างระหว่าง UniTune และ Imagic – อันหลังใช้ข้อความคำสั่งภาษาธรรมชาติ ‘ไม่บีบอัด’ เพื่อชี้นำการแก้ไขภาพ ในขณะที่ UniTune ฝึกโทเค็นแบบเฉพาะในลักษณะ DreamBooth
ดังนั้น หากคุณกำลังแก้ไขด้วย Imagic และต้องการเปลี่ยนแปลงเช่นนี้…

จากเอกสาร UniTune – UniTune เปรียบเทียบกับ SDEdit ซึ่งเป็นกรอบการแก้ไขด้วยโครงข่ายประสาทคู่แข่งที่ Google นิยมใช้ ผลลัพธ์ของ UniTune อยู่ทางด้านขวาสุด ในขณะที่มาสก์ที่คำนวณไว้จะเห็นได้ในภาพที่สองจากซ้าย
.. ใน Imagic คุณจะป้อน ‘บุคคลที่สามซึ่งนั่งอยู่ด้านหลังเป็นสัตว์ประหลาดขนปุยน่ารัก’ ใน UniTune คำสั่งเทียบเท่าจะเป็น ‘คนด้านหลังเป็น [x]’ โดยที่ x คือคำที่ไม่ธรรมดาที่ถูกผูกไว้กับแนวคิดที่ฝึกฝนมาเกี่ยวกับตัวละครมอนสเตอร์ขนปุย
DreamBooth และ Textual Inversion รับภาพหลายภาพเพื่อสร้างนามธรรมแบบดีปเฟกที่สั่งให้แสดงท่าทางต่างๆ ได้ แต่ UniTune และ Imagic รับเพียงภาพเดียว คือภาพต้นฉบับที่ยังไม่แก้ไข วิธีนี้คล้ายเครื่องมือแก้ไขที่ใช้ GAN ในช่วงไม่กี่ปีที่ผ่านมา ซึ่งแปลงภาพเป็นรหัสในปริภูมิแฝงของ GAN แล้วส่งรหัสไปยังส่วนอื่นของปริภูมิเพื่อแก้ไข เช่น ส่งภาพคนหนุ่มผมดำผ่านรหัสที่สัมพันธ์กับ “แก่” หรือ “ผมบลอนด์” แต่ผลลัพธ์จากวิธีนี้ในโมเดลการแพร่นั้นแม่นยำอย่างน่าทึ่งเมื่อเทียบกัน และกำกวมน้อยกว่ามาก 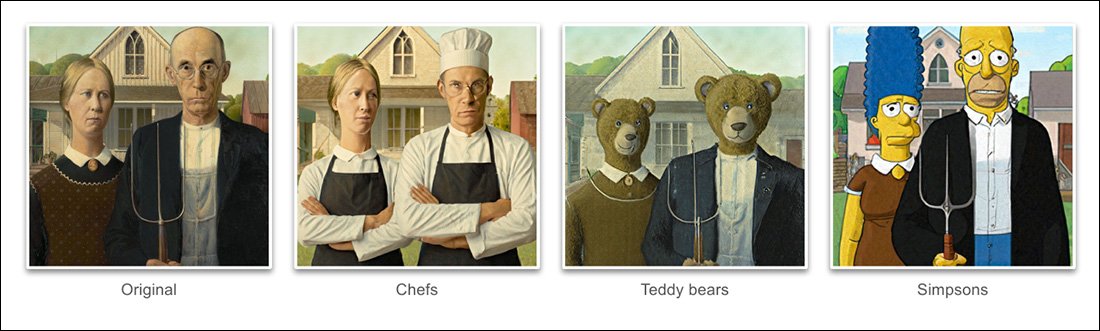
กระบวนการปรับแต่ง
วิธีการ UniTune ส่งภาพต้นฉบับผ่านโมเดลการกระจายแบบแฝงด้วยชุดคำสั่งวิธีการแก้ไข โดยใช้ข้อมูลที่มีอยู่มากมายที่ฝึกฝนมาในโมเดล ในความเป็นจริง คุณสามารถทำสิ่งนี้ได้แล้วโดยใช้ฟังก์ชัน img2img ของ Stable Diffusion – แต่ไม่ใช่โดยไม่บิดเบือนหรือเปลี่ยนแปลงส่วนอื่นของภาพที่คุณต้องการเก็บไว้
ระหว่างกระบวนการ UniTune ระบบจะถูกปรับแต่งอย่างละเอียด ซึ่งหมายความว่า UniTune บังคับให้โมเดลกลับมาฝึกฝนใหม่ โดยปลดการตรึงพารามิเตอร์ในชั้นส่วนใหญ่เพื่อให้ฝึกต่อได้ (ดูรายละเอียดด้านล่าง) ในกรณีส่วนใหญ่ การปรับแต่งจะลดค่าความสูญเสียโดยทั่วไปของโมเดลที่มีประสิทธิภาพสูงเพื่อประโยชน์ของการฉีดหรือการปรับปรุงบางสิ่งที่ต้องการสร้างหรือเพิ่มขึ้น
อย่างไรก็ตาม สำเนาโมเดลที่ UniTune ปรับแต่ง แม้อาจมีขนาดหลายกิกะไบต์หรือมากกว่า ดูจะถูกใช้เป็น “เปลือก” ชั่วคราวแล้วทิ้งเมื่อจบกระบวนการหลังทำหน้าที่เดียว ข้อมูลปริมาณมากเช่นนี้กำลังกลายเป็นวิกฤตพื้นที่เก็บข้อมูลประจำวันสำหรับผู้ใช้ DreamBooth ซึ่งโมเดลที่ตัดส่วนเกินแล้วก็ยังมีขนาดอย่างน้อย 2 GB ต่อหัวข้อ เช่นเดียวกับ Imagic การปรับแต่งหลักของ UniTune เกิดที่สองระดับล่างจากสามระดับของ Imagen (ฐาน 64px, 64px>256px และ 256px>1024px) แต่ต่างจาก Imagic นักวิจัยเห็นประโยชน์ที่อาจได้จากการปรับระดับเพิ่มความละเอียดสุดท้ายที่ใหญ่ที่สุดด้วย แม้ยังไม่ได้ลอง สำหรับระดับฐาน 64px การฝึกจะโน้มโมเดลไปทางภาพต้นฉบับ โดยป้อนคู่ภาพและข้อความซ้ำหลายคู่ตลอด 128 รอบ ด้วยขนาดแบตช์ 4 และใช้ Adafactor เป็นฟังก์ชันความสูญเสียที่อัตราการเรียนรู้ 0.0001 มีเพียงตัวเข้ารหัส T5 ที่ถูกตรึงระหว่างการปรับแต่งนี้ และมันก็ถูกตรึงระหว่างการฝึก Imagen ตั้งต้นเช่นกัน จากนั้นทำซ้ำในระดับ 64>256px ด้วยวิธีเพิ่มสัญญาณรบกวนแบบเดียวกับการฝึก Imagen เดิม
การสุ่มตัวอย่าง
มีวิธีสุ่มตัวอย่างหลายวิธีที่ดึงการเปลี่ยนแปลงจากโมเดลที่ปรับแต่งแล้วได้ รวมถึงการชี้นำแบบไม่ใช้ตัวจำแนก (Classifier Free Guidance หรือ CFG) ซึ่งเป็นหลักสำคัญของ Stable Diffusion ด้วย โดย CFG กำหนดว่าโมเดลมีอิสระเพียงใดในการ “ทำตามจินตนาการ” และสำรวจการสร้างภาพ หรือเมื่อใช้ค่าต่ำ โมเดลควรยึดข้อมูลต้นฉบับมากเพียงใดและเปลี่ยนแปลงอย่างกว้างขวางหรือรุนแรงน้อยลง

เช่นเดียวกับ Textual Inversion (และ DreamBooth ในระดับที่น้อยกว่า) UniTune สามารถใช้ในการใช้สไตล์กราฟิกที่แตกต่างกันสำหรับภาพต้นฉบับได้ เช่นเดียวกับการแก้ไขภาพที่เหมือนจริง
นักวิจัยยังทดลองเทคนิค “เริ่มช้า” ของ SDEdit ซึ่งส่งเสริมให้ระบบรักษารายละเอียดต้นฉบับด้วยการเริ่มจากสัญญาณรบกวนเพียงบางส่วน จึงยังคงลักษณะสำคัญไว้ แม้จะใช้เพียงระดับล่างสุด 64px แต่นักวิจัยเชื่อว่าอาจเป็นเทคนิคสุ่มตัวอย่างเสริมที่มีประโยชน์ในอนาคต
นักวิจัยยังใช้พรอมต์ต่อพรอมต์เป็นเทคนิคข้อความเพิ่มเติมเพื่อกำหนดเงื่อนไขให้โมเดล: QUOTEOPEN“ในการตั้งค่าแบบ «prompt to prompt» เราพบว่าเทคนิคที่เรียกว่า Prompt Guidance มีประโยชน์มากในการปรับความเที่ยงตรงและความสามารถในการแสดงออก”QUOTECLOSEQUOTEOPEN“Prompt Guidance คล้ายกับ CFG แต่ใช้พรอมต์อื่นเป็นฐานอ้างอิงแทนโมเดลที่ไม่มีเงื่อนไข วิธีนี้ชี้นำโมเดลไปยังผลต่างระหว่างสองพรอมต์”QUOTECLOSE

พรอมต์ต่อพรอมต์ใน UniTune แยกพื้นที่ที่ต้องการแก้ไขได้อย่างมีประสิทธิภาพ
อย่างไรก็ตาม ผู้เขียนระบุว่าต้องใช้การชี้นำด้วยพรอมต์เป็นบางครั้งเท่านั้น เมื่อ CFG ไม่ให้ผลตามต้องการ อีกแนวทางสุ่มตัวอย่างใหม่ที่พบระหว่างพัฒนา UniTune คือการแทรกค่า เมื่อพื้นที่ในภาพแยกจากกันชัดเจนพอ และภาพต้นฉบับกับภาพที่แก้ไขมีองค์ประกอบคล้ายกันมาก จึงใช้การแทรกค่าแบบเรียบง่ายกว่าได้

การแทรกค่าอาจทำให้ไม่ต้องใช้ขั้นตอนที่ซับซ้อนกว่าของ UniTune เมื่อพื้นที่ที่ต้องการเปลี่ยนแยกจากกันและมีขอบเขตชัดเจน
ผู้เขียนเสนอว่าการแทรกค่าอาจทำงานได้ดีมากกับภาพต้นฉบับจำนวนมากจนใช้เป็นค่าเริ่มต้นได้ และอาจสร้างการเปลี่ยนแปลงอย่างน่าทึ่งเมื่อไม่ต้องจัดการส่วนที่บดบังกันอย่างซับซ้อนด้วยวิธีที่เข้มข้นกว่า UniTune แก้ไขเฉพาะจุดได้ทั้งแบบมีและไม่มีมาสก์ และยังตัดสินใจเองได้ว่าจะวางการแก้ไขตรงไหน โดยผสานความสามารถในการตีความกับการคงสาระสำคัญของข้อมูลต้นฉบับไว้อย่างมั่นคง:

ในภาพบนสุดของคอลัมน์ที่สอง UniTune ได้รับคำสั่งให้เพิ่ม “รถไฟสีแดงในฉากหลัง” และวางไว้ในตำแหน่งที่เหมาะสมและสมจริง ตัวอย่างอื่นแสดงว่าความสอดคล้องเชิงความหมายกับต้นฉบับยังคงอยู่ แม้เนื้อหาพิกเซลและรูปแบบหลักของภาพจะเปลี่ยนอย่างมาก
ความหน่วง
แม้ระบบใหม่เวอร์ชันแรกจะช้า และการมีส่วนร่วมของชุมชนหรือความมุ่งมั่นของบริษัท (โดยปกติไม่ใช่ทั้งสองอย่าง) อาจช่วยเร่งและปรับปรุงขั้นตอนที่ใช้ทรัพยากรมากได้ในที่สุด แต่ UniTune และ Imagic ต่างต้องดำเนินกระบวนการเรียนรู้ของเครื่องขนาดใหญ่เพื่อสร้างการแก้ไขเหล่านี้ จึงยังน่าสงสัยว่าจะลดขนาดให้ใช้ในบ้านแทนการเข้าถึงผ่าน API ได้เพียงใด แม้ Google อาจชอบแนวทาง API มากกว่า
ในขณะนี้ การเดินทางรอบจากข้อมูลเข้าไปจนถึงผลลัพธ์ใช้เวลาประมาณ 3 นาทีใน T4 GPU โดยมีเวลาเพิ่มเติมประมาณ 30 วินาทีสำหรับการอนุมาน (ตามที่ระบุไว้ในกระบวนการอนุมานใดๆ) ผู้เขียนยอมรับว่านี่คือความหน่วงสูง และแทบจะไม่ถือว่าเป็น ‘แบบโต้ตอบ’ แต่พวกเขายังชี้ให้เห็นว่าโมเดลยังคงอยู่และพร้อมสำหรับการแก้ไขเพิ่มเติมหลังจากที่ถูกปรับแต่งครั้งแรก จนกว่าผู้ใช้จะเสร็จสิ้นกระบวนการ ซึ่งจะช่วยลดเวลาแก้ไขต่อครั้ง
เผยแพร่ครั้งแรกเมื่อวันที่ 21 ตุลาคม 2022


