
มุมมองของ Anderson
การแก้ไขวัตถุด้วย AI ผ่าน Imagic ของ Google และ Erase and Replace ของ Runway

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญImagic ปรับแต่งโมเดล diffusion อย่างละเอียดสำหรับการแก้ไขวัตถุในระดับละเอียด ต่างจาก…
ดูเพิ่มเติม
- Imagic ปรับแต่งโมเดล diffusion อย่างละเอียดสำหรับการแก้ไขวัตถุในระดับละเอียด ต่างจาก Erase and Replace ของ Runway ที่ทำได้เพียงการแทนที่เท่านั้น
- Erase and Replace ของ Runway แทนที่วัตถุได้อย่างรวดเร็ว แต่ไม่สามารถแก้ไขเนื้อหาที่มีอยู่ได้ ทำได้เพียงแทนที่เท่านั้น
- การปรับแต่งต่อภาพของ Imagic ใช้เวลาแปดนาทีบนชิป TPUV4 สองตัว ซึ่งจำกัดการใช้งานไว้เฉพาะผ่าน API
สัปดาห์นี้มีอัลกอริธึมกราฟิกที่ขับเคลื่อนด้วย AI สองตัวใหม่ที่แตกต่างกัน นำเสนอวิธีใหม่ให้ผู้ใช้ทำการเปลี่ยนแปลงวัตถุในภาพอย่างละเอียดและมีประสิทธิภาพสูง
ตัวแรกคือ Imagic จาก Google Research ร่วมกับสถาบันเทคโนโลยีแห่งอิสราเอลและสถาบันวิทยาศาสตร์ไวซ์มันน์ Imagic ให้การแก้ไขวัตถุตามข้อความโดยละเอียดผ่านการปรับจูนโมเดลการกระจาย

เปลี่ยนสิ่งที่คุณต้องการและปล่อยส่วนที่เหลือไว้ – Imagic สัญญาว่าจะทำการแก้ไขอย่างละเอียดเฉพาะส่วนที่คุณต้องการเปลี่ยน แหล่งที่มา: https://arxiv.org/pdf/2210.09276.pdf
ใครที่เคยพยายามเปลี่ยนแค่ส่วนเดียวในภาพที่สร้างใหม่ด้วย Stable Diffusion จะรู้ดีว่า สำหรับการแก้ไขที่สำเร็จหนึ่งครั้ง ระบบจะเปลี่ยนห้าส่วนที่คุณชอบอยู่แล้ว นี่เป็นข้อจำกัดที่ทำให้ผู้ใช้ Stable Diffusion ที่มีความสามารถหลายคนต้องสลับไปมาระหว่าง Stable Diffusion กับ Photoshop เพื่อแก้ไข “ความเสียหายโดยอ้อม” นี้ จากมุมมองนี้ ความสำเร็จของ Imagic จึงดูน่าสนใจ
ณ เวลาที่เขียนบทความนี้ Imagic ยังไม่มีวิดีโอโฆษณาใด ๆ และเนื่องจาก Google มี ท่าทีระมัดระวัง ต่อการปล่อยเครื่องมือสังเคราะห์ภาพอย่างเสรี จึงยังไม่แน่ใจว่าเราจะได้มีโอกาสทดสอบระบบนี้หรือไม่
ข้อเสนอที่สองคือฟีเจอร์ Erase and Replace ของ Runway ML ซึ่งเป็น ฟีเจอร์ใหม่ ในส่วน “AI Magic Tools” ของชุดเครื่องมือเอฟเฟกต์ภาพที่ใช้การเรียนรู้ของเครื่องและทำงานออนไลน์เท่านั้น
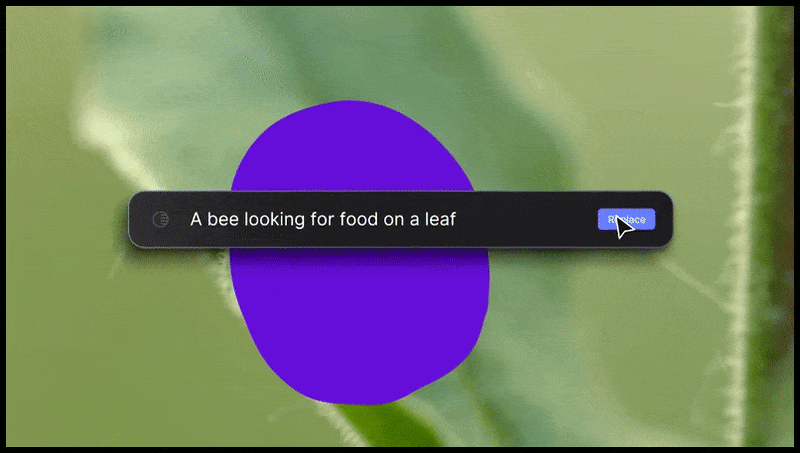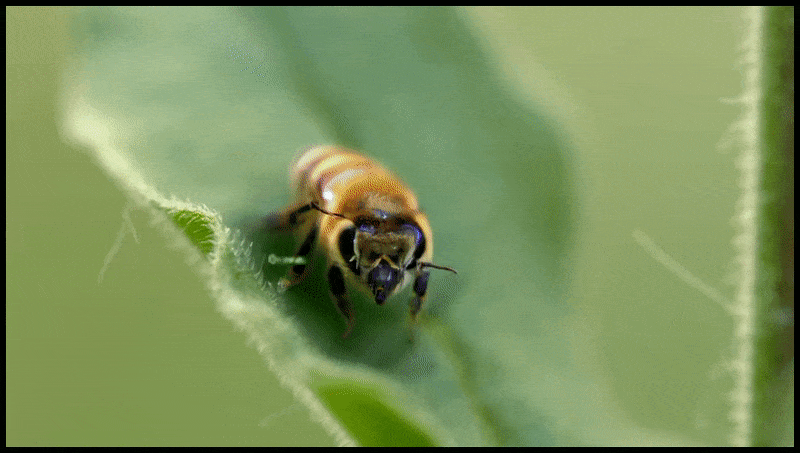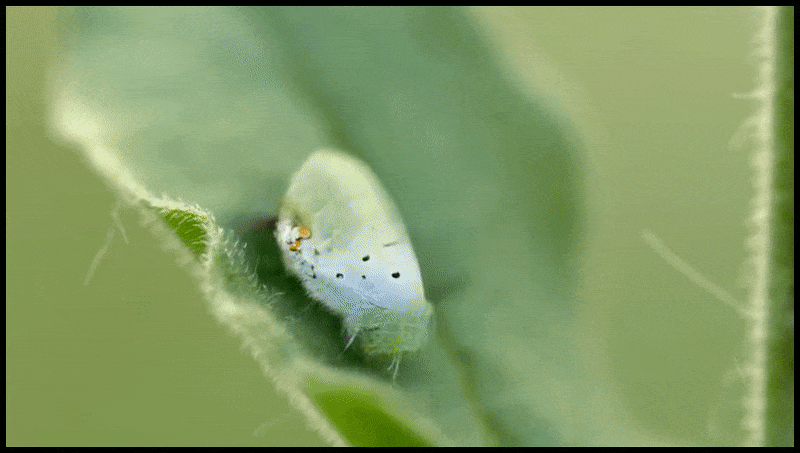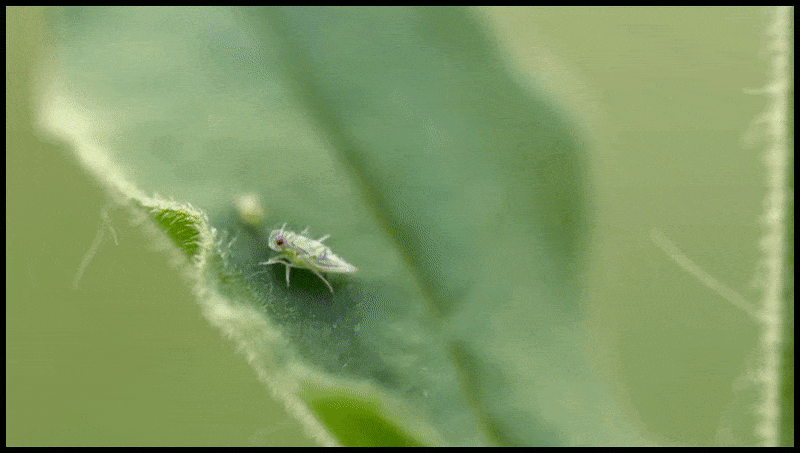
ฟีเจอร์ Erase and Replace ของ Runway ML ที่เคยปรากฏในตัวอย่างระบบแก้ไขข้อความเป็นวิดีโอ
เรามาดูการเปิดตัวของ Runway ก่อนกัน
Erase and Replace
เช่นเดียวกับ Imagic Erase and Replace ทำงานเฉพาะกับภาพนิ่ง แม้ว่า Runway จะได้ แสดงตัวอย่าง ฟังก์ชันเดียวกันในระบบแก้ไขข้อความเป็นวิดีโอที่ยังไม่ได้เปิดตัว
แม้ว่าใครก็สามารถทดสอบ Erase and Replace บนภาพได้ แต่เวอร์ชันวิดีโอยังไม่เปิดให้สาธารณะ แหล่งที่มา: https://twitter.com/runwayml/status/1568220303808991232
แม้ว่า Runway ML จะไม่ได้เปิดเผยรายละเอียดของเทคโนโลยีเบื้องหลัง Erase and Replace ความเร็วที่คุณสามารถแทนที่ต้นไม้ในบ้านด้วยรูปปั้นครึ่งตัวของ Ronald Reagan ที่ค่อนข้างสมจริงบ่งบอกว่าโมเดลการกระจายเช่น Stable Diffusion (หรือ DALL‑E 2 ที่ได้รับอนุญาตให้ใช้งาน ซึ่งมีความเป็นไปได้น้อยกว่ามาก) เป็นเครื่องยนต์ที่ทำการสร้างวัตถุใหม่ตามที่คุณเลือกใน Erase and Replace

การแทนที่ต้นไม้ในบ้านด้วยรูปปั้นครึ่งตัวของ The Gipper ไม่เร็วเท่านี้ แต่ก็เร็วพอสมควร แหล่งที่มา: https://app.runwayml.com/
ระบบมีข้อจำกัดแบบ DALL‑E 2 – ภาพหรือข้อความที่ทำให้ตัวกรอง Erase and Replace ทำงานจะทำให้ระบบแจ้งเตือนว่าบัญชีอาจถูกระงับหากมีการละเมิดต่อเนื่อง – ซึ่งคล้ายกับข้อความเตือนมาตรฐานของ นโยบาย DALL‑E 2 ของ OpenAI
ผลลัพธ์หลายอย่างไม่มีความไม่เรียบร้อยแบบทั่วไปของ Stable Diffusion Runway ML เป็นนักลงทุนและ พันธมิตรวิจัย ของ SD และอาจได้ฝึกโมเดลที่เป็นกรรมสิทธิ์ซึ่งเหนือกว่าน้ำหนักเช็กพอยต์โอเพนซอร์สเวอร์ชัน 1.4 ที่พวกเราคนอื่นกำลังพยายามใช้งานอยู่ โดยกลุ่มพัฒนาทั้งมือสมัครเล่นและมืออาชีพอีกมากก็กำลังฝึกหรือปรับจูน Stable Diffusion เช่นกัน
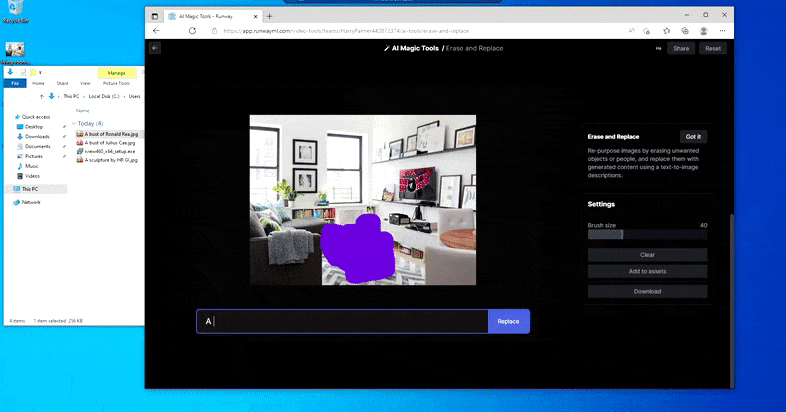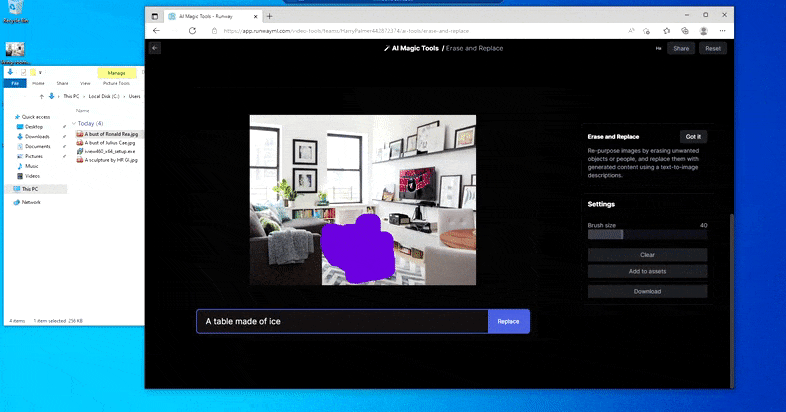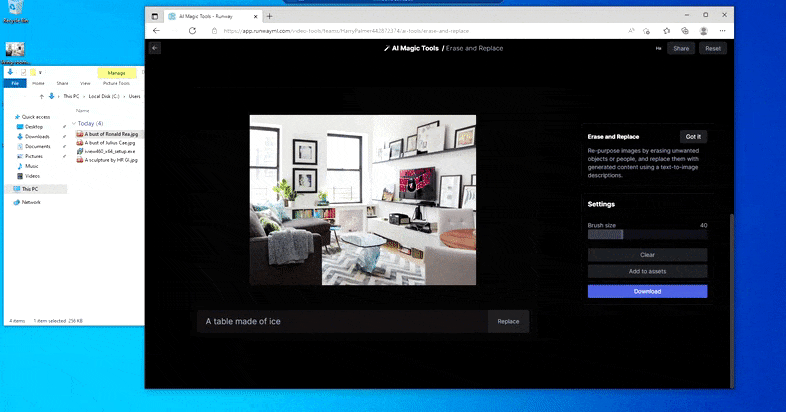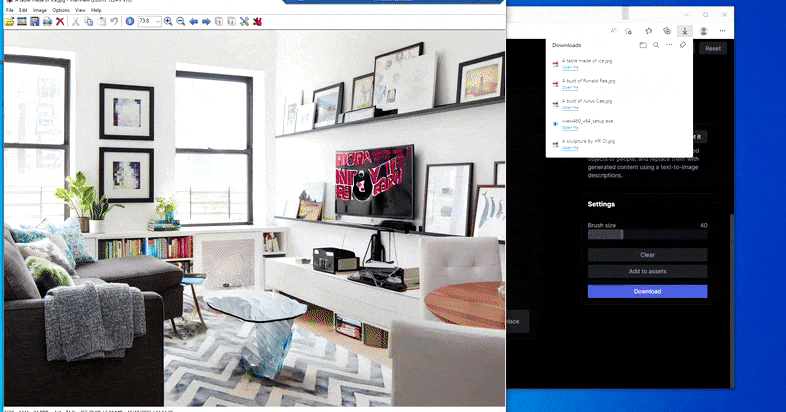
การแทนที่โต๊ะบ้านธรรมดาด้วย “โต๊ะทำจากน้ำแข็ง” ใน Erase and Replace ของ Runway ML
เช่นเดียวกับ Imagic (ดูด้านล่าง) Erase and Replace เป็นระบบ “มุ่งเน้นวัตถุ” – คุณไม่สามารถลบส่วน “ว่าง” ของภาพแล้วเติมด้วยผลลัพธ์จากข้อความของคุณได้; ในกรณีนั้นระบบจะตามหาออบเจกต์ที่ใกล้ที่สุดตามเส้นมาสก์ (เช่น ผนังหรือโทรทัศน์) แล้วทำการแปลงที่นั่น
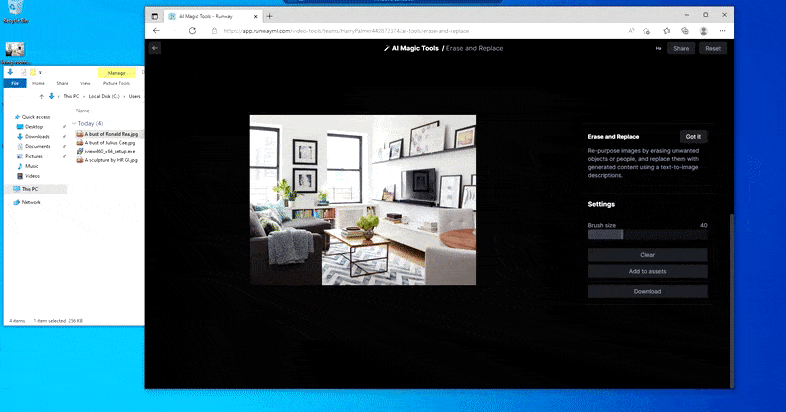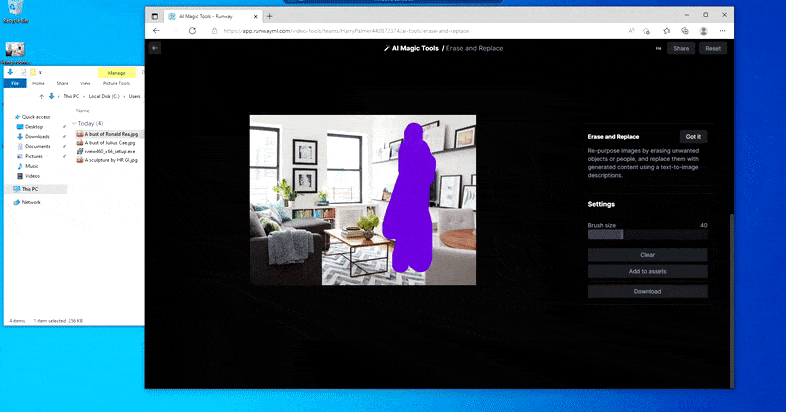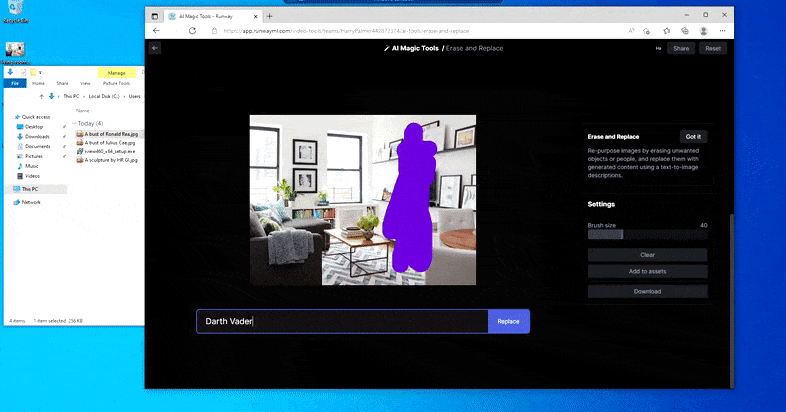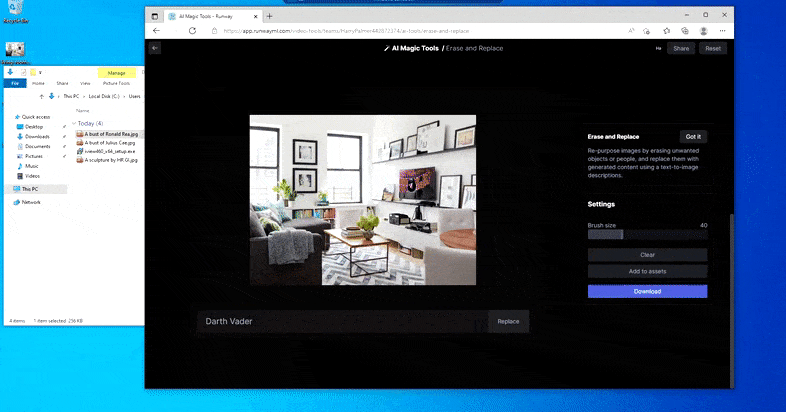
ตามชื่อบ่งบอกว่าไม่สามารถใส่วัตถุลงในพื้นที่ว่างใน Erase and Replace ได้ ที่นี่การพยายามเรียก Darth Vader ทำให้เกิดภาพจิตรกรรมบนทีวีที่ดูแปลกประหลาดในบริเวณที่กำหนดให้ “replace”
ยากที่จะบอกว่า Erase and Replace พยายามหลีกเลี่ยงการใช้ภาพที่มีลิขสิทธิ์ (ซึ่งส่วนใหญ่ยังถูกบล็อกใน DALL‑E 2 แม้จะสำเร็จไม่สม่ำเสมอ) หรือว่าโมเดลเบื้องหลังไม่เหมาะกับงานประเภทนี้

ภาพ “Mural of Nicole Kidman” ที่ค่อนข้าง NSFW บ่งชี้ว่าโมเดลที่คาดว่าใช้การกระจายไม่มีการปฏิเสธอัตโนมัติแบบเดิมของ DALL‑E 2 ต่อใบหน้าที่สมจริงหรือเนื้อหาที่ลามก ในขณะที่การพยายามสร้างผลงานที่มีลิขสิทธิ์ให้ผลลัพธ์ตั้งแต่ไม่ชัดเจน (“xenomorph”) จนถึงตลกขบขัน (“the iron throne”) ส่วนภาพต้นทางอยู่ด้านล่างขวา
จะเป็นเรื่องน่าสนใจหากทราบว่า Erase and Replace ใช้วิธีใดในการแยกวัตถุที่สามารถแทนที่ได้ คาดว่าภาพจะถูกประมวลผลผ่านรุ่นหนึ่งของ CLIP โดยออบเจกต์จะถูกจำแนกด้วยการรู้จำวัตถุและการแบ่งส่วนเชิงความหมาย การติดตั้ง Stable Diffusion แบบทั่วไปยังทำงานเหล่านี้ได้ไม่ใกล้เคียงกับระบบนี้
แต่ไม่มีอะไรที่สมบูรณ์แบบ – บางครั้งระบบดูเหมือนจะลบแล้วไม่แทนที่ แม้ว่าเมคานิซึมการเรนเดอร์พื้นฐานจะเข้าใจความหมายของข้อความอย่างชัดเจน ในกรณีนี้จึงไม่สามารถเปลี่ยนโต๊ะกาแฟให้กลายเป็น xenomorph ได้ – โต๊ะจะหายไปเลย
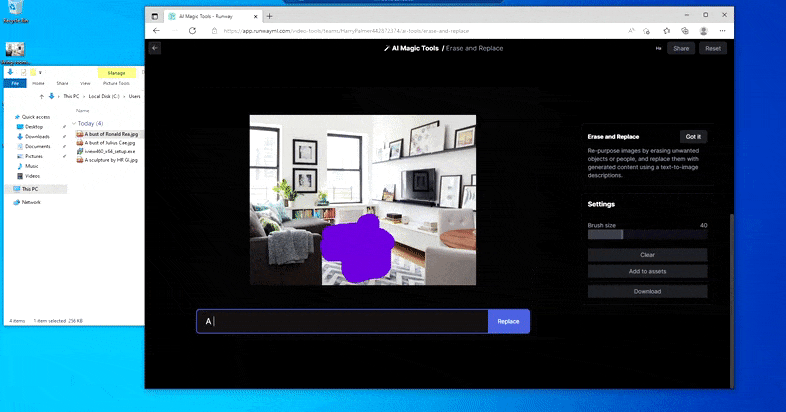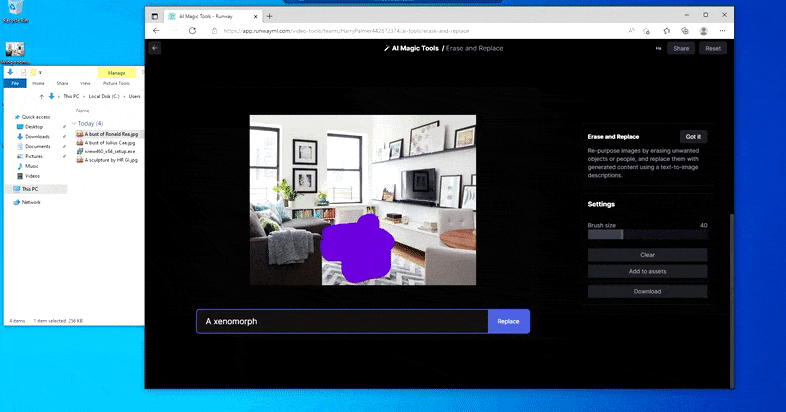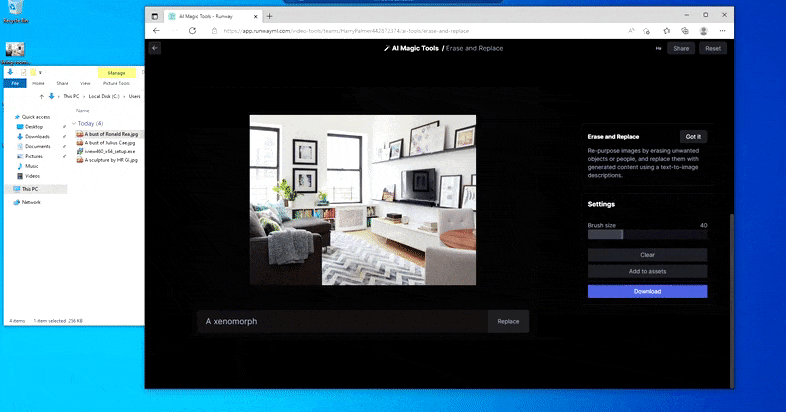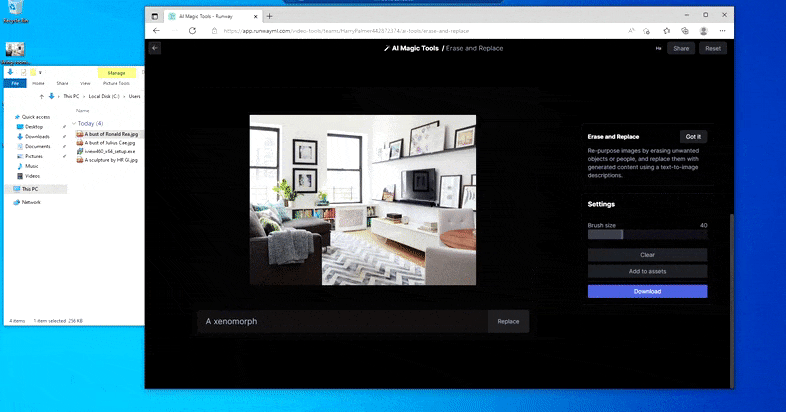
เวอร์ชันที่น่ากลัวกว่า “Where’s Waldo” เนื่องจาก Erase and Replace ไม่สามารถสร้างเอเลี่ยนได้
Erase and Replace ดูเหมือนจะเป็นระบบการแทนที่วัตถุที่มีประสิทธิภาพพร้อมการเติมเต็มบริเวณภาพที่ยอดเยี่ยม อย่างไรก็ตาม มันไม่สามารถแก้ไขวัตถุที่มีอยู่แล้วได้ เพียงแค่แทนที่เท่านั้น การเปลี่ยนแปลงเนื้อหาภาพที่มีอยู่โดยไม่ทำลายวัสดุโดยรอบเป็นงานที่ยากกว่ามาก ซึ่งเกี่ยวข้องกับการวิจัยด้านคอมพิวเตอร์วิชันเพื่อบรรลุ การแยกแยะใน latent space ของกรอบงานยอดนิยมต่าง ๆ
Imagic
นี่คือภารกิจที่ Imagic ตั้งเป้าไว้ งานวิจัยใหม่ แสดงตัวอย่างการแก้ไขหลายรูปแบบที่สามารถปรับเปลี่ยนส่วนย่อยของภาพได้โดยไม่กระทบส่วนอื่น

ใน Imagic ภาพที่แก้ไขแล้วไม่แสดงอาการบิดเบือนการยืด หรือการคาดเดาบริเวณที่ถูกบังแบบการเชิดภาพ deepfake ที่อาศัยข้อมูลจำกัดจากภาพเดียว
ระบบใช้กระบวนการสามขั้นตอน – การปรับแต่งการฝังข้อความ; การปรับจูนโมเดล; และสุดท้ายคือการสร้างภาพที่แก้ไขแล้ว

Imagic เข้ารหัสข้อความเป้าหมายเพื่อดึงการฝังข้อความเริ่มต้น แล้วทำการปรับผลลัพธ์เพื่อให้ได้ภาพอินพุต หลังจากนั้นโมเดลกำเนิดจะถูกปรับจูนให้ตรงกับภาพต้นฉบับโดยเพิ่มพารามิเตอร์หลายค่า ก่อนทำการแทรกเชิงเส้นตามที่ร้องขอ
ไม่แปลกใจที่กรอบงานนี้อิงบนสถาปัตยกรรมข้อความเป็นวิดีโอ Imagen ของ Google แม้ว่านักวิจัยจะระบุว่าหลักการของระบบสามารถนำไปใช้กับโมเดลการกระจาย latent ได้อย่างกว้างขวาง
Imagen ใช้สถาปัตยกรรมสามชั้น แทนการใช้สถาปัตยกรรมเจ็ดชั้นที่ใช้ในรุ่น text‑to‑video ล่าสุดของบริษัท โมดูลสามส่วนประกอบด้วย โมเดลการกระจายที่ทำงานที่ความละเอียด 64×64 พิกเซล; โมเดลซูเปอร์เรโซลูชันที่ขยายผลลัพธ์เป็น 256×256 พิกเซล; และโมเดลซูเปอร์เรโซลูชันเพิ่มเติมเพื่อขยายเป็น 1024×1024 พิกเซล
Imagic แทรกแซงในขั้นตอนแรกของกระบวนการนี้ โดยทำการปรับแต่งการฝังข้อความที่ร้องขอที่ระดับ 64 พิกเซลด้วย Adam optimizer ที่อัตราการเรียนรู้คงที่ 0.0001

ตัวอย่างการแยกแยะขั้นสูง – ผู้ใช้ที่เคยพยายามเปลี่ยนสีของวัตถุที่เรนเดอร์ในโมเดล diffusion, GAN หรือ NeRF จะเข้าใจว่าการที่ Imagic ทำการแปลงโดยไม่ทำลายความสอดคล้องของภาพส่วนอื่นเป็นเรื่องสำคัญแค่ไหน
การปรับจูนดำเนินต่อบนโมเดลฐานของ Imagen จำนวน 1500 ขั้นตอนต่อภาพอินพุต โดยอิงกับการฝังข้อความที่ปรับแล้ว พร้อมกันนั้นชั้น 64→256 พิกเซลที่สองก็ได้รับการปรับจูนในแบบขนานบนภาพที่มีเงื่อนไข นักวิจัยสังเกตว่าการปรับจูนชั้นสุดท้าย 256→1024 พิกเซลให้ผลกระทบ “ไม่มีหรือมีน้อยมาก” ต่อผลลัพธ์สุดท้าย จึงไม่ได้ดำเนินการ
งานวิจัยระบุว่ากระบวนการปรับจูนใช้เวลาประมาณแปดนาทีต่อภาพบนชิป TPU V4 สองตัว สุดท้ายการเรนเดอร์ทำในแกน Imagen ภายใต้ โครงร่างการสุ่มตัวอย่าง DDIM
เช่นเดียวกับกระบวนการปรับจูนของ DreamBooth ของ Google การฝังที่ได้สามารถใช้เพื่อสไตลิซ์ หรือทำการแก้ไขภาพถ่ายที่มีความเป็นจริงสูงโดยดึงข้อมูลจากฐานข้อมูลกว้างของ Imagen (เนื่องจากคอลัมน์แรกด้านล่างแสดงว่าภาพต้นทางไม่มีเนื้อหาที่จำเป็นสำหรับการแปลงเหล่านี้)

Imagic สามารถสร้างการเคลื่อนไหวและการแก้ไขภาพถ่ายที่ยืดหยุ่นได้ ในขณะที่โค้ดที่แยกและแยกส่วนที่ได้จากกระบวนการสามารถนำไปใช้สร้างผลลัพธ์แบบสไตลิซ์ได้เช่นกัน
นักวิจัยเปรียบเทียบ Imagic กับงานก่อนหน้า SDEdit ซึ่งเป็นวิธีการแบบ GAN จากปี 2021 ที่ร่วมมือระหว่าง Stanford University และ Carnegie Mellon University; และ Text2Live ซึ่งเป็นความร่วมมือระหว่าง Weizmann Institute of Science กับ NVIDIA ในเดือนเมษายน 2022

การเปรียบเทียบภาพระหว่าง Imagic, SDEdit และ Text2Live
เห็นได้ชัดว่าแนวทางก่อนหน้ายังประสบปัญหา แต่ในแถวล่างซึ่งต้องเปลี่ยนท่าทางอย่างมาก ตัวเลือกเดิมล้มเหลวอย่างสิ้นเชิงในการสร้างใหม่จากข้อมูลต้นฉบับ ในขณะที่ Imagic ประสบความสำเร็จอย่างโดดเด่น
ข้อกำหนดด้านทรัพยากรและระยะเวลาการฝึกของ Imagic ต่อภาพ แม้จะสั้นเมื่อเทียบกับมาตรฐานของการวิจัยเช่นนี้ แต่ก็ทำให้ยากต่อการนำไปใช้ในแอปพลิเคชันแก้ไขภาพบนคอมพิวเตอร์ส่วนบุคคล – และยังไม่ชัดเจนว่ากระบวนการปรับจูนจะสามารถย่อขนาดลงสู่ระดับผู้บริโภคได้หรือไม่
ในปัจจุบัน Imagic เป็นข้อเสนอที่น่าประทับใจและเหมาะกับการใช้งานผ่าน API – สภาพแวดล้อมที่ Google Research ซึ่งระมัดระวังต่อการวิพากษ์วิจารณ์เกี่ยวกับการสนับสนุนการทำ deepfake อาจจะเป็นสภาพแวดล้อมที่พวกเขาสบายใจที่สุด
เผยแพร่ครั้งแรก 18 ตุลาคม 2022.


