
Prompt engineering
การทำความเข้าใจการปรับแต่ง LLM: ปรับโมเดลภาษาขนาดใหญ่ให้เหมาะสมกับความต้องการของคุณ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

ประเด็นสำคัญการปรับแต่งปรับโมเดลขนาดใหญ่ให้เหมาะกับงานเฉพาะโดยใช้ข้อมูลน้อยกว่าการฝึกก่อนหน้าอย่างมา…
ดูเพิ่มเติม
- การปรับแต่งปรับโมเดลขนาดใหญ่ให้เหมาะกับงานเฉพาะโดยใช้ข้อมูลน้อยกว่าการฝึกก่อนหน้าอย่างมาก
- QLoRA ผสานการควอนไทซ์กับการปรับแบบต่ำอันดับเพื่อลดความต้องการหน่วยความจำสำหรับการปรับแต่งอย่างมาก
- การเรียนรู้แบบเสริมแรงจากข้อเสนอแนะมนุษย์ปรับเอาต์พุตโมเดลให้สอดคล้องกับความชอบและค่านิยมอันละเอียดอ่อนของมนุษย์
ณ เดือนกันยายน 2023 ภูมิทัศน์ของโมเดลภาษาขนาดใหญ่ (LLM) ยังคงเห็นโมเดลที่เพิ่มขึ้น รวมถึง Alpaca, Falcon, Llama 2, GPT-4 และอื่นๆ
ด้านหนึ่งที่สำคัญของการนำโมเดล LLM ไปใช้คือกระบวนการปรับแต่ง ซึ่งเป็นกลยุทธ์ที่ช่วยให้สามารถปรับโมเดลที่ได้รับการฝึกฝนมาแล้วให้เหมาะสมกับงานเฉพาะด้วยความแม่นยำ มันเป็นกระบวนการปรับแต่งที่ช่วยให้โมเดลสามารถตอบสนองความต้องการที่หลากหลายและให้ผลลัพธ์ที่เป็นนวัตกรรมและเหมาะสมกับความต้องการเฉพาะ

อย่างไรก็ตาม สิ่งสำคัญที่ต้องทราบคือ ไม่ใช่วิธีการปรับแต่งทั้งหมดมีคุณภาพเท่ากัน ตัวอย่างเช่น การเข้าถึงความสามารถในการปรับแต่งของ GPT-4 ต้องใช้การสมัครสมาชิกที่มีค่าใช้จ่ายสูงกว่าตัวเลือกอื่นๆ ในตลาด ในทางกลับกัน โดเมนโอเพ่นซอร์สเต็มไปด้วยตัวเลือกที่ให้ทางเลือกที่เข้าถึงได้ง่ายขึ้นในการใช้พลังของโมเดลภาษาขนาดใหญ่ ตัวเลือกโอเพ่นซอร์สเหล่านี้ทำให้สามารถเข้าถึงเทคโนโลยี AI ที่ทันสมัยได้ และส่งเสริมนวัตกรรมและความครอบคลุมในภูมิทัศน์ AI ที่กำลังพัฒนา

ทำไมการปรับแต่ง LLM จึงสำคัญ?
การปรับแต่ง LLM ไม่ใช่แค่การปรับปรุงเทคนิค แต่เป็นส่วนสำคัญของการพัฒนาโมเดล LLM ที่ช่วยให้สามารถใช้งานได้เฉพาะเจาะจงและแม่นยำยิ่งขึ้น การปรับแต่งช่วยให้โมเดลที่ได้รับการฝึกฝนมาแล้วสามารถปรับให้เหมาะสมกับชุดข้อมูลเฉพาะและเพิ่มประสิทธิภาพในการทำงานเฉพาะ นอกจากนี้ยังช่วยให้โมเดลสามารถปรับตัวเข้ากับข้อมูลใหม่ได้ และแสดงให้เห็นถึงความสามารถในการปรับตัวที่สำคัญในด้านการประยุกต์ใช้ AI
การปรับแต่งโมเดลภาษาขนาดใหญ่ทำให้เกิดโอกาสมากมาย โดยช่วยให้สามารถทำงานได้ดีในงานเฉพาะต่างๆ ตั้งแต่วิเคราะห์ความรู้สึกไปจนถึงการตรวจสอบเอกสารทางการแพทย์ โดยการปรับแต่งโมเดลให้เหมาะสมกับกรณีการใช้งานเฉพาะ เราสามารถปลดปล่อยโอกาสใหม่ๆ และเพิ่มประสิทธิภาพและความแม่นยำของโมเดล นอกจากนี้ยังช่วยให้สามารถใช้ทรัพยากรระบบได้อย่างมีประสิทธิภาพมากขึ้น เนื่องจากการปรับแต่งต้องการพลังการคำนวณน้อยกว่าการฝึกโมเดลจากศูนย์
เมื่อเราลงลึกเข้าไปในคู่มือนี้ เราจะพูดถึงรายละเอียดของการปรับแต่ง LLM โดยให้ภาพรวมที่ครอบคลุมตามความก้าวหน้าและแนวปฏิบัติที่ดีที่สุดในด้านนี้
การปรับแต่งโดยอาศัยคำแนะนำ
ช่วงการปรับแต่งในวงจรชีวิตของ AI เชิงกำเนิด ตามภาพด้านล่าง ประกอบด้วยอินพุตคำสั่งและเอาต์พุต ร่วมกับตัวอย่างการให้เหตุผลทีละขั้น ช่วยให้โมเดลสร้างคำตอบที่เกี่ยวข้องและตรงกับคำสั่งเฉพาะที่ป้อนเข้ามา ในช่วงนี้ โมเดลที่ฝึกมาล่วงหน้าจะถูกปรับให้แก้งานและกรณีใช้งานเฉพาะ โดยใช้ชุดข้อมูลที่ปรับตามความต้องการเพื่อเพิ่มความสามารถ

วงจรชีวิต AI เชิงกำเนิด — การปรับแต่ง
การปรับแต่งสำหรับงานเดียว
การปรับแต่งสำหรับงานเดียวมุ่งเน้นไปที่การปรับปรุงความเชี่ยวชาญของโมเดลในงานเฉพาะ เช่น การสรุปผล การปรับแต่งนี้มีประโยชน์อย่างมากในการเพิ่มประสิทธิภาพการทำงานที่เกี่ยวข้องกับเอกสารหรือสนทนาขนาดใหญ่ รวมถึงเอกสารทางกฎหมายและคำร้องขอความช่วยเหลือจากลูกค้า นอกจากนี้การปรับแต่งนี้สามารถบรรลุผลลัพธ์ที่ดีได้ด้วยตัวอย่างที่ค่อนข้างน้อย ตั้งแต่ 500 ถึง 1,000 ตัวอย่าง ต่างจากโทเค็นหลายพันล้านรายการที่ใช้ในการฝึกเบื้องต้น

ภาพตัวอย่างการปรับแต่งสำหรับงานเดียว
รากฐานของการปรับแต่ง LLM: สถาปัตยกรรม Transformer และอื่นๆ
การเดินทางในการทำความเข้าใจการปรับแต่ง LLM เริ่มต้นด้วยการทำความเข้าใจองค์ประกอบพื้นฐานที่ทำให้เกิด LLM ใจกลางของโมเดลเหล่านี้คือ สถาปัตยกรรม Transformer ซึ่งเป็นเครือข่ายประสาทเทียมที่ใช้กลไกความสนใจในตนเอง (self-attention)เพื่อจัดลำดับความสำคัญของบริบทของคำมากกว่าระยะห่างของคำในประโยค แนวทางนี้ช่วยให้เข้าใจความสัมพันธ์ระหว่างโทเค็นที่อยู่ห่างกันในอินพุตได้ลึกซึ้งขึ้น
เมื่อเรานำทางผ่านความซับซ้อนของ Transformer เราจะพบกระบวนการที่มีหลายขั้นตอน ซึ่งเริ่มต้นด้วยการเข้ารหัส โดยที่อินพุตถูกแบ่งเป็นโทเค็นและสร้างเวกเตอร์ฝังตัวเพื่อแทนอินพุตและตำแหน่งในประโยค ต่อจากนั้นจะมีการคำนวณโดยใช้เมทริกซ์ที่เรียกว่า Query, Value และ Key ซึ่งส่งผลให้ได้คะแนนความสนใจในตนเองที่กำหนดการมุ่งเน้นไปที่ส่วนต่างๆ ของประโยคและโทเค็นต่างๆ

สถาปัตยกรรมทรานส์ฟอร์เมอร์
การปรับแต่งเป็นขั้นตอนที่สำคัญในการพัฒนา LLM ซึ่งเกี่ยวข้องกับการปรับเปลี่ยนอย่างละเอียดเพื่อให้ได้ผลลัพธ์ที่ต้องการ ขั้นตอนนี้แม้จะจำเป็น แต่ก็ยังนำเสนอความท้าทาย รวมถึงความต้องการด้านการคำนวณและจัดเก็บที่สูงในการจัดการจำนวนพารามิเตอร์ที่มาก การปรับแต่งที่มีประสิทธิภาพต่อพารามิเตอร์ (PEFT) เสนอวิธีการเพื่อลดจำนวนพารามิเตอร์ที่ต้องปรับแต่ง ทำให้กระบวนการฝึกอบรมง่ายขึ้น
การฝึกฝน LLM ก่อนการปรับแต่ง: การสร้างฐานที่แข็งแกร่ง
ในช่วงแรกของการพัฒนา LLM การฝึกฝนก่อนการปรับแต่งมีบทบาทสำคัญ โดยใช้ Transformer ที่มีพารามิเตอร์มากเป็นสถาปัตยกรรมพื้นฐาน การฝึกนี้เกี่ยวข้องกับการสร้างแบบจำลองภาษาธรรมชาติในหลายรูปแบบ เช่น แบบสองทิศทาง แบบถดถอยอัตโนมัติ (autoregressive) หรือแบบลำดับต่อลำดับ บนข้อมูลที่ไม่มีการกำกับดูแลขนาดใหญ่ วัตถุประสงค์หลักคือการสร้างฐานที่สามารถปรับแต่งได้สำหรับงานเฉพาะในภายหลังผ่านการแนะนำวัตถุประสงค์เฉพาะงาน

การฝึกเบื้องต้นและการปรับแต่ง
แนวโน้มที่น่าสังเกตในด้านนี้คือการเพิ่มขึ้นของขนาดของ LLM ที่ฝึกฝนก่อนการปรับแต่ง ซึ่งวัดจากจำนวนพารามิเตอร์ ข้อมูลเชิงประจักษ์แสดงให้เห็นอย่างต่อเนื่องว่าโมเดลที่ใหญ่ขึ้นพร้อมกับข้อมูลที่มากขึ้นเกือบจะเสมอไปที่จะให้ผลการทำงานที่ดีกว่า ตัวอย่างเช่น GPT-3 ซึ่งมีพารามิเตอร์ 175 พันล้านตัว ได้ตั้งมาตรฐานใหม่ในการสร้างภาษาธรรมชาติที่มีคุณภาพสูงและสามารถทำงานได้ดีในงานแบบ zero-shot ที่ไม่มีตัวอย่างให้ในพรอมป์ต์
การปรับแต่ง: เส้นทางสู่การปรับโมเดล
หลังจากการฝึกฝนก่อนการปรับแต่ง LLM จะผ่านการปรับแต่งเพื่อปรับตัวให้เข้ากับงานเฉพาะ แม้ว่าการเรียนรู้ในบริบทใน LLM ที่ฝึกฝนก่อนการปรับแต่ง เช่น GPT-3 จะแสดงผลการทำงานที่น่าสนใจในงานแบบ zero-shot ที่ไม่มีตัวอย่างให้ในพรอมป์ต์ การปรับแต่งยังคงเป็นวิธีที่ดีกว่าในสถานการณ์ที่เฉพาะเจาะจง อย่างไรก็ตาม วิธีการปรับแต่งพารามิเตอร์ทั้งหมดที่ใช้กันทั่วไปนำเสนอความท้าทาย รวมถึงความต้องการด้านการคำนวณและหน่วยความจำสูง โดยเฉพาะอย่างยิ่งเมื่อจัดการกับโมเดลขนาดใหญ่
สำหรับโมเดลภาษาขนาดใหญ่ที่มีพารามิเตอร์มากกว่า 1 พันล้านตัว การจัดการหน่วยความจำ GPU อย่างมีประสิทธิภาพเป็นสิ่งสำคัญ พารามิเตอร์โมเดลเดียวที่มีความแม่นยำ 32 บิตต้องใช้พื้นที่ 4 บายต์ ซึ่งหมายความว่าต้องใช้พื้นที่ 4GB ของหน่วยความจำ GPU เพียงเพื่อโหลดโมเดลที่มีพารามิเตอร์ 1 พันล้านตัว กระบวนการฝึกอบรมต้องการหน่วยความจำมากขึ้นเพื่อจัดเก็บส่วนประกอบต่างๆ เช่น สเตตของออปติมายเซอร์และเกรเดียนต์ ซึ่งอาจต้องใช้หน่วยความจำ GPU ถึง 80GB สำหรับโมเดลขนาดนี้
เพื่อจัดการกับข้อจำกัดของหน่วยความจำ GPU จะใช้เทคนิคการควอนไทซ์ ซึ่งเป็นการลดความแม่นยำของพารามิเตอร์โมเดล ทำให้ต้องการพื้นที่จัดเก็บน้อยลง ตัวอย่างเช่น การเปลี่ยนความแม่นยำจาก 32 บิตเป็น 16 บิตสามารถลดความต้องการหน่วยความจำลงได้ครึ่งหนึ่งสำหรับการโหลดและฝึกอบรมโมเดล ต่อไปในบทความนี้จะกล่าวถึง QLoRA ซึ่งใช้แนวคิดการควอนไทซ์ในการปรับแต่ง

หน่วยความจำ GPU ที่ LLM ต้องใช้ตามจำนวนพารามิเตอร์และความแม่นยำ
การสำรวจหมวดหมู่ของวิธีการ PEFT

ในการปรับแต่ง LLM อย่างเต็มที่ สิ่งสำคัญคือต้องมีการตั้งค่าคำนวณที่สามารถจัดการน้ำหนักโมเดลที่มีขนาดใหญ่ซึ่งสำหรับโมเดลที่ทันสมัยที่สุดขณะนี้มีขนาดหลายร้อยกิกะไบต์ นอกจากนี้ยังต้องจัดการส่วนประกอบสำคัญอื่นๆ เช่น การจัดสรรหน่วยความจำสำหรับสเตตของออปติมายเซอร์ การจัดการเกรเดียนต์ ค่าการกระตุ้นระหว่างการคำนวณไปข้างหน้า และการจัดการหน่วยความจำชั่วคราวในช่วงต่างๆ ของกระบวนการฝึกอบรม
วิธีการเสริม
ประเภทของการปรับแต่งนี้สามารถเพิ่มพารามิเตอร์หรือชั้นเพิ่มเติมเข้าไปในโมเดลที่ได้รับการฝึกฝนมาแล้ว โดยมุ่งเน้นไปที่การฝึกพารามิเตอร์ที่เพิ่มใหม่เท่านั้น แม้ว่าจะเพิ่มจำนวนพารามิเตอร์ แต่วิธีการนี้สามารถปรับปรุงเวลาและพื้นที่ในการฝึกอบรมได้ วิธีการเสริมสามารถแบ่งออกเป็นหมวดหมู่ย่อยๆ ได้ดังนี้
- อแดปเตอร์: เพิ่มโครงข่ายที่เชื่อมต่อครบทุกหน่วยขนาดเล็กไว้หลังชั้นย่อยของทรานส์ฟอร์เมอร์ โดยมีตัวอย่างที่น่าสังเกต เช่น AdaMix, KronA และ Compactor
- โปรมป์ตแบบอ่อน: การปรับแต่งส่วนหนึ่งของเวกเตอร์ฝังตัวของอินพุตโมเดลด้วยวิธีลดระดับตามเกรเดียนต์ โดยมีตัวอย่างที่โดดเด่น เช่น IPT, prefix-tuning และ WARP
- วิธีการเสริมอื่นๆ: รวมถึงเทคนิค เช่น LeTS, AttentionFusion และ Ladder-Side Tuning
วิธีการเลือก
วิธีการ PEFT ที่เลือกสามารถปรับแต่งชั้นบนสุดจำนวนจำกัดตามประเภทชั้นและโครงสร้างภายในของโมเดล วิธีการนี้รวมถึงวิธีการ เช่น BitFit และ LN tuning ซึ่งมุ่งเน้นไปที่การปรับแต่งองค์ประกอบเฉพาะ เช่น ความเอนเอียงของโมเดลหรือแถวเฉพาะ
วิธีการที่อิงการปรับพารามิเตอร์
วิธีการเหล่านี้ใช้การแทนค่าอันดับต่ำเพื่อลดจำนวนพารามิเตอร์ที่สามารถฝึกอบรมได้ โดยที่วิธีการที่มีชื่อเสียงที่สุดคือการปรับแต่งอันดับต่ำหรือ LoRA ซึ่งใช้การแยกตัวประกอบเมทริกซ์อันดับต่ำเพื่อแสดงการอัปเดตน้ำหนัก โดยแสดงให้เห็นถึงการปรับแต่งที่มีประสิทธิภาพในปริภูมิย่อยอันดับต่ำ
1) LoRA (การปรับแต่งอันดับต่ำ)
LoRA เป็นวิธีการ PEFT ที่เป็นที่รู้จัก ซึ่งถูกนำเสนอในเอกสารโดย Edward J. Hu และคนอื่นๆ ในปี 2021 มันอยู่ในหมวดหมู่การปรับพารามิเตอร์ โดยการแช่แข็งน้ำหนักเดิมของ LLM และรวมเมทริกซ์ที่สามารถฝึกอบรมได้ขนาดเล็กเข้ากับแต่ละชั้นของสถาปัตยกรรม Transformer วิธีการนี้ไม่เพียงแต่ลดจำนวนพารามิเตอร์ที่สามารถฝึกอบรมได้เท่านั้น แต่ยังลดเวลาในการฝึกอบรมและทรัพยากรการคำนวณที่จำเป็น ทำให้เป็นวิธีการที่มีประสิทธิภาพมากกว่าการปรับแต่งทั้งหมด
เพื่อทำความเข้าใจกลไกของ LoRA เราต้องกลับมาที่สถาปัตยกรรม Transformer โดยที่อินพุตจะถูกแปลงเป็นโทเค็นและเวกเตอร์ฝังตัว จากนั้นเวกเตอร์ผ่านส่วนเข้ารหัสและ/หรือถอดรหัสของทรานส์ฟอร์เมอร์ โดยพบชั้นความสนใจในตนเองและโครงข่ายป้อนไปข้างหน้าซึ่งมีน้ำหนักที่ฝึกไว้แล้ว โดยที่ LoRA ใช้แนวคิดเรื่อง การแยกเมทริกซ์แบบสิงคูลาร์ โดยพื้นฐานแล้ว การแยกเมทริกซ์แบบสิงคูลาร์จะแยกเมทริกซ์ออกเป็นสามเมทริกซ์ที่แตกต่างกัน โดยหนึ่งในนั้นคือเมทริกซ์แนวทแยงซึ่งมีค่าสิงคูลาร์ ค่าสิงคูลาร์เหล่านี้มีความสำคัญเนื่องจากวัดความสำคัญของมิติต่างๆ ในเมทริกซ์ โดยค่าที่ใหญ่กว่าบ่งชี้ถึงความสำคัญที่สูงกว่า และค่าที่น้อยกว่าบ่งชี้ถึงความสำคัญที่น้อยกว่า

การแยกเมทริกซ์แบบสิงคูลาร์ (SVD) ของเมทริกซ์ m × n
วิธีการนี้ช่วยให้ LoRA สามารถรักษาลักษณะสำคัญของข้อมูลได้ขณะลดมิติลง ทำให้กระบวนการปรับแต่งมีประสิทธิภาพมากขึ้น
LoRA เข้ามาแทรกแซงในกระบวนการนี้ โดยการแช่แข็งพารามิเตอร์ของโมเดลเดิมทั้งหมดและเพิ่มคู่ “เมทริกซ์การแยกอันดับ” ข้างๆ น้ำหนักเดิม พารามิเตอร์เหล่านี้ซึ่งแสดงเป็น A และ B จะถูกฝึกผ่านการเรียนรู้แบบมีคำแนะนำ
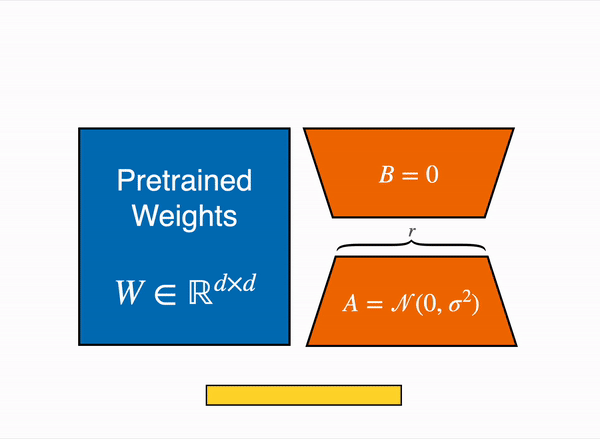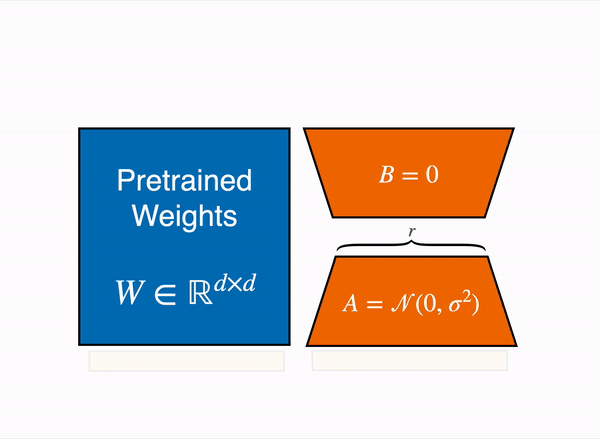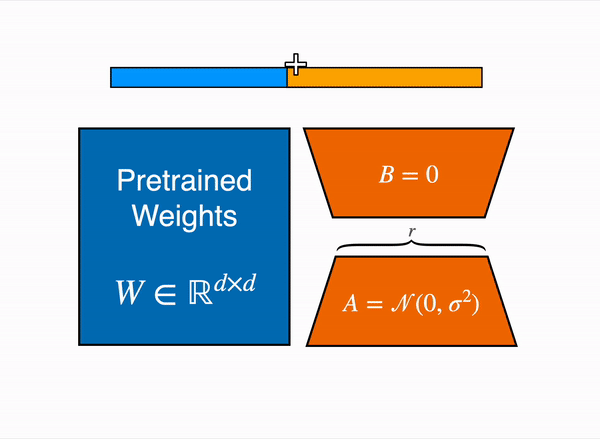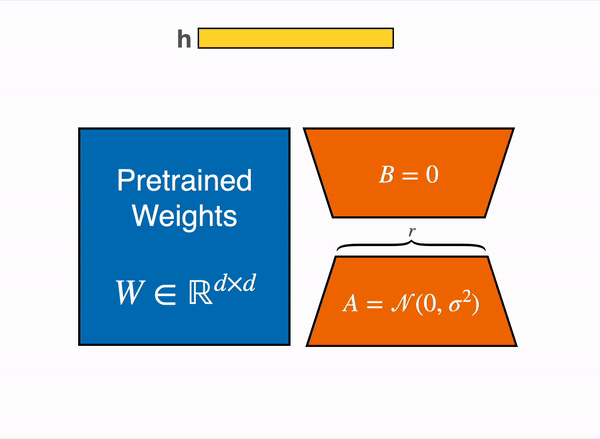
สิ่งสำคัญที่สุดในวิธีการนี้คือพารามิเตอร์ที่เรียกว่า “อันดับ” (‘r’) ซึ่งกำหนดขนาดของเมทริกซ์อันดับต่ำ การเลือก ‘r’ อย่างรอบคอบสามารถให้ผลลัพธ์ที่น่าประทับใจได้ แม้จะใช้ค่าที่น้อย การสร้างเมทริกซ์อันดับต่ำที่มีพารามิเตอร์น้อยกว่าในการฝึกอบรม วิธีการนี้ได้รับการนำไปใช้อย่างมีประสิทธิภาพโดยใช้ไลบรารีโอเพ่นซอร์ส เช่น HuggingFace Transformers ทำให้การปรับแต่ง LoRA สำหรับงานต่างๆ มีประสิทธิภาพ
2) QLoRA: การเพิ่มประสิทธิภาพของ LoRA
QLoRA สร้างบนพื้นฐานของ LoRA โดยผสานการปรับอันดับต่ำกับการควอนไทซ์เพื่อลดความต้องการหน่วยความจำลงอีก โดยนำเสนอโดย Tim Dettmers และคนอื่นๆ ในปี 2023 โดยใช้รูปแบบการควอนไทซ์ 4 บิตที่เรียกว่า NormalFloat หรือ nf4 การควอนไทซ์เป็นกระบวนการที่เปลี่ยนข้อมูลจากการแทนค่าที่มีข้อมูลมากไปเป็นแบบที่มีข้อมูลน้อยกว่า วิธีนี้รักษาประสิทธิภาพของการปรับแต่ง 16 บิต โดยแปลงน้ำหนักที่ควอนไทซ์เป็น 4 บิตกลับเป็น 16 บิตเมื่อจำเป็นระหว่างการคำนวณ
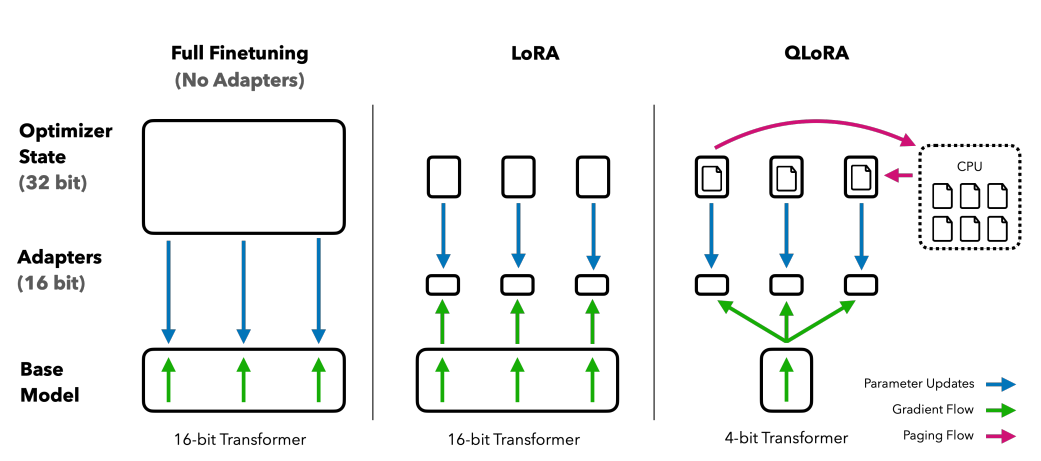
การเปรียบเทียบวิธีการปรับแต่ง: QLORA เพิ่ม LoRA ด้วยการควอนไทซ์ 4 บิตและออปติมายเซอร์แบบเพจสำหรับการจัดการจุดสูงสุดของหน่วยความจำ
QLoRA ใช้ NumericFloat4 (nf4) โดยมุ่งเป้าไปที่ทุกชั้นของสถาปัตยกรรม Transformer และแนะนำแนวคิดเรื่องการควอนไทซ์แบบสองชั้นเพื่อลดขนาดหน่วยความจำที่ใช้ที่จำเป็นในการปรับแต่งอีกครั้ง โดยการควอนไทซ์บนค่าคงที่ที่ควอนไทซ์แล้ว ซึ่งเป็นกลยุทธ์ที่หลีกเลี่ยงการเพิ่มหน่วยความจำแบบจุดสูงสุดของการเช็คพอยต์ของเกรเดียนต์ผ่านการใช้ออปติมายเซอร์แบบเพจและจัดการหน่วยความจำแบบรวม
Guanaco ซึ่งเป็นโมเดลที่ปรับแต่งด้วย QLORA เป็นตัวอย่างที่มีประสิทธิภาพสูงในโซลูชันแชตบอทโอเพ่นซอร์ส ประสิทธิภาพของมันซึ่งได้รับการยืนยันผ่านการประเมินของมนุษย์และอัตโนมัติแสดงให้เห็นถึงความเป็นเลิศและประสิทธิภาพในด้านนี้
รุ่น 65B และ 33B ของ Guanaco ซึ่งปรับแต่งโดยใช้เวอร์ชันที่แก้ไขของ ชุดข้อมูล OASST1 เป็นตัวเลือกที่แข็งแกร่งเมื่อเทียบกับโมเดลที่มีชื่อเสียง เช่น ChatGPT และแม้กระทั่ง GPT-4
การปรับแต่งโดยใช้การเรียนรู้แบบเสริมจากคำแนะนำของมนุษย์
การเรียนรู้แบบเสริมจากคำแนะนำของมนุษย์ (RLHF) มีบทบาทสำคัญในการปรับแต่งโมเดลภาษาที่ได้รับการฝึกฝนมาแล้วให้เข้ากับค่านิยมของมนุษย์มากขึ้น แนวคิดนี้ถูกนำเสนอโดย Open AI ในปี 2017 และเป็นรากฐานสำหรับการสร้างสรรค์งานสรุปเอกสารและพัฒนา InstructGPT
หัวใจของ RLHF คือการเรียนรู้แบบเสริมกำลัง ซึ่งเป็นเทคนิคที่ตัวแทนเรียนรู้วิธีปฏิบัติในสภาพแวดล้อม โดยทำการกระทำและรับรางวัล เป็นวงจรต่อเนื่องของการกระทำและผลป้อนกลับ ซึ่งกระตุ้นให้ตัวแทนเลือกสิ่งที่จะได้รางวัลสูงสุด
สำหรับโมเดลภาษา ตัวแทนคือโมเดลเอง ซึ่งทำงานในสภาพแวดล้อมของหน้าต่างบริบทที่กำหนด และตัดสินใจจากสถานะที่นิยามด้วยโทเค็นปัจจุบันในหน้าต่างนั้น «ปริภูมิการกระทำ» ครอบคลุมโทเค็นทั้งหมดที่โมเดลเลือกได้ โดยมีเป้าหมายให้เลือกโทเค็นที่สอดคล้องกับความชอบของมนุษย์มากที่สุด
กระบวนการ RLHF ใช้คำแนะนำจากมนุษย์อย่างกว้างขวาง โดยใช้มันในการฝึกโมเดลรางวัล ซึ่งเล่นบทบาทสำคัญในการชี้นำโมเดลที่ได้รับการฝึกฝนมาแล้วในช่วงการปรับแต่ง โดยกระตุ้นให้โมเดลสร้างผลลัพธ์ที่สอดคล้องกับค่านิยมของมนุษย์มากขึ้น เป็นกระบวนการที่มีปฏิสัมพันธ์และวนซ้ำ โดยที่โมเดลเรียนรู้ผ่าน «การสร้างลำดับสถานะและการกระทำ (rollouts)» ซึ่งเป็นคำที่ใช้เพื่ออธิบายลำดับของสถานะและการกระทำที่นำไปสู่รางวัลในบริบทของการสร้างภาษา

หนึ่งในศักยภาพที่น่าประทับใจของ RLHF คือความสามารถในการส่งเสริมการปรับแต่งให้เหมาะสมกับบุคคลในระบบ AI โดยปรับให้เหมาะสมกับความชอบส่วนบุคคลของแต่ละคน ไม่ว่าจะเป็นอารมณ์ขันหรือการทำงานประจำวัน เปิดโอกาสให้สร้างระบบ AI ที่ไม่เพียงแต่ด้านเทคนิคเท่านั้น แต่ยังมีความเข้าใจทางอารมณ์และสามารถตอบสนองต่อความแตกต่างในการสื่อสารของมนุษย์
อย่างไรก็ตาม สิ่งสำคัญที่ต้องทราบคือ RLHF ไม่ใช่วิธีแก้ปัญหาที่สมบูรณ์แบบ โมเดลยังคงสามารถสร้างผลลัพธ์ที่ไม่พึงประสงค์ได้ ซึ่งสะท้อนถึงข้อมูลมหาศาลที่มักไม่ได้รับการควบคุมและมีอคติที่พวกมันถูกฝึกฝน
สรุป
กระบวนการปรับแต่ง ซึ่งเป็นขั้นตอนสำคัญในการใช้ประโยชน์จากโมเดลภาษาขนาดใหญ่ เช่น Alpaca, Falcon และ GPT-4 ได้กลายเป็นกระบวนการที่มีจุดมุ่งหมายและเฉพาะเจาะจงมากขึ้น โดยให้โซลูชันที่ปรับแต่งให้เหมาะสมกับงานต่างๆ
เราพบการปรับแต่งสำหรับงานเดียว ซึ่งเชี่ยวชาญในงานเฉพาะ และการปรับแต่งที่มีประสิทธิภาพต่อพารามิเตอร์ (PEFT) รวมถึง LoRA และ QLoRA ซึ่งมุ่งหวังที่จะทำให้กระบวนการฝึกอบรมมีประสิทธิภาพและคุ้มต้นทุนมากขึ้น การพัฒนานี้เปิดโอกาสให้เข้าถึงฟังก์ชัน AI ระดับสูงสำหรับผู้ใช้จำนวนมากขึ้น
นอกจากนี้ การแนะนำการเรียนรู้แบบเสริมจากคำแนะนำของมนุษย์ (RLHF) โดย Open AI เป็นขั้นตอนสำคัญในการสร้างระบบ AI ที่เข้าใจและปรับให้เหมาะสมกับค่านิยมและความชอบส่วนบุคคลของมนุษย์มากขึ้น ทั้ง RLHF และ PEFT ทำงานร่วมกันเพื่อปรับปรุงฟังก์ชันและประสิทธิภาพของโมเดลภาษาขนาดใหญ่
เมื่อธุรกิจ องค์กร และบุคคลต่างๆ พยายามรวมโมเดล LLM ที่ปรับแต่งแล้วเข้ากับการดำเนินงาน พวกเขากำลังต้อนรับอนาคตที่ AI ไม่ใช่แค่เครื่องมือ แต่เป็นหุ้นส่วนที่เข้าใจและปรับตัวให้เข้ากับบริบทของมนุษย์ โดยนำเสนอโซลูชันที่เป็นนวัตกรรมและปรับแต่งให้เหมาะสมกับความต้องการเฉพาะ


