
ที่ดีที่สุด
10 อัลกอริทึมการเรียนรู้ของเครื่องจักรที่ดีที่สุด

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
แม้ว่าเราจะอยู่ในยุคของนวัตกรรมที่ไม่เคยเกิดขึ้นมาก่อนในด้านการเรียนรู้ของเครื่องจักรที่เร่งความเร็วโดย GPU แต่การวิจัยล่าสุดมักจะเน้นไปที่อัลกอริทึมที่มีอายุหลายทศวรรษ และในบางกรณี อายุ 70 ปี
บางคนอาจแย้งว่าอัลกอริทึมเก่าๆ เหล่านี้อยู่ในหมวด ‘การวิเคราะห์ทางสถิติ’ มากกว่าการเรียนรู้ของเครื่องจักร และเลือกที่จะนับย้อนกลับไปถึงปี 1957 เมื่อมีการคิดค้น Perceptron
เมื่อพิจารณาจากความกว้างขวางที่อัลกอริทึมเก่าๆ เหล่านี้ให้การสนับสนุนและรวมอยู่ในแนวโน้มล่าสุดและความก้าวหน้าในการเรียนรู้ของเครื่องจักร จุดยืนดังกล่าวจึงยังเป็นเรื่องที่โต้แย้งได้ เรามาดูองค์ประกอบพื้นฐาน ‘คลาสสิก’ ที่รองรับนวัตกรรมล่าสุด รวมถึงอัลกอริทึมใหม่บางตัวที่เริ่มสร้างชื่อในแวดวง AI
1: Transformers
ในปี 2017 Google Research ได้นำการวิจัยร่วมกันซึ่งสิ้นสุดด้วย งานวิจัย Attention Is All You Need การวิจัยนี้อธิบายถึงสถาปัตยกรรมใหม่ที่ส่งเสริม กลไกการให้ความสนใจ จากองค์ประกอบเสริมในโมเดลตัวเข้ารหัส/ตัวถอดรหัสและเครือข่ายวนซ้ำ ให้เป็นเทคโนโลยีเปลี่ยนโฉมหลักที่ทำงานได้ด้วยตัวเอง
แนวทางนี้ได้รับการตั้งชื่อว่า Transformer และได้กลายเป็นวิธีการปฏิวัติในการประมวลผลภาษาธรรมชาติ (NLP) โดยให้พลังงานแก่โมเดลภาษาแบบออโตรีเกรสซีฟและสัญลักษณ์ของ AI อย่าง GPT-3 ของ OpenAI รวมถึงตัวอย่างอื่นอีกมาก

Transformer ได้แก้ปัญหา การแปลงลำดับ ซึ่งเรียกว่า ‘การแปลง’ ซึ่งเกี่ยวข้องกับการประมวลผลลำดับข้อมูลเข้าเป็นลำดับข้อมูลออก Transformer ยังรับและจัดการข้อมูลในลักษณะต่อเนื่อง ไม่ใช่ในลักษณะแบตช์ ซึ่งช่วยให้ ‘ความทรงจำที่คงอยู่’ ซึ่ง RNN ไม่ได้ออกแบบมาให้ได้รับ
หากต้องการทราบข้อมูลเพิ่มเติมเกี่ยวกับ Transformer โปรดดูที่ บทความอ้างอิงของเรา
ในทางตรงกันข้ามกับ RNN ที่เริ่มครอบงำการวิจัย ML ในยุค CUDA สถาปัตยกรรม Transformer สามารถ ขนานการประมวลผล ได้อย่างง่ายดาย ทำให้สามารถจัดการข้อมูลได้มากขึ้นกว่า RNN
การใช้งานที่นิยม
Transformer ได้ครอบงำจินตนาการของสาธารณชนในปี 2020 ด้วยการเปิดตัว GPT-3 ของ OpenAI ซึ่งมี 175 พันล้านพารามิเตอร์ ซึ่งเป็นความสำเร็จที่น่าประทับใจในขณะนั้น แต่หลังจากนั้นได้ถูกทดแทนด้วยโครงการอื่นๆ เช่น Megatron-Turing NLG 530B ของ Microsoft ในปี 2021 ซึ่งมีพารามิเตอร์มากกว่า 530 พันล้าน

เส้นเวลาโครงการ NLP Transformer Hyperscale ที่มา: Microsoft
สถาปัตยกรรม Transformer ยังขยายจาก NLP ไปสู่การมองเห็นของเครื่องจักร โดยให้พลังงานแก่เฟรมเวิร์กการสร้างภาพรุ่นใหม่ เช่น CLIP และ DALL-E ของ OpenAI ซึ่งใช้การแมปโดเมนข้อความ-ภาพเพื่อสร้างภาพที่ไม่สมบูรณ์และสังเคราะห์ภาพใหม่จากโดเมนที่ได้รับการฝึกอบรม
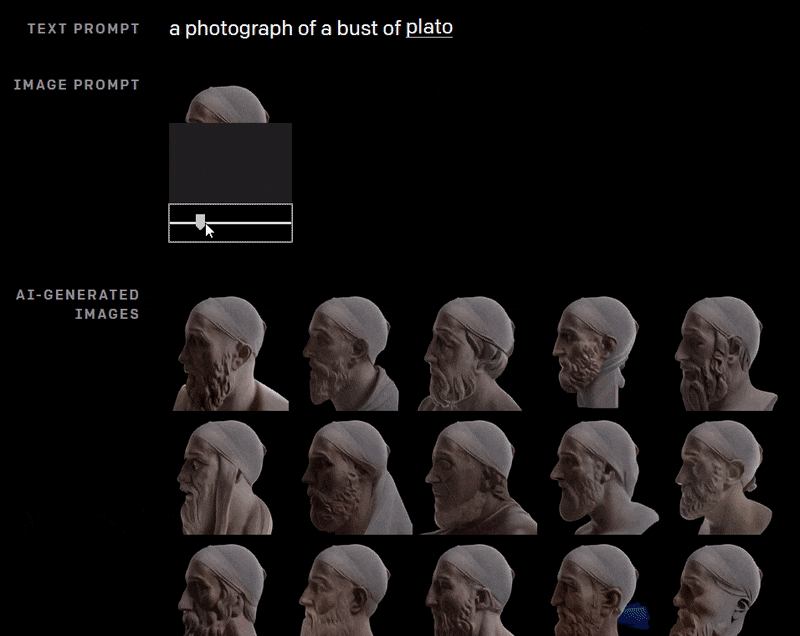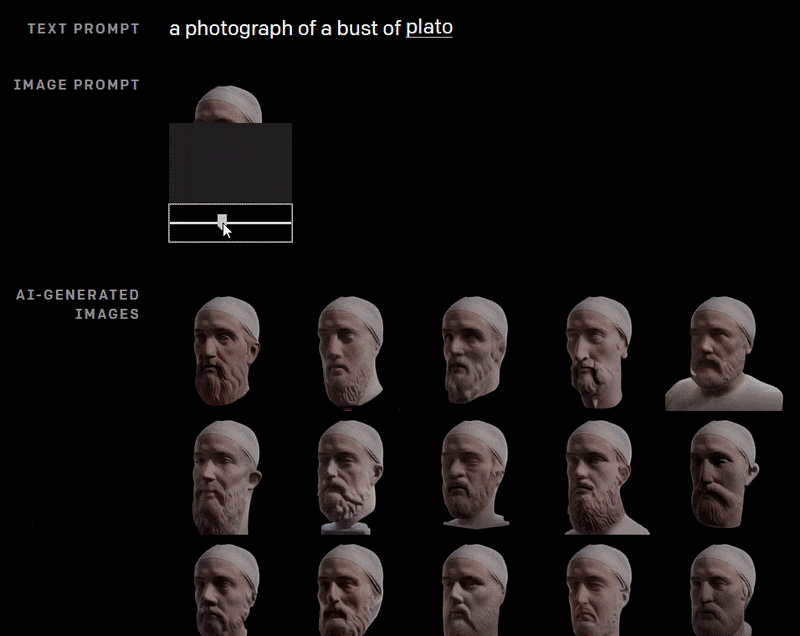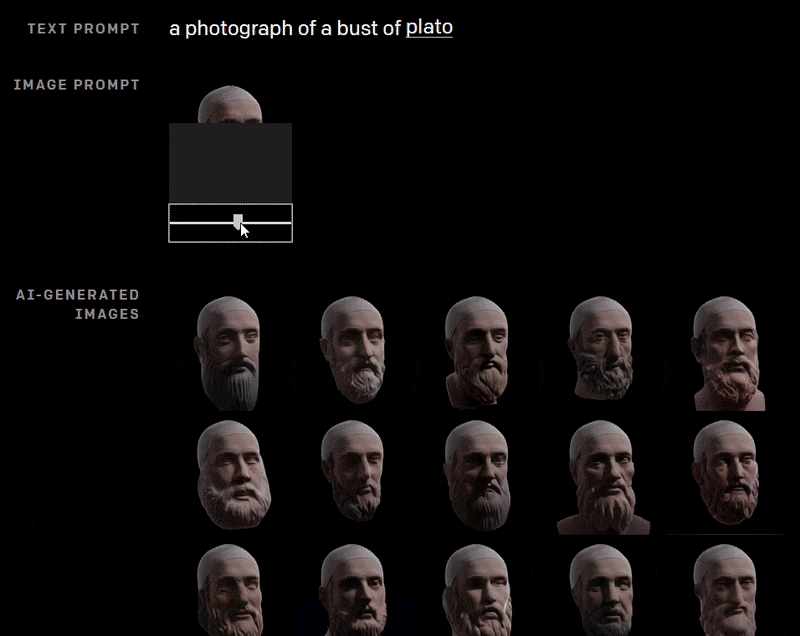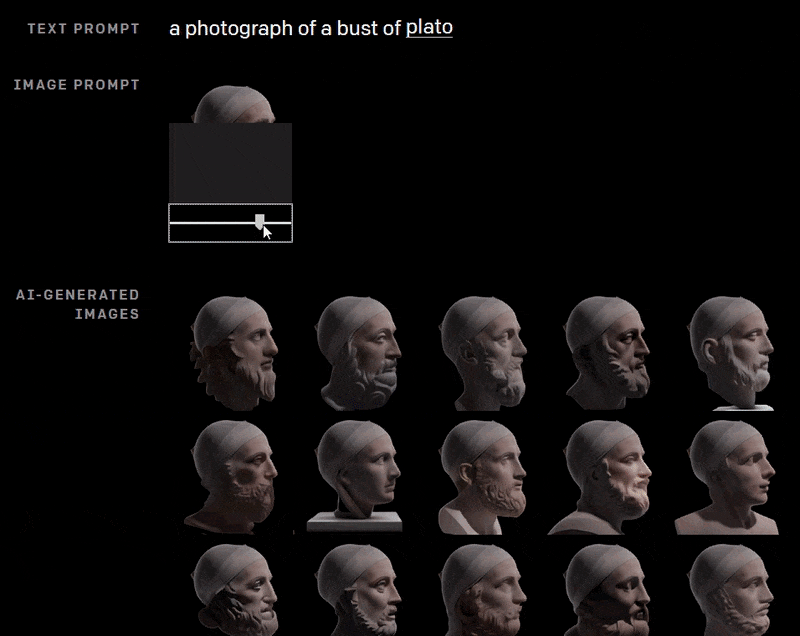
DALL-E พยายามที่จะสร้างภาพที่ไม่สมบูรณ์ของ รูปปั้นครึ่งตัวของเพลโต ที่มา: https://openai.com/blog/dall-e/
2: Generative Adversarial Networks (GANs)
แม้ว่า Transformer จะได้รับการกล่าวถึงอย่างมากผ่านการเปิดตัวและนำ GPT-3 มาใช้ แต่ Generative Adversarial Network (GAN) ได้กลายเป็นแบรนด์ที่รู้จักกันดีในตัวมันเอง และอาจจะเข้าร่วม deepfake เป็นคำกริยา
GAN ถูกเสนอครั้งแรก ในปี 2014 และใช้หลักๆ ในการสร้างภาพ สถาปัตยกรรม GAN ประกอบด้วย Generator และ Discriminator Generator วนซ้ำผ่านภาพหลายพันภาพในเซตข้อมูล โดยพยายามที่จะสร้างภาพใหม่ขึ้นมาใหม่ สำหรับการพยายามแต่ละครั้ง Discriminator จะให้คะแนนผลงานของ Generator และส่ง Generator กลับไปเพื่อทำดีขึ้น แต่ไม่ได้ให้ข้อมูลเกี่ยวกับวิธีการที่การสร้างภาพใหม่ผิดพลาดไป

ที่มา: https://developers.google.com/machine-learning/gan/gan_structure
การบังคับ Generator ให้สำรวจเส้นทางหลายๆ เส้นทาง แทนที่จะติดอยู่ในทางตันที่อาจเกิดขึ้นหาก Discriminator บอกว่าทำผิดตรงไหน (ดู #8 ด้านล่าง) เมื่อการฝึกอบรมเสร็จสิ้น Generator จะมีแผนที่ที่ครอบคลุมของความสัมพันธ์ระหว่างจุดในเซตข้อมูล
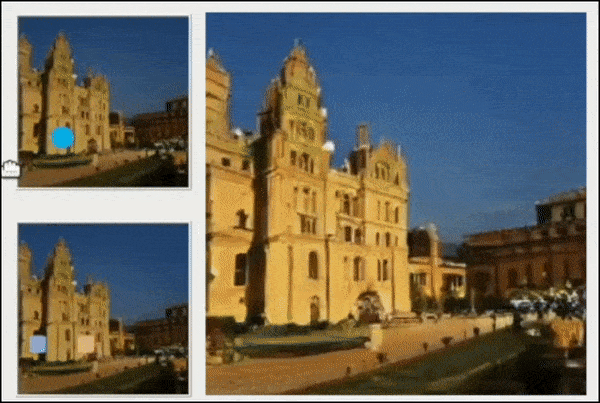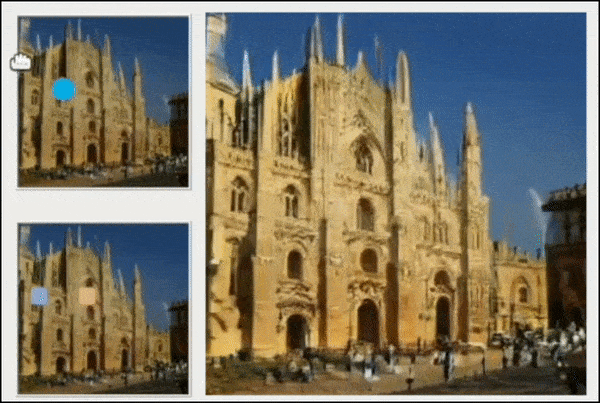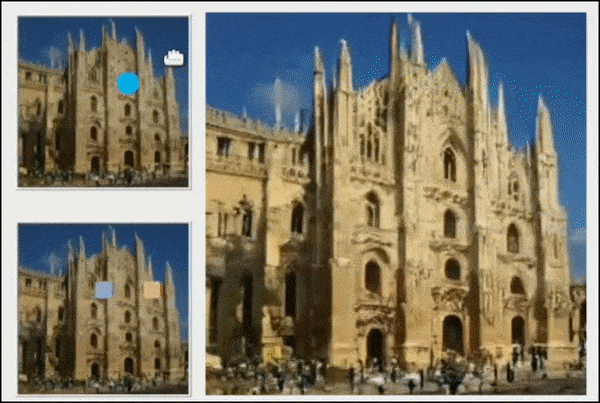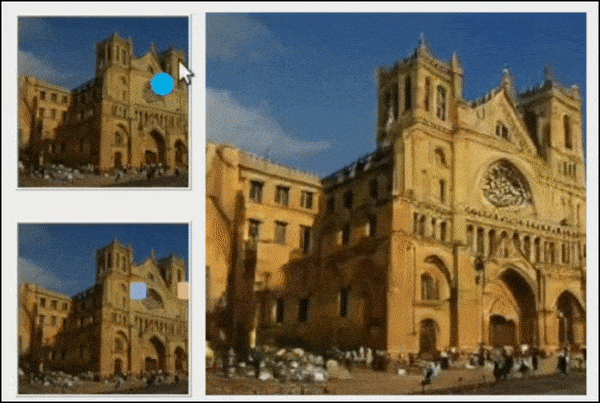
จากบทความ Improving GAN Equilibrium by Raising Spatial Awareness: เฟรมเวิร์กใหม่สำรวจปริภูมิแฝงของ GAN ที่บางครั้งยังลึกลับ และให้วิธีควบคุมสถาปัตยกรรมการสร้างภาพที่ตอบสนองต่อผู้ใช้ ที่มา: https://genforce.github.io/eqgan/
โดยอุปมานะ นี่คือความแตกต่างระหว่างการเรียนรู้เส้นทางเดินทางประจำที่น่าเบื่อเพียงเส้นเดียวสู่ใจกลางลอนดอน กับการพยายามอย่างหนักเพื่อเรียนรู้ The Knowledge
ผลลัพธ์คือการรวบรวมคุณลักษณะระดับสูงในพื้นที่ Latent ของโมเดลที่ฝึกอบรม คุณลักษณะระดับสูงอาจเป็น ‘คน’ ในขณะที่การลดระดับลงในคุณลักษณะที่เกี่ยวข้องอาจพบคุณลักษณะที่เรียนรู้อื่นๆ เช่น ‘ชาย’ และ ‘หญิง’ ในระดับที่ต่ำกว่า คุณลักษณะย่อยสามารถแบ่งออกเป็น ‘ผมบลอนด์’ ‘คอเคเชียน’ ฯลฯ
ความพัวพันของคุณลักษณะเป็นปัญหาที่น่าสังเกตในปริภูมิแฝงของ GAN และเฟรมเวิร์กตัวเข้ารหัส/ตัวถอดรหัส รอยยิ้มบนใบหน้าผู้หญิงที่ GAN สร้างขึ้นเป็นคุณลักษณะที่พัวพันกับ ‘อัตลักษณ์’ ของเธอในปริภูมิแฝง หรือเป็นกิ่งที่แยกขนานกัน?

ใบหน้าที่สร้างโดย GAN จาก thispersondoesnotexist ที่มา: https://this-person-does-not-exist.com/en
ช่วงสองสามปีที่ผ่านมามีการเปิดตัวการวิจัยใหม่ๆ ในด้านนี้ ซึ่งอาจเปิดทางให้กับการแก้ไขระดับคุณลักษณะในพื้นที่ Latent ของ GAN เช่นเดียวกับการแก้ไขแบบ Photoshop ในขณะนี้ การเปลี่ยนแปลงหลายๆ อย่างมีลักษณะเป็น ‘แพ็คเกจทั้งหมดหรือไม่มีอะไรเลย’ ที่สำคัญคือการเปิดตัว EditGAN ของ NVIDIA ในปลายปี 2021 ซึ่งบรรลุระดับความสามารถในการอธิบายได้ที่สูงในพื้นที่ Latent โดยใช้แมสค์ Semantic Segmentation
การใช้งานที่นิยม
นอกเหนือจากความเกี่ยวข้องที่จำกัดกับวิดีโอ deepfake ที่เป็นที่นิยม ภาพ/วิดีโอ GAN ที่มุ่งเน้นไปที่ภาพและวิดีโอมีการแพร่กระจายในช่วงสี่ปีที่ผ่านมา โดยดึงดูดความสนใจของนักวิจัยและประชาชนทั่วไป การติดตามอัตราและความถี่ของการเปิดตัวใหม่ๆ เป็นความท้าทาย แต่ ที่เก็บโค้ด GitHub Awesome GAN Applications มีเป้าหมายที่จะให้รายการที่ครอบคลุม
GANs สามารถอนุมานคุณลักษณะจากโดเมนที่กำหนดได้โดยทฤษฎี รวมถึงข้อความ
3: SVM
ที่มา ในปี 1963 Support Vector Machine (SVM) เป็นอัลกอริทึมหลักที่พบได้บ่อยในงานวิจัยใหม่ ใน SVM เวกเตอร์จะแสดงถึงการกระจายตัวของจุดศอกมูลในเซตข้อมูล ในขณะที่ support เวกเตอร์จะกำหนดขอบเขตระหว่างกลุ่มต่างๆ คุณลักษณะหรือคุณสมบัติ

เวกเตอร์สนับสนุนกำหนดขอบเขตระหว่างกลุ่ม ที่มา: https://www.kdnuggets.com/2016/07/support-vector-machines-simple-explanation.html
ขอบเขตที่ได้รับเรียกว่า hyperplane
ในระดับคุณลักษณะต่ำ SVM เป็น สองมิติ (ภาพด้านบน) แต่เมื่อมีการจดจำกลุ่มหรือประเภทที่สูงกว่า มันจะกลายเป็น สามมิติ

การกำหนด SVM ที่ลึกกว่าจำเป็นต้องใช้ SVM ที่สามมิติ ที่มา: https://cml.rhul.ac.uk/svm.html
การใช้งานที่นิยม
เนื่องจาก SVM สามารถจัดการข้อมูลหลายมิติได้อย่างมีประสิทธิภาพและเป็นกลาง จึงพบได้ทั่วไปในหลายๆ ด้านของการเรียนรู้ของเครื่องจักร รวมถึง การตรวจจับ deepfake การจำแนกประเภทภาพ การจำแนกประเภทคำพูดที่เกลียดชัง การวิเคราะห์ DNA และ การคาดการณ์โครงสร้างประชากร เป็นต้น
4: K-Means Clustering
การ Clustering ในทั่วไปเป็นแนวทาง การเรียนรู้ที่ไม่มีการดูแล ที่พยายามจำแนกจุดศอกมูลโดยใช้ การประมาณการความหนาแน่น โดยการสร้างแผนที่การกระจายตัวของข้อมูลที่กำลังศึกษา

การ Clustering K-Means ค้นหาส่วน กลุ่ม และชุมชนในข้อมูล ที่มา: https://aws.amazon.com/blogs/machine-learning/k-means-clustering-with-amazon-sagemaker/
K-Means Clustering ได้กลายเป็นการนำไปใช้ที่ได้รับความนิยมมากที่สุดของแนวทางนี้ โดยนำจุดศอกมูลไปสู่ ‘K กลุ่ม’ ที่แตกต่างกัน ซึ่งอาจบ่งบอกถึงส่วนประชากร สังคมออนไลน์ หรือการรวมกันทางสถิติที่ซ่อนอยู่อื่นๆ ในข้อมูลดิบ

การก่อตัวของกลุ่มใน K-Means ที่มา: https://www.geeksforgeeks.org/ml-determine-the-optimal-value-of-k-in-k-means-clustering/
ค่า K เป็นตัวกำหนดความมีประโยชน์ของกระบวนการ และในการกำหนดค่า K ที่เหมาะสมสำหรับกลุ่ม ค่า K จะถูกกำหนดแบบสุ่มในตอนแรก และคุณลักษณะและเวกเตอร์ของมันจะถูกเปรียบเทียบกับเพื่อนบ้านที่ใกล้เคียงที่สุด ซึ่งจะถูกกำหนดให้เป็นกลุ่มเดียวกันอย่างต่อเนื่องจนกว่าข้อมูลจะให้ผลลัพธ์ที่เป็นไปได้ทั้งหมด
การพล็อตของข้อผิดพลาดกำลังสอง หรือ ‘ต้นทุน’ ของค่าผิดปกติระหว่างกลุ่มจะแสดง ‘จุดศอก‘ สำหรับข้อมูล:

จุดศอกในกราฟกลุ่ม ที่มา: https://www.scikit-yb.org/en/latest/api/cluster/elbow.html
จุดศอกคล้ายกับแนวคิดที่ว่าการสูญเสียจะแบนออกไปสู่ผลตอบแทนที่ลดลงเมื่อสิ้นสุดการฝึกอบรมเซตข้อมูล มันแสดงถึงจุดที่ไม่มีการแบ่งแยกเพิ่มเติมระหว่างกลุ่มที่จะเกิดขึ้น ซึ่งบ่งชี้ถึงจุดที่ควรดำเนินการต่อหรือรายงานผลลัพธ์
การใช้งานที่นิยม
K-Means Clustering เป็นเทคโนโลยีหลักในการวิเคราะห์ลูกค้า เนื่องจากให้วิธีการที่ชัดเจนและสามารถอธิบายได้ในการแปลบันทึกการค้าขนาดใหญ่ให้เป็นข้อมูลประชากรและ ‘ลีด’
นอกเหนือจากนี้ K-Means Clustering ยังถูกนำไปใช้ในการ การคาดการณ์แผ่นดินถล่ม การแบ่งส่วนภาพทางการแพทย์ การสร้างภาพด้วย GANs การจำแนกประเภทเอกสาร และ การวางแผนเมือง เป็นต้น
5: Random Forest
Random Forest เป็น วิธีการเรียนรู้แบบรวมกลุ่ม ที่เฉลี่ยผลลัพธ์จาก ต้นไม้ตัดสินใจ หลายต้นเพื่อกำหนดการคาดการณ์ผลลัพธ์โดยรวม

ที่มา: https://www.tutorialandexample.com/wp-content/uploads/2019/10/Decision-Trees-Root-Node.png
หากคุณได้ศึกษามันแม้เพียงดูภาพยนตร์ไตรภาค Back to the Future ต้นไม้ตัดสินใจก็สามารถเข้าใจได้ง่ายๆ: มีหลายเส้นทางอยู่ข้างหน้า และแต่ละเส้นทางจะแตกออกเป็นผลลัพธ์ใหม่ซึ่งมีเส้นทางใหม่ๆ อีก
ใน การเรียนรู้แบบเสริมกำลัง คุณอาจถอยกลับและเริ่มต้นใหม่จากจุดเริ่มต้น แต่ต้นไม้ตัดสินใจจะยึดมั่นในเส้นทางของมัน
ดังนั้น อัลกอริทึม Random Forest จึงเป็นการเดิมพันแบบสุ่ม โดยเลือกและสังเกตแบบเฉพาะกิจเพื่อทำความเข้าใจผลรวมที่เป็นมัธยฐานของผลลัพธ์จากต้นไม้ตัดสินใจ
เนื่องจากมันพิจารณาปัจจัยหลายอย่าง Random Forest จึงสามารถให้ผลลัพธ์ที่ดีกว่าต้นไม้ตัดสินใจ แต่การแปลงเป็นกราฟที่มีความหมายอาจยากกว่า
ต้นไม้ตัดสินใจมีความเสี่ยงต่อการเรียนรู้เกินพอดี ซึ่งผลลัพธ์ที่ได้รับเป็นข้อมูลเฉพาะและไม่น่าจะทั่วไป Random Forest ใช้การคัดเลือกข้อมูลแบบสุ่มเพื่อต่อสู้กับการเรียนรู้เกินพอดีนี้ โดยเจาะลึกถึงแนวโน้มที่มีประโยชน์และเป็นตัวแทนในข้อมูล

การถดถอยต้นไม้ตัดสินใจ ที่มา: https://scikit-learn.org/stable/auto_examples/tree/plot_tree_regression.html
การใช้งานที่นิยม
เช่นเดียวกับอัลกอริทึมหลายตัวในรายการนี้ Random Forest มักจะทำงานเป็นตัวกรองและจัดเรียงข้อมูลในขั้นตอนแรก และดังนั้นจึงพบได้บ่อยในงานวิจัยใหม่ ตัวอย่างการใช้ Random Forest ได้แก่ การสร้างภาพด้วย Magnetic Resonance การคาดการณ์ราคา Bitcoin การแบ่งส่วนลูกค้าตามข้อมูลสำรวจประชากรสหรัฐฯ การจำแนกประเภทข้อความ และ การตรวจจับการฉ้อโกงบัตรเครดิต
เนื่องจาก Random Forest เป็นอัลกอริทึมระดับต่ำในสถาปัตยกรรมการเรียนรู้ของเครื่องจักร จึงสามารถมีส่วนร่วมในการทำงานของอัลกอริทึมระดับต่ำอื่นๆ เช่นเดียวกับอัลกอริทึมการแสดงภาพ รวมถึง การ Clustering แบบอุปนัย การแปลงคุณลักษณะ การจำแนกประเภทเอกสาร โดยใช้คุณลักษณะที่กระจาย และ การแสดง Pipeline
6: Naive Bayes
คู่กับการประมาณการความหนาแน่น (ดู 4 ข้างบน) Naive Bayes คืออัลกอริทึมที่มีประสิทธิภาพแต่ค่อนข้างเบาที่สามารถคาดการณ์ความน่าจะเป็นตามคุณลักษณะที่คำนวณได้

ความสัมพันธ์ของคุณลักษณะในตัวจำแนก Naive Bayes ที่มา: https://www.sciencedirect.com/topics/computer-science/naive-bayes-model
คำว่า ‘naïve’ หมายถึงสมมติฐานใน ทฤษฎีของเบย์ ที่ว่าคุณลักษณะไม่เกี่ยวข้องกัน ซึ่งเรียกว่า ความเป็นอิสระแบบมีเงื่อนไข หากคุณยอมรับจุดยืนนี้ การเดินและพูดเหมือนเป็ดไม่เพียงพอในการพิสูจน์ว่าเรากำลังเผชิญกับเป็ด และไม่มีการสันนิษฐานที่ ‘ชัดเจน’ ที่ถูกนำมาใช้ก่อนอื่น
ระดับนี้ของความเข้มงวดทางวิชาการและสอบสวนอาจมากเกินจำเป็นในกรณีที่ใช้ ‘สามัญสำนึก’ ได้ แต่เป็นมาตรฐานที่มีค่าเมื่อเดินผ่านความไม่แน่นอนและความสัมพันธ์ที่อาจไม่เกี่ยวข้องกันในเซตข้อมูลการเรียนรู้ของเครื่องจักร
ในเครือข่ายเบย์แบบดั้งเดิม คุณลักษณะจะถูกกำหนดโดย ฟังก์ชันการให้คะแนน รวมถึงความยาวการอธิบายขั้นต่ำและ การให้คะแนนแบบเบย์ ซึ่งสามารถกำหนดข้อจำกัดในข้อมูลในแง่ของการเชื่อมต่อที่คาดการณ์ระหว่างจุดศอกมูลและทิศทางที่การเชื่อมต่อเหล่านี้ไหล
ตัวจำแนก Naive Bayes ทำงานโดยสมมติว่าคุณลักษณะของวัตถุใดๆ เป็นอิสระจากกัน และใช้ทฤษฎีของเบย์เพื่อคำนวณความน่าจะเป็นของวัตถุตามคุณลักษณะของมัน
การใช้งานที่นิยม
ตัวกรอง Naive Bayes มีการใช้งานที่หลากหลายใน การคาดการณ์โรคและการจำแนกประเภทเอกสาร การกรองสแปม การจำแนกประเภทความรู้สึก ระบบแนะนำ และ การตรวจจับการฉ้อโกง เป็นต้น
7: K-Nearest Neighbors (KNN)
ที่ถูกเสนอครั้งแรกโดยโรงเรียนการแพทย์การบินของกองทัพอากาศสหรัฐฯ ในปี 1951 และต้องปรับตัวให้เข้ากับสถานะของฮาร์ดแวร์คอมพิวเตอร์ในยุคกลางของศตวรรษที่ 20 K-Nearest Neighbors (KNN) เป็นอัลกอริทึมที่เรียบง่ายที่ยังคงใช้อยู่ในงานวิจัยและโครงการการเรียนรู้ของเครื่องจักร
KNN ถูกเรียกว่า ‘ผู้เรียนรู้ที่ขี้เกียจ’ เนื่องจากมันสแกนเซตข้อมูลอย่างละเอียดเพื่อประเมินความสัมพันธ์ระหว่างจุดศอกมูล แทนที่จะฝึกโมเดลการเรียนรู้ของเครื่องจักรที่สมบูรณ์

การแบ่งกลุ่ม KNN ที่มา: https://scikit-learn.org/stable/modules/neighbors.html
แม้ว่า KNN จะมีโครงสร้างที่เรียบง่าย แต่วิธีการที่เป็นระบบของมันทำให้เกิดความต้องการที่สำคัญต่อการดำเนินการอ่าน/เขียน และการใช้งานในเซตข้อมูลขนาดใหญ่มากอาจเป็นปัญหาโดยไม่มีเทคโนโลยีเสริม เช่น การวิเคราะห์องค์ประกอบหลัก (PCA) ซึ่งสามารถแปลงเซตข้อมูลที่ซับซ้อนและใหญ่ๆ ให้เป็น การแบ่งกลุ่มที่เป็นตัวแทน ที่ KNN สามารถเดินทางได้ด้วยความพยายามน้อยลง
การศึกษา ล่าสุด ประเมินประสิทธิภาพและเศรษฐกิจของอัลกอริทึมหลายตัวที่ได้รับมอบหมายให้คาดการณ์ว่าพนักงานจะออกจากบริษัทหรือไม่ โดยพบว่า KNN ที่มีอายุ 70 ปียังคงเหนือกว่าอัลกอริทึมสมัยใหม่ในแง่ของความแม่นยำและประสิทธิภาพในการคาดการณ์
การใช้งานที่นิยม
แม้ว่า KNN จะมีความเรียบง่ายในแนวคิดและใช้งาน แต่ก็ไม่ได้หยุดอยู่ในยุค 1950 – มันถูกปรับให้เหมาะสมใน แนวทางที่เน้น DNN มากขึ้น ในข้อเสนอของมหาวิทยาลัยรัฐเพนซิลเวเนียในปี 2018 และยังคงเป็นกระบวนการเริ่มต้นหรือเครื่องมือวิเคราะห์หลังการประมวลผลในหลายๆ โครงสร้างการเรียนรู้ของเครื่องจักรที่ซับซ้อน
ในหลายๆ การตั้งค่า KNN ถูกนำไปใช้สำหรับ การยืนยันตัวตนลายเซ็นออนไลน์ การจำแนกประเภทภาพ การทำเหมืองข้อความ การคาดการณ์ผลผลิตพืช และ การรู้จำใบหน้า เป็นต้น

ระบบการรู้จำใบหน้าโดยใช้ KNN ในการฝึกอบรม ที่มา: https://pdfs.semanticscholar.org/6f3d/d4c5ffeb3ce74bf57342861686944490f513.pdf
8: Markov Decision Process (MDP)
เฟรมเวิร์กทางคณิตศาสตร์ที่แนะนำโดยนักคณิตศาสตร์ชาวอเมริกัน Richard Bellman ในปี 1957 Markov Decision Process (MDP) เป็นหนึ่งในบล็อกพื้นฐานของ การเรียนรู้แบบเสริมกำลัง สถาปัตยกรรม โดยเป็นอัลกอริทึมเชิงแนวคิดที่ถูกปรับใช้ในอัลกอริทึมอื่นจำนวนมาก และปรากฏซ้ำในงานวิจัย AI/ML ปัจจุบัน MDP ตรวจสอบสภาพแวดล้อมข้อมูลโดยใช้การประเมินสถานะปัจจุบัน (เช่น ‘ที่ไหน’ ในข้อมูล) เพื่อตัดสินใจว่าจะสำรวจโหนดข้อมูลต่อไป

ที่มา: https://www.sciencedirect.com/science/article/abs/pii/S0888613X18304420
MDP พื้นฐานจะให้ความสำคัญกับผลประโยชน์ในระยะสั้นมากกว่าผลลัพธ์ที่ต้องการในระยะยาว สำหรับเหตุผลนี้ จึงมักจะถูกฝังอยู่ในนโยบายการเรียนรู้แบบเสริมกำลังที่ครอบคลุมมากขึ้น และมักจะถูกจำกัดด้วยปัจจัย เช่น ผลตอบแทนที่คิดลด และตัวแปรสภาพแวดล้อมที่จะป้องกันไม่ให้เร่งไปสู่เป้าหมายทันทีโดยไม่พิจารณาผลลัพธ์ที่กว้างขึ้น
การใช้งานที่นิยม
แนวคิดพื้นฐานของ MDP มีการใช้งานอย่างกว้างขวางในงานวิจัยและการใช้งานจริงของการเรียนรู้ของเครื่องจักร มันถูกเสนอสำหรับ ระบบป้องกันความปลอดภัย IoT การประมง และ การคาดการณ์ตลาด
นอกเหนือจาก ความเหมาะสมที่ชัดเจน ในหมากรุกและเกมลำดับอื่นๆ MDP ยังเป็นคู่ที่เหมาะสมสำหรับการฝึกตามขั้นตอนของระบบหุ่นยนต์ เช่นที่เราจะเห็นในวิดีโอด้านล่าง
9: Term Frequency-Inverse Document Frequency
ความถี่ของคำ (TF) หารจำนวนครั้งที่คำปรากฏในเอกสารด้วยจำนวนคำทั้งหมดในเอกสารนั้น ดังนั้น คำว่า แมวน้ำ ที่ปรากฏหนึ่งครั้งในบทความที่มี 1,000 คำจะมี Term Frequency ของ 0.001 โดยการคำนวณเพียงอย่างเดียว TF ไม่มีประโยชน์มากนักเนื่องจากคำที่ไม่มีความหมาย (เช่น a and the และ it) มีจำนวนมาก
เพื่อให้ได้ค่าที่มีความหมายสำหรับคำศัพท์ Inverse Document Frequency (IDF) คำนวณ TF ของคำศัพท์ข้ามเอกสารหลายๆ เอกสารในเซตข้อมูล โดยให้คะแนนต่ำแก่คำหยุดที่มีความถี่สูงมาก เช่น คำนำหน้านาม เวกเตอร์คุณลักษณะที่ได้จะถูกทำให้เป็นค่าจำนวนเต็ม และแต่ละคำได้รับน้ำหนักที่เหมาะสม

TF-IDF ตั้งค่าน้ำหนักความสำคัญของคำศัพท์ตามความถี่ในหลายเอกสาร โดยความถี่ที่หายากเป็นตัวบ่งชี้ความสำคัญ ที่มา: https://moz.com/blog/inverse-document-frequency-and-the-importance-of-uniqueness
แม้แนวทางนี้จะป้องกันไม่ให้คำที่สำคัญทางความหมายสูญหายไปในฐานะค่าผิดปกติ แต่การกลับน้ำหนักความถี่ไม่ได้แปลโดยอัตโนมัติว่าคำที่มีความถี่ต่ำไม่ใช่ค่าผิดปกติ เพราะบางสิ่งหายากและไม่มีค่า ดังนั้น คำที่มีความถี่ต่ำจะต้องพิสูจน์คุณค่าของมันเองในบริบททางสถาปัตยกรรมโดยการปรากฏ (แม้เพียงความถี่ต่ำต่อเอกสาร) ในหลายๆ เอกสารในเซตข้อมูล
แม้ว่าจะมีอายุยาวนาน แต่ TF-IDF เป็นวิธีการที่มีประสิทธิภาพและได้รับความนิยมในการกรองขั้นตอนแรกในเฟรมเวิร์ก NLP
การใช้งานที่นิยม
เนื่องจาก TF-IDF มีส่วนร่วมในการพัฒนา PageRank ของ Google ในช่วง 20 ปีที่ผ่านมา จึงได้รับการนำมาใช้อย่างกว้างขวางในฐานะกลยุทธ์ปั่นผล SEO แม้ว่า John Mueller จะ ปฏิเสธ ความสำคัญของมันต่อผลลัพธ์การค้นหาในปี 2019
เนื่องจากความลับของ PageRank จึงไม่มีหลักฐานที่ชัดเจนว่า TF-IDF ไม่ใช่วิธีการที่มีประสิทธิภาพในการปรับปรุงการจัดอันดับของ Google การอภิปรายอย่างเผ็ดร้อนในหมู่ผู้เชี่ยวชาญด้าน IT ในช่วงหลังบ่งชี้ว่ามีความเข้าใจที่เป็นที่นิยม ซึ่งถูกต้องหรือไม่ก็ตามว่าการละเมิดคำศัพท์อาจนำไปสู่การวางตำแหน่ง SEO ที่ดีขึ้น (แม้ว่าจะมีการกล่าวหาว่ามีการใช้อำนาจผูกขาดโดยมิชอบและการโฆษณาเกินพอดี)
10: Stochastic Gradient Descent
Stochastic Gradient Descent (SGD) เป็นวิธีการที่ได้รับความนิยมมากขึ้นในการเพิ่มประสิทธิภาพการฝึกอบรมของโมเดลการเรียนรู้ของเครื่องจักร
การลดระดับตามความชัน เองเป็นวิธีการที่ใช้ในการเพิ่มประสิทธิภาพและประเมินความก้าวหน้าของโมเดลระหว่างการฝึกอบรม
ในบริบทนี้ ‘ความชัน’ หมายถึงความชันลง (ไม่ใช่การไล่ระดับสี) โดยที่จุดสูงสุดของ ‘เนิน’ ทางซ้ายแสดงถึงจุดเริ่มต้นของกระบวนการฝึกอบรม ซึ่งโมเดลยังไม่ได้เห็นข้อมูลทั้งหมดแม้เพียงครั้งเดียว และยังไม่ได้เรียนรู้พอที่จะสร้างการเปลี่ยนแปลงที่มีประสิทธิภาพ

การลดระดับตามความชันในการฝึก FaceSwap ช่วงครึ่งหลังการฝึกหยุดพัฒนาชั่วระยะหนึ่ง แต่สุดท้ายกลับลดลงตามความชันสู่การลู่เข้าที่ยอมรับได้
จุดต่ำสุดทางด้านขวาแสดงถึงการ การบรรจบกัน (จุดที่โมเดลมีประสิทธิภาพที่ดีที่สุดเท่าที่จะเป็นไปได้ภายใต้ข้อจำกัดและการตั้งค่าที่กำหนด)
ความชัน ทำหน้าที่เป็นบันทึกและตัวพยากรณ์สำหรับความแตกต่างระหว่างอัตราความผิดพลาด (ความแม่นยำที่โมเดลได้ทำการแมปความสัมพันธ์ของข้อมูล) และน้ำหนัก (การตั้งค่าที่ส่งผลต่อวิธีการที่โมเดลจะเรียนรู้)
ความชัน สามารถใช้เพื่อแจ้ง ตารางอัตราการเรียนรู้ ซึ่งเป็นกระบวนการอัตโนมัติที่บอกสถาปัตยกรรมให้กลายเป็นแบบละเอียดและแม่นยำมากขึ้นเมื่อความไม่ชัดเจนในตอนต้นเปลี่ยนเป็นความสัมพันธ์ที่ชัดเจนและแมปปิ้ง ในผลกระทบ การสูญเสียความชัน ให้แผนที่แบบเรียลไทม์ของที่ที่การฝึกอบรมควรไปต่อไปและวิธีการดำเนินการต่อ
นวัตกรรมของ Stochastic Gradient Descent คือการอัปเดตน้ำหนักโมเดลในแต่ละตัวอย่างการฝึกอบรมต่อการวนซ้ำ ซึ่งโดยทั่วไปจะเร่งการเดินทางสู่การบรรจบกัน เนื่องจากการเกิดขึ้นของเซตข้อมูล Hyperscale ในช่วงไม่กี่ปีที่ผ่านมา SGD จึงได้รับความนิยมมากขึ้นในฐานะวิธีการหนึ่งในการแก้ไขปัญหาที่เกิดขึ้น
ในทางกลับกัน SGD มี ผลกระทบด้านลบ ต่อการปรับขนาดคุณลักษณะ และอาจต้องใช้การวนซ้ำเพิ่มเติมเพื่อให้ได้ผลลัพธ์เดียวกัน ซึ่งต้องมีการวางแผนและพารามิเตอร์เสริมเมื่อเทียบกับการลดระดับตามความชันแบบปกติ
การใช้งานที่นิยม
ด้วยความสามารถในการปรับแต่งและแม้จะมีข้อบกพร่อง SGD จึงกลายเป็นอัลกอริทึมการเพิ่มประสิทธิภาพที่ได้รับความนิยมมากที่สุดสำหรับการปรับแต่งเครือข่ายประสาทเทียม หนึ่งในการกำหนดค่าของ SGD ที่กำลังจะกลายเป็นที่โดดเด่นในงานวิจัย AI/ML ใหม่ๆ คือการเลือก ตัวปรับค่าเหมาะสม Adaptive Moment Estimation (ADAM) ซึ่งเปิดตัวในปี 2015
ADAM ปรับอัตราการเรียนรู้แบบไดนามิกสำหรับแต่ละพารามิเตอร์ (‘อัตราการเรียนรู้แบบปรับได้’) เช่นเดียวกับการรวมผลลัพธ์จากการอัปเดตก่อนหน้าเข้าไปในคอนฟิกการอัปเดตถัดไป (‘โมเมนตัม’) นอกจากนี้ยังสามารถกำหนดค่าให้ใช้นวัตกรรมที่ตามมา เช่น โมเมนตัม Nesterov
อย่างไรก็ตาม บางคนแย้งว่าการใช้โมเมนตัมสามารถเร่ง ADAM (และอัลกอริทึมที่คล้ายกัน) ไปสู่ข้อสรุปที่ไม่เหมาะสม ดังที่กล่าวไว้ข้างต้น การเรียนรู้ของเครื่องจักรเป็นงานที่กำลังดำเนินอยู่
เผยแพร่ครั้งแรกวันที่ 10 กุมภาพันธ์ 2022 แก้ไขวันที่ 10 กุมภาพันธ์ เวลา 20:05 EET — การจัดรูปแบบ


