
โมเดลและแพลตฟอร์ม AI
Mistral 7B: สร้างเกณฑ์มาตรฐานใหม่เหนือ Llama 2 ในโลกโอเพนซอร์ส

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google

โมเดลภาษาขนาดใหญ่ (LLMs) ได้เข้ามาเป็นจุดสนใจหลักในขณะนี้ เนื่องจากมีโมเดลที่มีประสิทธิภาพสูง เช่น ChatGPT เมื่อ Meta เปิดตัวโมเดล Llama ของพวกเขา ก็ได้สร้างความสนใจใหม่ในโมเดลภาษาขนาดใหญ่แบบ Open-Source วัตถุประสงค์ คือ การสร้างโมเดลภาษาขนาดใหญ่ที่มีคุณภาพสูง มีราคาไม่แพง และไม่ซับซ้อนเหมือนโมเดล GPT-4
การผสมผสานระหว่างความสามารถในการเข้าถึงและประสิทธิภาพไม่เพียงแต่ทำให้นักวิจัยและนักพัฒนามีโอกาสใหม่ๆ แต่ยังเปิดโอกาสให้เกิดความก้าวหน้าทางเทคโนโลยีในด้านการประมวลผลภาษาธรรมชาติอีกด้วย
เมื่อไม่นานมานี้ Generative AI startups ได้รับการสนับสนุนเงินทุน Together ระดมทุนได้ 20 ล้านดอลลาร์เพื่อสร้างโมเดล AI ที่เปิดซอร์ส Anthropic ยังได้รับเงินทุน 450 ล้านเหรียญสหรัฐ และ Cohere ระดมทุนได้ 270 ล้านดอลลาร์ในเดือนมิถุนายนปีนี้ โดยร่วมมือกับ Google Cloud
การแนะนำ Mistral 7B: ขนาดและความพร้อม

Mistral AI ซึ่งตั้งอยู่ที่ปารีสและก่อตั้งโดยผู้ที่เคยทำงานที่ Google’s DeepMind และ Meta ได้ประกาศโมเดลภาษาขนาดใหญ่ของตนเอง คือ Mistral 7B โมเดลนี้สามารถดาวน์โหลดได้ง่ายๆ จาก GitHub และยังสามารถดาวน์โหลดได้จาก 13.4-gigabyte torrent
สตาร์ทอัพนี้สามารถระดมทุนได้มากที่สุดแม้ก่อนที่จะวางจำหน่ายผลิตภัณฑ์ Mistral AI โมเดลแรกที่มี 7 พันล้านพารามิเตอร์สามารถเอาชนะ Llama 2 13B ในทุกการทดสอบและเอาชนะ Llama 1 34B ในหลายๆ เมตริก
เมื่อเปรียบเทียบกับโมเดลอื่นๆ เช่น Llama 2 Mistral 7B มีความสามารถที่ใกล้เคียงหรือเหนือกว่า แต่มีภาระการคำนวณที่น้อยกว่า โมเดลที่มีพื้นฐานเช่น GPT-4 สามารถทำได้ดีกว่า แต่มีราคาแพงกว่าและใช้งานไม่สะดวกเท่าเพราะเข้าถึงผ่าน API เป็นหลัก
เมื่อพูดถึงงานโค้ด Mistral 7B สามารถแข่งขันกับ CodeLlama 7B ได้ดี และมีขนาดที่กะทัดรัดเพียง 13.4 GB ทำให้สามารถรันบนเครื่องมาตรฐานได้
นอกจากนี้ Mistral 7B Instruct ที่ปรับให้เหมาะสมสำหรับข้อมูลสอนบน Hugging Face ก็มีประสิทธิภาพที่ดี สามารถเอาชนะโมเดล 7B อื่นๆ ใน MT-Bench และมีประสิทธิภาพใกล้เคียงกับโมเดล 13B

Hugging Face Mistral 7B — ตัวอย่าง
การประเมินประสิทธิภาพ
ในการทดสอบประสิทธิภาพที่ละเอียด Mistral 7B ถูกวัดกับโมเดล Llama 2 ผลลัพธ์แสดงให้เห็นว่า Mistral 7B มีประสิทธิภาพเหนือกว่า Llama 2 13B ในทุกๆ การทดสอบ และสามารถเทียบเท่ากับ Llama 34B โดยเฉพาะในด้านโค้ดและเหตุผล
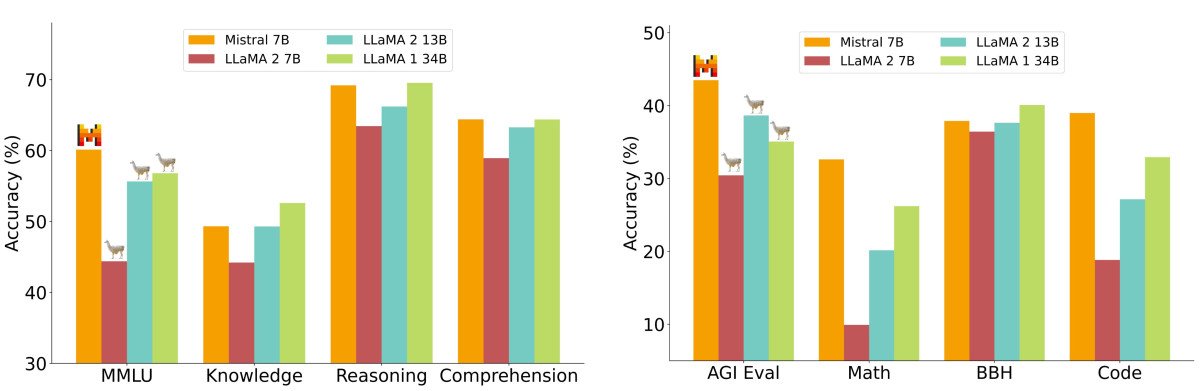
เกณฑ์ทดสอบแบ่งเป็นการให้เหตุผลด้วยสามัญสำนึก ความรู้เกี่ยวกับโลก ความเข้าใจในการอ่าน คณิตศาสตร์ และโค้ด เป็นต้น ตัวชี้วัดที่น่าสนใจคือ «ขนาดโมเดลเทียบเท่า» ซึ่งสะท้อนความคุ้มค่าต่อประสิทธิภาพ ในการให้เหตุผลและความเข้าใจ Mistral 7B ทำได้ใกล้เคียง Llama 2 ที่ใหญ่กว่าสามเท่า จึงอาจประหยัดหน่วยความจำและเพิ่มปริมาณงานที่ประมวลผลได้ แต่ด้านความรู้ทำได้ใกล้ Llama 2 13B ซึ่งบทความเชื่อว่าเกี่ยวข้องกับข้อจำกัดจำนวนพารามิเตอร์และการบีบอัดความรู้
สิ่งที่ทำให้ Mistral 7B ดีกว่าโมเดลภาษาอื่นๆ ส่วนใหญ่
การทำให้กลไกการให้ความสนใจง่ายขึ้น
แนวคิดพื้นฐานของกลไกการให้ความสนใจค่อนข้างง่าย สมมติว่าคุณกำลังอ่านหนังสือและเน้นย้ำประโยคที่สำคัญ นี่คือตัวอย่างของวิธีการที่กลไกการให้ความสนใจ “เน้นย้ำ” หรือให้ความสำคัญกับข้อมูลบางส่วนในลำดับ
ในบริบทของโมเดลภาษา กลไกเหล่านี้ช่วยให้โมเดลสามารถมุ่งเน้นไปที่ส่วนที่เกี่ยวข้องมากที่สุดของข้อมูลเข้า และทำให้ผลลัพธ์มีความสอดคล้องและแม่นยำในบริบท
ในทรานส์ฟอร์เมอร์มาตรฐาน คะแนนความสนใจคำนวณจากสูตรต่อไปนี้

สูตรความสนใจของทรานส์ฟอร์เมอร์
ขั้นตอนสำคัญของสูตรคือการคูณเมทริกซ์ Q และ K เมื่อความยาวลำดับเพิ่มขึ้น เมทริกซ์ทั้งสองก็ขยายตาม ทำให้ใช้การคำนวณสูง ปัญหาการขยายขนาดนี้เป็นเหตุผลสำคัญที่ทรานส์ฟอร์เมอร์มาตรฐานทำงานช้าเมื่อจัดการลำดับยาว

กลไกความสนใจช่วยให้โมเดลเน้นส่วนเฉพาะของข้อมูลนำเข้า โดยทั่วไปใช้ «หัว» เพื่อจัดการความสนใจ จำนวนหัวที่มากขึ้นทำให้แยกแยะได้ละเอียดขึ้น แต่เพิ่มความซับซ้อนและเวลา อ่านเพิ่มเติมเกี่ยวกับทรานส์ฟอร์เมอร์และความสนใจได้ที่นี่
ความสนใจแบบหลายคำค้น (MQA) เร่งการประมวลผลด้วยการใช้หัวคีย์–ค่าเพียงชุดเดียว แต่อาจลดคุณภาพลง การรวมความเร็วของ MQA กับคุณภาพของความสนใจแบบหลายหัวจึงเป็นแนวคิดเบื้องหลัง GQA
การให้ความสนใจแบบกลุ่ม (GQA)

ความสนใจแบบจัดกลุ่มคำค้น
GQA เป็นทางสายกลาง โดยจัดหัวคีย์–ค่าเป็นกลุ่ม แทนการใช้เพียงหัวเดียวหรือแยกหัวทั้งหมด จึงให้ประสิทธิภาพใกล้เคียงความสนใจแบบหลายหัว แต่มีความเร็วใกล้ MQA สำหรับ Mistral นี่หมายถึงการทำงานอย่างมีประสิทธิภาพโดยไม่ลดคุณภาพลงมากนัก
การให้ความสนใจแบบหน้าต่างเลื่อน (SWA)

หน้าต่างเลื่อนเป็นอีกวิธีประมวลผลความสนใจของลำดับ โดยใช้หน้าต่างขนาดคงที่รอบแต่ละโทเคน เมื่อซ้อนหลายชั้น ชั้นบนจะเห็นบริบทกว้างขึ้นจนรับข้อมูลจากอินพุตทั้งหมดได้ คล้ายเขตรับสัญญาณในโครงข่ายประสาทเทียมแบบคอนโวลูชัน (CNN)
ส่วนความสนใจแบบหน้าต่างเลื่อนที่ขยายช่วงของ Longformer ซึ่งมีแนวคิดคล้ายกัน จะคำนวณเพียงบางแนวทแยงของเมทริกซ์ ทำให้หน่วยความจำเพิ่มแบบเชิงเส้นแทนกำลังสอง และเหมาะกับลำดับยาวกว่า
ความโปร่งใสของ Mistral AI เทียบกับความกังวลเรื่องความปลอดภัยในกระบวนการกระจาย
ในประกาศของ Mistral AI ยังเน้นย้ำถึงความโปร่งใส โดยระบุว่า “ไม่มีการหลอกลวง ไม่มีข้อมูลที่เป็นกรรมสิทธิ์” แต่ในขณะเดียวกัน โมเดลที่มีอยู่ในขณะนี้ ‘Mistral-7B-v0.1’ เป็นโมเดลฐานที่ฝึกมาแล้ว ดังนั้นจึงสามารถสร้างคำตอบสำหรับคำถามใดๆ ได้โดยไม่มีการกลั่นกรองเนื้อหา จึงมีข้อกังวลด้านความปลอดภัย ต่างจากโมเดล GPT และ Llama ที่มีกลไกพิจารณาว่าควรตอบเมื่อใด การกระจายอำนาจของ Mistral อาจถูกผู้ไม่หวังดีใช้ประโยชน์ อย่างไรก็ตาม การกระจายโมเดลภาษาขนาดใหญ่ก็มีข้อดี แม้อาจถูกใช้ในทางที่ผิด ผู้คนก็สามารถนำไปสร้างประโยชน์ต่อสังคมและทำให้ทุกคนเข้าถึงความสามารถของ AI ได้
ความยืดหยุ่นในการใช้งาน
จุดเด่นอีกอย่างหนึ่งคือ Mistral 7B มีใบอนุญาต Apache 2.0 ซึ่งหมายความว่าไม่มีข้อจำกัดในการใช้งาน ไม่ว่าคุณจะใช้เพื่อประโยชน์ส่วนตัว องค์กรขนาดใหญ่ หรือแม้กระทั่งหน่วยงานรัฐบาล คุณเพียงต้องมีระบบที่เหมาะสมในการใช้งานหรืออาจต้องลงทุนในทรัพยากรบนคลาวด์
ยังมีใบอนุญาตอื่น เช่น MIT ที่เรียบง่ายกว่า และ CC BY-SA-4.0 ที่กำหนดให้ระบุผู้สร้างและใช้ใบอนุญาตลักษณะเดียวกันกับงานดัดแปลง ขณะที่ Apache 2.0 ให้พื้นฐานที่แข็งแกร่งสำหรับโครงการขนาดใหญ่
ความคิดสุดท้าย
การเกิดขึ้นของโมเดลภาษาขนาดใหญ่แบบ Open-Source เช่น Mistral 7B เป็นการเปลี่ยนแปลงที่สำคัญในอุตสาหกรรม AI ทำให้โมเดลภาษาที่มีคุณภาพสูงสามารถเข้าถึงได้ง่ายขึ้น แนวทางใหม่ของ Mistral เช่น GQA และ SWA สัญญาว่าจะเพิ่มประสิทธิภาพโดยไม่ลดคุณภาพ
ในขณะที่ธรรมชาติแบบกระจายของ Mistral อาจมีความท้าทายบางอย่าง แต่ความยืดหยุ่นและใบอนุญาตที่เปิดกว้างทำให้มีศักยภาพในการทำให้ AI มีความเข้าถึงได้มากขึ้น
เมื่อเทคโนโลยีพัฒนาต่อไป การสร้างสมดุลระหว่างพลังของโมเดลกับจริยธรรมและกลไกความปลอดภัยย่อมเป็นประเด็นสำคัญ สำหรับก้าวถัดไป Mistral มองว่า 7B เป็นเพียงจุดเริ่มต้น และตั้งใจเปิดตัวโมเดลที่ใหญ่ขึ้น หากทำได้ดีพอกับ 7B ทีมงานก็อาจก้าวขึ้นเป็นผู้เล่นสำคัญภายในปีแรก ตามมุมมองของบทความในเวลานั้น


