พื้นฐาน AI
วิธีการทำงานของเอเจนต์ AI: โมเดล, เครื่องมือ, หน่วยความจำ, และลูปควบคุม
คุณภาพของเอเจนต์จึงขึ้นอยู่กับการออกแบบระบบ, สิทธิ์, และการประเมินเท่ากับที่มันพึ่งพาโมเดลพื้นฐาน. ส่วนย่อ: เอเจนต์ AI รวมโมเดลกับคำสั่ง, เครื่องมือ, หน่วยความจำ, และลูปควบคุม. การเข้าใจว่าชิ้นส่วนเหล่านี้ทำงานร่วมกันอย่างไรอธิบายทั้งพลังของเอเจนต์และวิธีที่มันล้มเหลว.

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
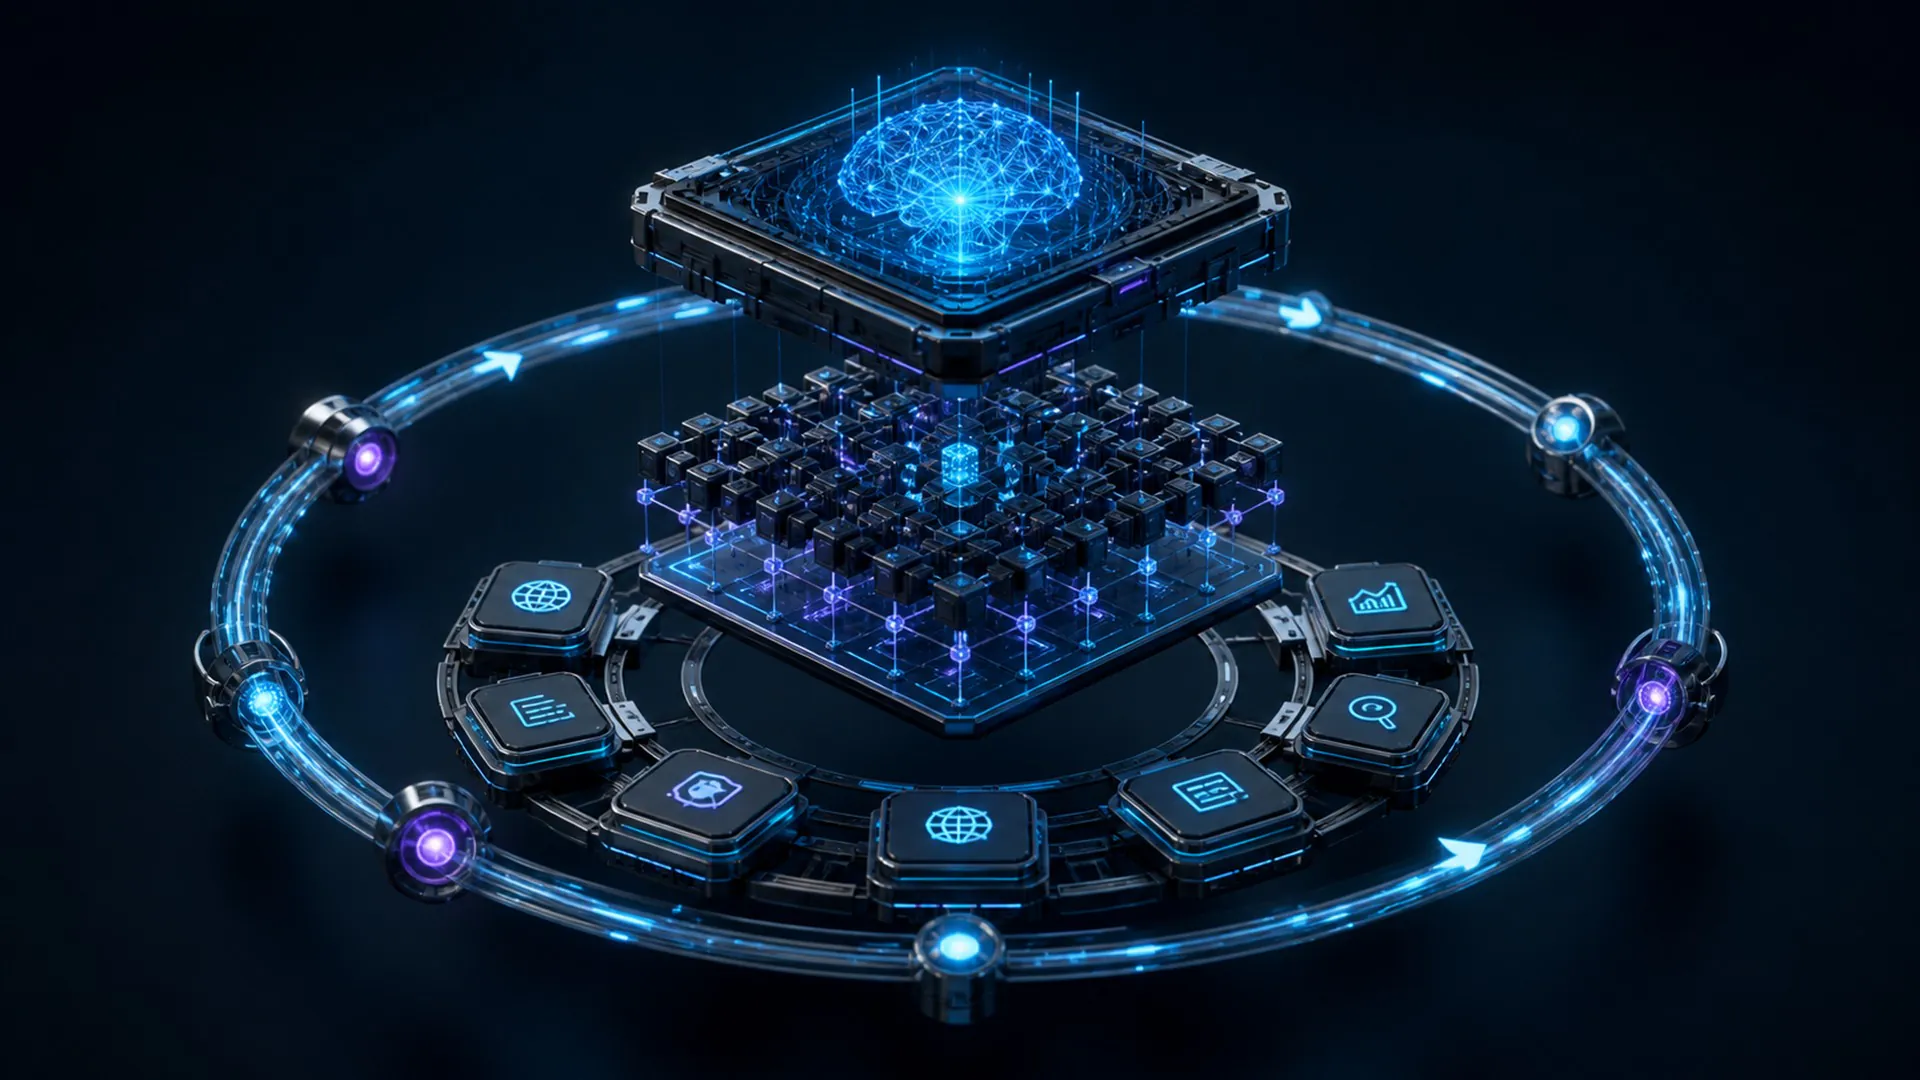
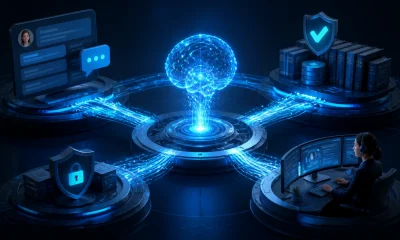
เอเจนต์ AI ทำงานโดยการรวมโมเดลกับคำสั่ง, เครื่องมือ, หน่วยความจำ, และลูปควบคุมที่ตัดสินใจว่าจะทำอะไรต่อไปอย่างต่อเนื่อง โมเดลให้ความสามารถในการตัดสินใจและภาษา, ขณะที่ซอฟต์แวร์รอบข้างแปลงความสามารถเหล่านั้นให้เป็นกระบวนการที่มีสถานะซึ่งสามารถทำงาน, ตรวจสอบผลลัพธ์, ฟื้นฟูจากข้อผิดพลาด, และหยุดได้.
การทำความเข้าใจสถาปัตยกรรมนี้มีประโยชน์มากกว่าการมองเอเจนต์เป็นวัตถุอัจฉริยะเดียว. ความสำเร็จและความล้มเหลวส่วนใหญ่เกิดจากวิธีที่ส่วนประกอบทำงานร่วมกัน: โมเดลที่ยอดเยี่ยมอาจถูกทำลายโดยเครื่องมือที่คลุมเครือ, หน่วยความจำที่ล้าสมัย, สิทธิ์ที่มากเกินไป, หรือ ลูปควบคุมที่ไม่มีการกำหนดการเสร็จสิ้นที่เชื่อถือได้.
ห้าส่วนสำคัญของเอเจนต์ AI
1. โมเดล
โมเดลตีความเป้าหมาย, วิเคราะห์บริบทที่มีอยู่, และเลือกการกระทำ. ในเอเจนต์หลาย ๆ ตัวในปัจจุบัน, โมเดลนี้คือโมเดลภาษาใหญ่ที่สามารถทำตามคำสั่งและสร้างการเรียกใช้เครื่องมือในรูปแบบโครงสร้างได้พร้อมกับภาษาธรรมชาติ.
โมเดลที่มีความสามารถสูงสุดไม่ได้หมายความว่าจะเป็นตัวเลือกที่ดีที่สุดสำหรับทุกขั้นตอน. ระบบอาจส่งการวางแผนที่ซับซ้อนไปยังโมเดลที่แข็งแกร่งกว่า, ใช้โมเดลที่เร็วกว่าเพื่อการจำแนก, และพึ่งพาโค้ดที่กำหนดผลลัพธ์เพื่อการตรวจสอบ. การผสมผสานนี้สามารถเพิ่มความเร็ว, ลดค่าใช้จ่าย, และเพิ่มความน่าเชื่อถือ.
2. คำสั่ง
คำสั่งกำหนดบทบาท, ขอบเขต, ความสำคัญ, และข้อกำหนดของผลลัพธ์ของเอเจนต์. คำสั่งอาจรวมถึงพรอมต์ระบบ, บริบทเฉพาะงาน, นโยบาย, ตัวอย่าง, คำอธิบายเครื่องมือ, และเกณฑ์การหยุด.
คำสั่งที่ดีเป็นเชิงปฏิบัติ. พวกมันบอกเอเจนต์ว่าต้องการหลักฐานอะไร, เมื่อใดควรขออนุมัติ, แหล่งข้อมูลใดที่ยอมรับได้, และวิธีการรับรู้ว่าการทำงานเสร็จสมบูรณ์. กฎที่คลุมเครือหรือขัดแย้งทำให้โมเดลต้องเดา, ส่งผลให้เกิดความไม่สอดคล้องในงานที่คล้ายกัน.
3. เครื่องมือ
เครื่องมือเชื่อมต่อโมเดลกับความสามารถที่อยู่นอกบริบทปัจจุบันของมัน. เครื่องมืออาจทำการค้นหาเว็บ, ดึงข้อมูลลูกค้า, รันโค้ด, คำถามฐานข้อมูล, ควบคุมเบราว์เซอร์, หรือสร้างเหตุการณ์ในปฏิทิน.
โมเดลโดยปกติจะไม่ดำเนินฟังก์ชันด้วยตนเอง. มันเลือกเครื่องมือที่มีชื่อและเสนออาร์กิวเมนต์ในรูปแบบโครงสร้าง. ระบบรันไทม์ของเอเจนต์ตรวจสอบความถูกต้องของคำขอ, ตรวจสอบสิทธิ์, ดำเนินการ, และส่งผลลัพธ์กลับ. การแยกนี้เป็นสิ่งสำคัญ: มันให้ซอฟต์แวร์มีโอกาสปฏิเสธการกระทำที่ผิดรูปหรือไม่ปลอดภัยก่อนที่มันจะส่งผลต่อโลกภายนอก.
4. สถานะและหน่วยความจำ
สถานะคือข้อมูลที่เอเจนต์ต้องการระหว่างการทำงานปัจจุบัน: เป้าหมาย, การสนทนา, แผน, การสังเกต, ผลลัพธ์จากเครื่องมือ, และขั้นตอนที่เสร็จสมบูรณ์. หน่วยความจำขยายแนวคิดนี้โดยเก็บข้อมูลที่มีประโยชน์นอกบริบททันที, เช่น ความชอบก่อนหน้า, ข้อเท็จจริงที่เกิดซ้ำ, หรือบทเรียนจากงานก่อนหน้า.
หน่วยความจำที่มากกว่าไม่จำเป็นต้องดีกว่าเสมอ. บันทึกที่ไม่เกี่ยวข้องจะใช้บริบทและอาจทำให้โมเดลพุ่งไปสู่สมมติฐานที่ล้าสมัย. ระบบหน่วยความจำที่มีประสิทธิภาพจะตัดสินใจว่าอะไรควรเก็บ, จัดระเบียบอย่างไร, ควรดึงคืนเมื่อไหร่, และจัดการกับข้อมูลที่ขัดแย้งหรือหมดอายุอย่างไร.
5. ลูปควบคุม
ลูปควบคุมเป็นชั้นการประสานงานที่ทำให้กระบวนการดำเนินต่อไป. มันส่งสถานะปัจจุบันไปยังโมเดล, รับการกระทำที่เสนอ, รันเครื่องมือที่ได้รับการอนุมัติ, บันทึกการสังเกต, และเรียกโมเดลอีกครั้ง.
Anthropic อธิบายเอเจนต์ว่าเป็นโมเดลภาษาที่เสริมความสามารถและทำงานเป็นวงรอบ พร้อมความสามารถอย่างการค้นคืนข้อมูล เครื่องมือ และหน่วยความจำ ในคู่มือเกี่ยวกับ การสร้างเอเจนต์ที่มีประสิทธิภาพส่วน OpenAI อธิบายการทำงานของเอเจนต์ในทำนองเดียวกันว่าเป็นปฏิสัมพันธ์ต่อเนื่องระหว่างโมเดล เครื่องมือ และสภาพแวดล้อม ใน จากโมเดลสู่เอเจนต์.
อินเทอร์เฟซสำคัญเท่ากับส่วนประกอบ
แผนภาพสถาปัตยกรรมอาจทำให้แต่ละส่วนดูแยกจากกันอย่างชัดเจน, แต่ความน่าเชื่อถือจริงขึ้นอยู่กับสัญญาระหว่างส่วนเหล่านั้น. โมเดลต้องการคำอธิบายเครื่องมือที่แยกความสามารถที่คล้ายกัน. ระบบรันไทม์ต้องการอาร์กิวเมนต์ที่กำหนดประเภทและสถานะข้อผิดพลาดที่ชัดเจน. การดึงข้อมูลจากหน่วยความจำต้องการข้อมูลแหล่งที่มาและความสดใหม่. ตัวตรวจสอบการเสร็จสิ้นต้องการเกณฑ์ที่สามารถทดสอบได้ ไม่ใช่ความรู้สึกคลุมเครือว่าคำตอบเพียงพอ.
ลองพิจารณาเครื่องมือค้นหาที่คืนรายการว่าง. ผลลัพธ์นั้นอาจหมายถึงไม่มีบันทึกที่เกี่ยวข้อง, คำค้นหาผิดรูปแบบ, ผู้ใช้ไม่มีสิทธิ์, หรือบริการหมดเวลา. หากเครื่องมือรวมสี่เงื่อนไขนี้เป็นผลลัพธ์เดียว, โมเดลจะไม่สามารถวิเคราะห์เหตุการณ์ได้อย่างน่าเชื่อถือ. อินเทอร์เฟซที่ออกแบบดีจะคืนหลักฐานในรูปแบบโครงสร้าง: สถานะ, แหล่งที่มา, เวลา, คำค้น, จำนวนผลลัพธ์, และข้อผิดพลาดที่เครื่องอ่านได้เมื่อเหมาะสม.
หลักการเดียวกันนี้ใช้กับบริบท. คำสั่ง, บันทึกที่มีอำนาจ, ส่วนที่ดึงมา, โน้ตที่โมเดลสร้าง, และเนื้อหาภายนอกที่ไม่เชื่อถือได้ไม่ควรถูกมองว่าเป็นข้อความเท่ากัน. การระบุแหล่งที่มาและอำนาจช่วยให้ระบบรันไทม์บังคับใช้นโยบายและช่วยให้โมเดลประเมินหลักฐานได้อย่างถูกต้อง. นี่คือรูปแบบปฏิบัติของการออกแบบบริบท: การตัดสินใจไม่เพียงแต่ว่าโมเดลจะเห็นข้อมูลอะไร, แต่ข้อมูลนั้นจัดระเบียบอย่างไรและระบบอนุญาตให้ควบคุมอะไร.
ตัวอย่างขั้นตอนต่อขั้นตอน
ลองนึกภาพเอเจนต์ที่ถูกขอให้เปรียบเทียบผู้จัดจำหน่ายสามรายที่เป็นไปได้และจัดทำคำแนะนำ.
| โมเดล | ตีความบริบทและเสนอการกระทำต่อไป. |
|---|---|
| รันไทม์ | ตรวจสอบความถูกต้องของการเรียก, ดำเนินเครื่องมือ, และส่งคืนการสังเกต. |
| หน่วยความจำ | เก็บสถานะที่เลือกระหว่างขั้นตอนหรือเซสชัน. |
| ลูปควบคุม | ตัดสินใจว่าจะดำเนินต่อ, ลองใหม่, ยกระดับ, หรือหยุด. |
- รับเป้าหมาย: เอเจนต์อ่านเกณฑ์การตัดสินใจ, กำหนดเวลา, งบประมาณ, และผลลัพธ์ที่ต้องการ.
- ตรวจสอบบริบทที่มีอยู่: มันตรวจว่าชื่อผู้จัดจำหน่าย, ความต้องการภายใน, และเอกสารต้นทางมีหรือไม่.
- สร้างแผน: มันตัดสินใจรวบรวมข้อมูลราคา, ความปลอดภัย, เงื่อนไขการให้บริการ, และหลักฐานจากลูกค้าสำหรับแต่ละผู้จัดจำหน่าย.
- เลือกเครื่องมือ: มันค้นหาที่เก็บเอกสารที่ได้รับการอนุมัติหรือเรียกเครื่องมือวิจัยภายนอก.
- สังเกต: ระบบรันไทม์ส่งผลลัพธ์กลับ, รวมถึงข้อผิดพลาดหรือฟิลด์ที่หายไป.
- อัปเดตสถานะ: เอเจนต์บันทึกสิ่งที่เรียนรู้และทำเครื่องหมายคำถามที่ยังไม่ได้แก้ไข.
- ปรับตัว: มันเปลี่ยนคำค้น, ปรึกษาแหล่งข้อมูลอื่น, หรือขอให้บุคคลให้เอกสารที่ไม่มีอยู่.
- ตรวจสอบ: มันตรวจให้แน่ใจว่าคำแนะนำทุกข้อได้รับการสนับสนุนและการเปรียบเทียบใช้เกณฑ์เดียวกัน.
- หยุดหรือขออนุมัติ: มันสร้างร่างคำแนะนำ, แต่ปล่อยการตัดสินใจซื้อให้กับผู้ที่ได้รับอนุญาต.
ประเด็นสำคัญคือลำดับขั้นตอนไม่ได้ถูกเขียนโค้ดตายตัวทั้งหมด. ระบบเลือกขั้นตอนตามสิ่งที่พบ, แต่ยังทำงานภายในขอบเขตที่ออกแบบไว้.
การวางแผนไม่จำเป็นต้องเป็นขั้นตอนแยก
เอเจนต์บางตัวสร้างแผนเต็มก่อนดำเนินการ. อื่น ๆ ตัดสินใจทีละขั้นตอน. หลาย ๆ ตัวใช้แบบผสม: สร้างแผนคร่าว ๆ, ดำเนินการต่อไป, และปรับแผนที่เหลือเมื่อได้รับการสังเกต.
แผนที่ยาวและแข็งกรากอาจล้าสมัยหลังจากผลลัพธ์ที่ไม่คาดคิดครั้งแรก. เอเจนต์ที่ทำงานแบบตอบสนองอย่างเดียวอาจหลงทางหรือทำงานซ้ำ. การออกแบบเชิงปฏิบัติควรรักษาการวางแผนให้พอเพื่อคงทิศทางพร้อมให้มีการวางแผนใหม่เมื่อสภาพแวดล้อมเปลี่ยนแปลง.
กรอบงาน ReAct เป็นตัวอย่างพื้นฐานของการสลับการให้เหตุผลกับการกระทำและการสังเกต. ข้อสังเกตสำคัญคือผลลัพธ์ภายนอกสามารถแก้ไข, ปรับปรุง, หรือเปลี่ยนทิศทางของขั้นตอนการให้เหตุผลต่อไป.
เอเจนต์รู้ว่าเมื่อไหร่ควรหยุด
การหยุดเป็นปัญหาการออกแบบระบบ. โมเดลอาจประกาศความสำเร็จเร็วเกินไป, ดำเนินการปรับปรุงต่อเมื่อบรรลุเป้าหมาย, หรือวนลูปเมื่อเครื่องมือล้มเหลวซ้ำ ๆ.
เอเจนต์ที่น่าเชื่อถือรวมกลไกการหยุดหลายแบบ:
- เกณฑ์การเสร็จสิ้น: เงื่อนไขชัดเจนเช่นฟิลด์ที่จำเป็น, การทดสอบที่ผ่าน, หรืออ้างอิงที่ตรวจสอบแล้ว.
- งบประมาณ: ขีดจำกัดของขั้นตอน, เวลา, โทเคนโมเดล, การเรียกเครื่องมือ, หรือค่าใช้จ่าย.
- เกณฑ์ข้อผิดพลาด: การยกระดับหลังจากความล้มเหลวซ้ำหรือการสังเกตที่ความมั่นใจต่ำ.
- ประตูอนุมัติ: การหยุดชั่วคราวก่อนการกระทำที่มีผลกระทบสูงหรือไม่สามารถย้อนกลับได้.
- ตัวตรวจสอบภายนอก: การตรวจสอบที่กำหนดผลลัพธ์หรือโมเดลแยกที่ประเมินว่าผลลัพธ์ตรงตามงานหรือไม่.
สถาปัตยกรรมเอเจนต์ทั่วไป
ลูปเอเจนต์เดี่ยว เป็นการออกแบบที่ง่ายที่สุด: โมเดลเดียวใช้เครื่องมือซ้ำ ๆ จนเสร็จ. ง่ายต่อการดีบักและมักเพียงพอ.
เราเตอร์ จำแนกคำขอและส่งไปยังพรอมต์, ชุดเครื่องมือ, หรือโมเดลที่เชี่ยวชาญ. การกำหนดเส้นทางลดตัวเลือกที่ไม่เกี่ยวข้องและสามารถใช้แนวนโยบายที่แตกต่างกันกับงานที่ต่างกัน.
สถาปัตยกรรมผู้จัดระเบียบ-ผู้ทำงาน ให้เอเจนต์หลักสร้างงานย่อยและมอบหมายให้ผู้ทำงาน, จากนั้นสังเคราะห์ผลลัพธ์ของพวกเขา. สิ่งนี้มีประโยชน์เมื่องานสามารถทำพร้อมกันหรือต้องการความเชี่ยวชาญที่แตกต่าง, แต่จะเพิ่มการใช้โทเคนและโหมดความล้มเหลวของการประสานงาน.
ลูปผู้ประเมิน-ผู้เพิ่มประสิทธิภาพ แยกการสร้างจากการวิจารณ์. ส่วนหนึ่งสร้างคำตอบ; อีกส่วนหนึ่งตรวจสอบตามเกณฑ์ที่กำหนด; ส่วนแรกปรับปรุงคำตอบ. วิธีนี้ทำงานดีเมื่อคุณภาพวัดได้และการปรับปรุงผ่านการทำซ้ำคุ้มค่ากับค่าใช้จ่ายเพิ่มเติม.
สิ่งที่มักเกิดผิดพลาด
- คำอธิบายเครื่องมือที่ไม่ดี: โมเดลเลือกความสามารถผิดหรือให้อาร์กิวเมนต์ที่ไม่ถูกต้อง.
- บริบทไม่มีขอบเขต: รายงานยาวเต็มไปด้วยรายละเอียดที่ไม่เกี่ยวข้องและซ่อนข้อมูลสำคัญ.
- ข้อผิดพลาดของเครื่องมือที่เงียบ: ผลลัพธ์ว่างหรือบางส่วนถูกเข้าใจว่าเป็นการสังเกตที่ถูกต้อง.
- การอ้างอิงอ่อนแอ: เอเจนต์ทำงานบนสมมติฐานแทนการตรวจสอบระบบบันทึก.
- อิสระมากเกินไป: เอเจนต์สามารถทำการกระทำที่มีผลสำคัญโดยไม่มีขอบเขตการตรวจสอบที่เหมาะสม.
- ไม่มีการประเมินเส้นทาง: ทีมประเมินคำตอบสุดท้ายแต่ไม่ตรวจสอบว่เอเจนต์มาถึงอย่างไร.
หลักการออกแบบสำหรับเอเจนต์ที่เชื่อถือได้
เริ่มด้วยสถาปัตยกรรมที่เล็กที่สุดที่สามารถแก้งานได้. กระบวนการทำงานที่กำหนดผลลัพธ์ควรจัดการขั้นตอนที่รู้จัก; เก็บการตัดสินใจของโมเดลไว้สำหรับการตัดสินใจที่ต้องการการตีความจริง ๆ. ให้แต่ละเครื่องมือมีวัตถุประสงค์แคบ, อินพุตที่กำหนดประเภท, สถานะข้อผิดพลาดชัดเจน, และการเข้าถึงด้วยสิทธิ์น้อยที่สุด.
ทำให้สถานะมองเห็นได้. บันทึกการเรียกเครื่องมือทุกครั้ง, ผลลัพธ์, การลองใหม่, การอนุมัติ, และการตัดสินใจของโมเดลที่จำเป็นสำหรับการวินิจฉัย. บีบอัดบริบทเก่าแทนการต่อเติมอย่างไม่มีที่สิ้นสุด, และเก็บข้อมูลที่มีอำนาจแยกจากสรุปที่โมเดลสร้าง.
ออกแบบรันไทม์ให้ความล้มเหลวเป็นที่ชัดเจน. เครื่องมือควรแยก “ไม่พบบันทึก” จาก “การร้องขอล้มเหลว”, และที่เก็บสถานะควรแยกข้อเท็จจริงที่ตรวจสอบแล้วจากสรุปที่โมเดลสร้าง. มิฉะนั้น, โมเดลอาจถือการไม่มีข้อมูลที่เกิดจากการหมดเวลาเป็นหลักฐานว่าบางอย่างไม่มีอยู่.
สุดท้าย, ประเมินระบบทั้งหมด. ทำงานเดียวกันหลายครั้ง, วัดความสำเร็จและการใช้ทรัพยากร, และตรวจสอบเส้นทางสำหรับการละเมิดนโยบายหรือทางลัดที่เปราะบาง. คู่มือของ Anthropic เกี่ยวกับ การประเมินเอเจนต์ เน้นว่าเอเจนต์ต้องการงาน, การทดลองที่ทำซ้ำได้, รายงาน, และผู้ตรวจสอบ ไม่ใช่แค่การสาธิตที่น่าประทับใจไม่กี่ตัว.
สิ่งที่ควรจำเกี่ยวกับวิธีการทำงานของเอเจนต์ AI
เอเจนต์ AI คือลูปที่ออกแบบมา, ไม่ใช่แค่โมเดลอัจฉริยะ. โมเดลตัดสินใจ; เครื่องมือทำงาน; หน่วยความจำเก็บสถานะ; สภาพแวดล้อมส่งหลักฐาน; และลูปควบคุมกำหนดว่าจะเกิดอะไรต่อไป.
เมื่อส่วนเหล่านั้นมีอินเทอร์เฟซและขอบเขตที่ชัดเจน, เอเจนต์สามารถจัดการงานที่เปิดกว้างที่ระบบอัตโนมัติแบบดั้งเดิมไม่คาดคิด. เมื่อไม่มี, ความอิสระเพิ่มความคลุมเครือ. ดังนั้นคุณภาพของเอเจนต์ขึ้นอยู่กับการออกแบบระบบ, สิทธิ์, และการประเมินเท่ากับโมเดลพื้นฐาน.