
พื้นฐาน AI
โมเดลการเรียนรู้ของเครื่องเชิงสร้างและเชิงแยกแยะ

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
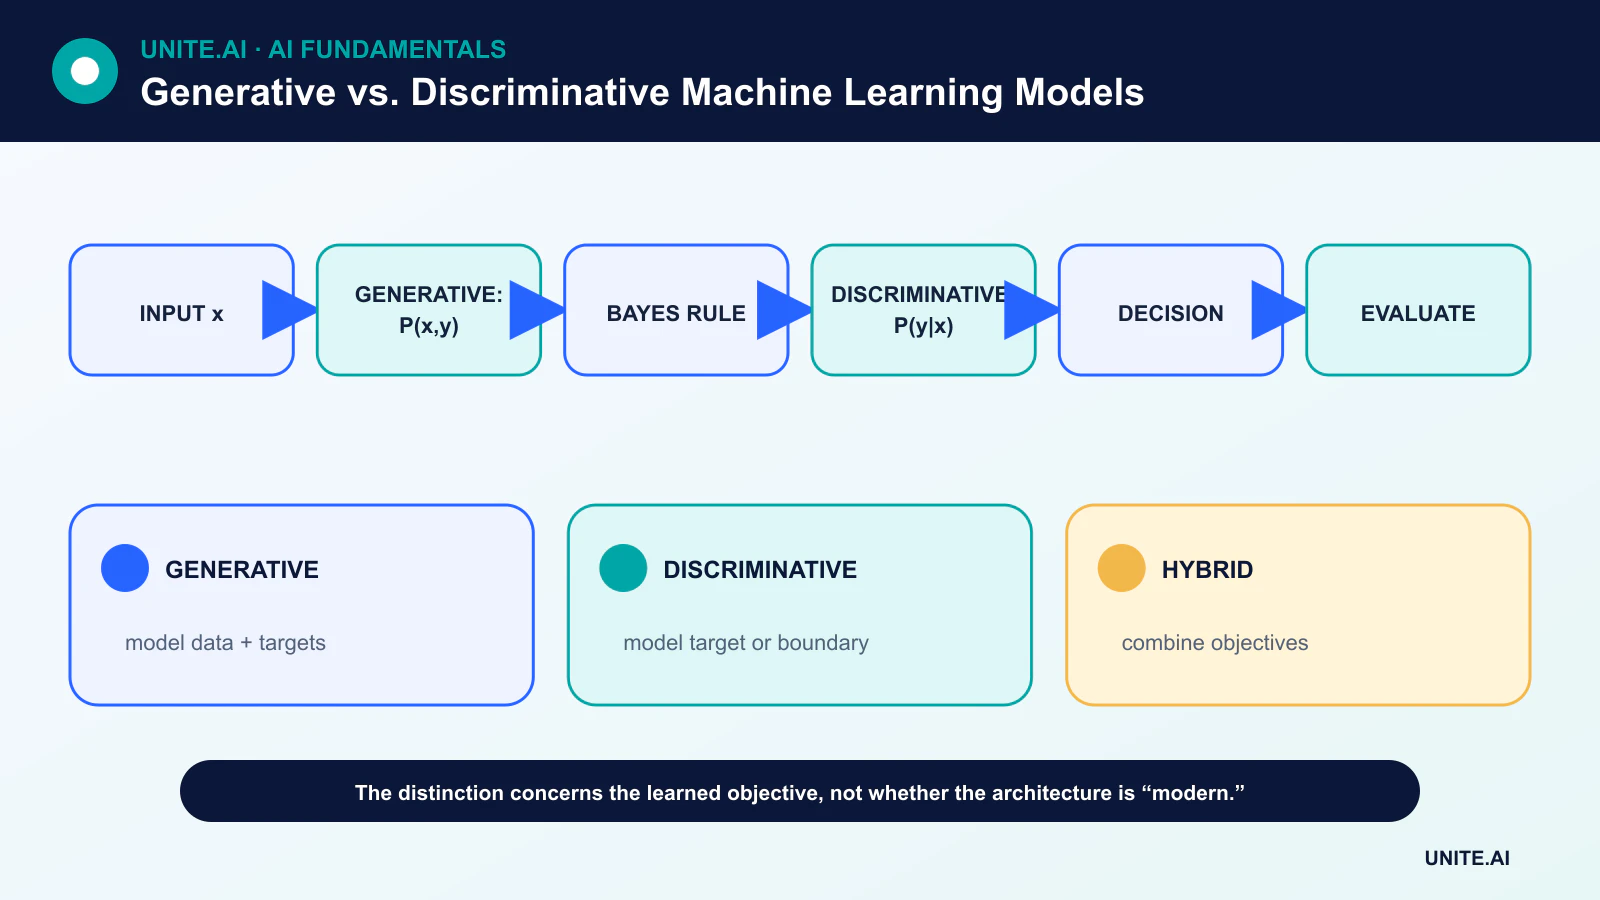
Generative และ discriminative อธิบายว่ารุ่นเรียนรู้อะไรเกี่ยวกับข้อมูลและเป้าหมาย ในการจำแนกแบบมีผู้สอนแบบดั้งเดิม โมเดลเชิงสร้างจะเรียนรู้การกระจายร่วมเช่น P(x, y) หรือการกระจายตามคลาส P(x|y) ส่วนโมเดลเชิงแยกแยะจะเรียนรู้ P(y|x) หรือเส้นแบ่งการตัดสินใจโดยตรง
ความแตกต่างนี้มีประโยชน์ แต่ระบบสมัยใหม่มักผสานวัตถุประสงค์เข้าด้วยกัน โมเดลสามารถเรียนรู้การแทนเชิงสร้างแล้วต่อมาปรับแต่งเพื่อการทำนายเชิงแยกแยะ หรือใช้โครงสร้างหลักเดียวกันสำหรับการสร้างและการจำแนก
ประเด็นสำคัญ
- โมเดลจำแนกเชิงสร้างจำลองวิธีที่อินพุตและป้ายกำกับเกิดขึ้น; โมเดลจำแนกเชิงแยกแยะจำลองป้ายกำกับจากอินพุตหรือเส้นแบ่ง
- สมมติฐานเชิงสร้างอาจช่วยเมื่อมีข้อมูลที่มีป้ายกำกับจำกัด แต่ก็อาจผิดพลาดได้
- วิธีเชิงแยกแยะมักมุ่งความจุไปที่งานทำนายและอาจทำให้ข้อผิดพลาดการจำแนกในระยะยาวดีขึ้น
- GAN, VAE และโมเดลภาษาเป็นระบบเชิงสร้าง แต่คำว่า “เชิงสร้าง” ไม่ได้หมายความว่าทุกส่วนเป็นโมเดลจำแนกเชิงสร้าง
การแยกตัวประกอบของความน่าจะเป็น
โมเดลจำแนกเชิงสร้างสามารถประมาณค่า P(x|y) และ P(y) แล้วใช้ ทฤษฎีของเบย์ส เพื่อหาค่า P(y|x) ตัวอย่างคลาสสิกคือ Naive Bayes โมเดลจำแนกเชิงแยกแยะเช่นโลจิสติกรีเกรสชันประมาณค่า P(y|x) โดยตรง; SVM จะเรียนรู้เส้นแบ่งแยก
การสร้างแบบจำลอง P(x,y) เป็นงานที่กว้างกว่าการทำนาย y จาก x โครงสร้างเพิ่มเติมนี้สามารถสนับสนุนการสุ่มตัวอย่างหรือการให้เหตุผลกับข้อมูลที่ขาดหายได้ แต่ก็ต้องอาศัยสมมติฐานเกี่ยวกับการกระจายของอินพุต
ประสิทธิภาพของข้อมูลและพฤติกรรมในระยะยาว
การเปรียบเทียบของ Ng และ Jordan ระหว่าง Naive Bayes กับโลจิสติกรีเกรสชันเปิดเผยการแลกเปลี่ยนที่มีประโยชน์: ภายใต้สมมติฐานของพวกเขา โมเดลเชิงสร้างสามารถเข้าใกล้ประสิทธิภาพสูงสุดได้ด้วยตัวอย่างน้อยกว่า ในขณะที่โมเดลเชิงแยกแยะสามารถบรรลุข้อผิดพลาดในระยะยาวที่ต่ำกว่า
นี่ไม่ใช่การจัดอันดับที่ใช้ได้กับทุกกรณี ผลลัพธ์ขึ้นอยู่กับว่าโมเดลครอบครัวนั้นเหมาะกับข้อมูลหรือไม่, มิติ, การทำ regularization, วิธีการเพิ่มประสิทธิภาพและคุณภาพของป้ายกำกับ การเปรียบเทียบเชิงประจักษ์บนการออกแบบการตรวจสอบที่เป็นตัวแทนยังคงจำเป็น
กลุ่มโมเดลที่เป็นตัวแทน
โมเดลเชิงสร้างรวมถึงการกระจายตามคลาส, โมเดลมาร์คอฟซ่อน, โมเดลผสม, ออโต้เอนโค้ดเดอร์เชิงแปรผัน, โมเดลภาษาที่อัตโนมัติเกิดขึ้น, โมเดลการแพร่กระจายและ GAN
โมเดลเชิงแยกแยะรวมถึงโลจิสติกรีเกรสชัน, ต้นไม้ตัดสินใจ, คอนดิชันแนล แรนดอม ฟิลด์, เครื่องเวกเตอร์สนับสนุน และตัวจำแนกแบบประสาทเทียม โครงประสาทเดียวกันสามารถอยู่ในหมวดใดหมวดหนึ่งได้ขึ้นอยู่กับวัตถุประสงค์การฝึกและผลลัพธ์
ระบบไฮบริดและการเรียนรู้ด้วยตนเองแบบไม่มีผู้สอน
โมเดลภาษา หรือวิชันที่ผ่านการฝึกล่วงหน้าสามารถเรียนรู้จากข้อมูลที่ไม่มีป้ายกำกับด้วยวัตถุประสงค์เชิงสร้างหรือการเรียนรู้ด้วยตนเอง แล้วต่อด้วยหัวเชิงแยกแยะสำหรับงานเป้าหมาย วิธีกึ่งมีผู้สอนอาจปรับแต่งการจำแนกที่มีป้ายกำกับและวัตถุประสงค์ข้อมูลไม่มีป้ายกำกับพร้อมกัน
การผสมผสานทำให้ป้ายกำกับสถาปัตยกรรมมีข้อมูลน้อยกว่ากระบวนการฝึกทั้งหมด เอกสารควรระบุวัตถุประสงค์, ข้อมูล, ผลลัพธ์และการสรุปที่ตั้งใจ—not เพียงแค่เรียกโมเดลว่าเชิงสร้าง
การเลือกใช้วิธีการ
ใช้ลักษณะงานเป็นเกณฑ์ หากเป้าหมายคือเส้นแบ่งที่เทียบเท่าและมีป้ายกำกับมาก โมเดลเชิงแยกแยะเป็นฐานที่ธรรมชาติ หากต้องการการสุ่มตัวอย่าง, การประมาณความหนาแน่น, โครงสร้างข้อมูลที่ขาดหายหรือข้อมูลไม่มีป้ายกำกับเป็นแกนหลัก ส่วนประกอบเชิงสร้างอาจช่วยได้
เปรียบเทียบความทนทาน, ประสิทธิภาพการใช้ตัวอย่าง, การคำนวณ, ความน่าจะเป็นหรือการเทียบเท่า ตามความเหมาะสม ตัวอย่างที่สร้างได้ดีไม่พิสูจน์ว่าเป็นตัวจำแนกที่ดี และตัวจำแนกที่แม่นยำสูงไม่หมายความว่าเป็นแบบจำลองการกระจายอินพุตที่เป็นจริง
ทิศทางของความน่าจะเป็นและวัตถุประสงค์การสร้างแบบจำลอง
โมเดลเชิงแยกแยะเรียนรู้เส้นแบ่งหรือการกระจายแบบมีเงื่อนไข P(y|x): จากคุณลักษณะ x ทำนายป้ายกำกับ y โลจิสติกรีเกรสชัน, เครื่องเวกเตอร์สนับสนุน, คอนดิชันแนล แรนดอม ฟิลด์ และตัวจำแนกหลายชนิดเป็นแบบเชิงแยกแยะ โมเดลเชิงสร้างเรียนรู้การกระจายร่วม P(x,y), การกระจายตามคลาส P(x|y) หรือการกระจายข้อมูลโดยไม่มีเงื่อนไข ซึ่งทำให้สามารถสุ่มตัวอย่างหรือทำงานที่เกี่ยวกับความน่าจะเป็นได้ Naive Bayes และ Linear Discriminant Analysis เป็นโมเดลจำแนกเชิงสร้าง; GAN, Variational Autoencoders, Diffusion Models และโมเดลอัตโนมัติเกิดขึ้นสร้างข้อมูลผ่านวัตถุประสงค์ที่ต่างกัน
ความแตกต่างนี้เกี่ยวกับการสร้างแบบจำลองการกระจายหรือกฎการตัดสินใจ ไม่ได้เกี่ยวกับการใช้เครือข่ายประสาทเทียมหรือไม่ โมเดลภาษาเชิงสร้างสามารถถูกกระตุ้นให้ทำการจำแนกได้ ในขณะที่ตัวจัดเรียงผลลัพธ์เชิงแยกแยะสามารถชี้นำการสร้าง สมมติฐานเชิงสร้างอาจเพิ่มประสิทธิภาพของข้อมูลหรือจัดการตัวแปรที่ขาดหายได้ แต่ก็เสี่ยงต่อการกำหนดโมเดลผิดพลาด วิธีเชิงแยกแยะมักทำได้ดีเมื่อมีข้อมูลที่มีป้ายกำกับมากเพราะมุ่งตรงที่เส้นแบ่งการทำนาย เปรียบเทียบกลุ่มโมเดลโดยให้คุณลักษณะ, ข้อมูล, การปรับแต่งและการคำนวณเท่าเทียมกัน แทนการมองว่าหมวดใดหมวดหนึ่งเหนือกว่าโดยทั่วไป
การฝึกและการประเมินตามกรณีการใช้งาน
การประเมินการจำแนกใช้ความแม่นยำ, การเรียกคืน, การเทียบเท่า, ความทนทานและต้นทุนข้อผิดพลาด การประเมินเชิงสร้างต้องพิจารณาความถูกต้อง, ความหลากหลาย, ความครอบคลุม, ความน่าจะเป็นหรือประโยชน์ของงาน, การจดจำและความปลอดภัย โมเดลอาจสร้างตัวอย่างที่ดึงดูดแต่สูญเสียโหมดบางส่วน หรือได้ความน่าจะเป็นดีแต่ผลลัพธ์ที่รับรู้แย่ การใช้ประโยชน์จากข้อมูลสังเคราะห์ควรทดสอบโดยฝึกและประเมินโมเดลต่อเนื่องบนข้อมูลจริงที่เป็นอิสระ รวมถึงกลุ่มที่หายาก ควรเก็บข้อมูลทดสอบออกจากพรอมต์และการคัดเลือกการสร้าง
ในการเรียนรู้กึ่งมีผู้สอน โมเดลเชิงสร้างอาจใช้โครงสร้างข้อมูลที่ไม่มีป้ายกำกับ; ในการตรวจจับความผิดปกติ ความน่าจะเป็นอาจล้มเหลวเมื่อข้อมูลนอกการกระจายได้รับความหนาแน่นสูงด้วยเหตุผลที่ไม่เกี่ยวข้อง ในการสร้างที่เสริมด้วยการดึงข้อมูล โมเดลตอบเชิงสร้างและตัวดึงข้อมูลหรือจัดเรียงผลลัพธ์เชิงแยกแยะจะสร้างระบบไฮบริด วินิจฉัยแต่ละขั้นตอนแยกกันเพื่อให้ผลลัพธ์ที่คล่องแคล่วไม่ปกปิดความล้มเหลวของการดึงข้อมูล เลือกการแยกส่วนที่ทำให้หลักฐานและการควบคุมเป็นที่มองเห็นได้
การใช้งานและการกำกับดูแล
ระบบเชิงสร้างเพิ่มความเสี่ยงด้านที่มาของเนื้อหา, สิทธิ์ทรัพย์สินทางปัญญา, การปลอมแปลง, การฉีดพรอมต์, และการควบคุมผลลัพธ์; ระบบเชิงแยกแยะเพิ่มความเสี่ยงด้านเกณฑ์, การปฏิเสธ, และข้อผิดพลาดที่ไม่เท่าเทียม ทั้งสองต้องมีสิทธิ์ข้อมูล, ศูนย์ข้อมูลที่ปลอดภัย, การเวอร์ชัน, การทดสอบที่เป็นตัวแทน, การเฝ้าติดตาม, และอำนาจของมนุษย์ที่สอดคล้องกับผลกระทบ ติดตามวัตถุประสงค์ที่ชัดเจนและความหมายของผลลัพธ์ในเอกสาร ความแตกต่างระหว่างเชิงสร้างและเชิงแยกแยะเป็นประโยชน์ทางสถิติ แต่ระบบจริงมักผสานกันและความน่าเชื่อถือขึ้นอยู่กับทั้งสายข้อมูลและกระบวนการตัดสินใจทั้งหมด
ตัวอย่างการทำงาน: การจำแนกและการสร้างข้อความตอบสนับสนุน
แพลตฟอร์มสนับสนุนใช้ตัวจำแนกเชิงแยกแยะเพื่อระบุประเภทปัญหาและความเร่งด่วน และใช้โมเดลเชิงสร้างเพื่อร่างข้อความตอบตามนโยบายที่อนุมัติ ตัวจำแนกจะถูกประเมินด้วยการเรียกคืนเฉพาะคลาสและการเทียบเท่า; ตัวดึงข้อมูลด้วยการเรียกคืนหลักฐาน; ตัวสร้างด้วยความเป็นพื้นฐาน, ความถูกต้อง, และการปฏิเสธ แต่ละขั้นตอนมีผลลัพธ์ที่ไม่ทราบล่วงหน้า และโมเดลเชิงสร้างไม่สามารถเปลี่ยนแปลงการจำแนกหรือสิทธิของลูกค้าผ่านข้อความชักชวนได้
เจ้าหน้าที่เห็นเส้นทางที่คาดการณ์, แหล่งข้อมูล, และร่างข้อความเพื่ออนุมัติหรือแก้ไขก่อนส่ง ตัวกรองสิทธิ์ทำงานก่อนการดึงข้อมูล และการฉีดพรอมต์ในข้อความของลูกค้าไม่สามารถให้สิทธิ์เครื่องมือได้ การเฝ้าติดตามแยกความผิดพลาดของการกำหนดเส้นทาง, ช่องว่างการดึงข้อมูล, คำพูดที่ไม่ได้รับการสนับสนุน, และการแก้ไขของเจ้าหน้าที่ การเปลี่ยนนโยบายจะอัปเดตแหล่งข้อมูลทันทีและกระตุ้นการทดสอบรีเกรสชัน; การปรับแต่งสงวนไว้สำหรับพฤติกรรมที่เสถียร การออกแบบไฮบริดใช้จุดแข็งของเชิงแยกแยะและเชิงสร้างพร้อมคงไว้ซึ่งหลักฐานและอำนาจของมนุษย์
หลักฐานการนำไปใช้และความพร้อมในการปฏิบัติการ
การตัดสินใจในขั้นตอนการผลิตต้องการมากกว่าการสาธิตที่ประสบความสำเร็จ กำหนดผู้ใช้เป้าหมาย, สภาพแวดล้อมการทำงาน, อินพุต, เอาต์พุต, การพึ่งพา, เจ้าของ, และผลของความล้มเหลวสำคัญแต่ละรายการ สร้างฐานข้อมูลที่ทำซ้ำได้และชุดการประเมินที่มีเวอร์ชันก่อนการปรับแต่ง ทดสอบกรณีทั่วไป, เงื่อนไขขอบ, อินพุตที่ผิดรูปหรือหายไป, การเปลี่ยนแปลงการกระจาย, การขัดข้องของการพึ่งพา, การใช้ผิดวัตถุประสงค์, และกลุ่มหรือสภาพแวดล้อมที่อาจไม่ได้รับการสนับสนุนอย่างเพียงพอ วัดคุณภาพงานพร้อมกับการเทียบเท่า หรือความไม่แน่นอน, ความหน่วง, ปริมาณการประมวลผล, ต้นทุนทรัพยากร, การเข้าถึง, ความเป็นส่วนตัวและความปลอดภัย บันทึกการแปลงและเกณฑ์ทุกขั้นตอนเพื่อให้ผู้ตรวจสอบอิสระสามารถทำซ้ำผลลัพธ์และแยกแยะหลักฐานจากต้นแบบที่ดึงดูด
ก่อนเปิดใช้งาน ให้มอบอำนาจสำหรับการปล่อย, ข้อยกเว้น, การเปลี่ยนแปลง, การย้อนกลับ, และการยกเลิก ใช้การเปิดตัวแบบขั้นเป็นขั้นเพื่อรักษาการสำรองที่ปลอดภัยและตรวจสอบการเฝ้าติดตามด้วยความล้มเหลวที่ถูกใส่เข้าไปโดยเจตนา ระบบเทเลเมตรีการปฏิบัติงานควรเปิดเผยคุณภาพอินพุต, พฤติกรรมเอาต์พุต, เวอร์ชันของโมเดลหรือกฎ, สถานะการพึ่งพา, การแทรกแซงของมนุษย์, และผลลัพธ์ที่ยืนยันโดยไม่เก็บข้อมูลที่ละเอียดอ่อนที่ไม่จำเป็น กำหนดเกณฑ์การแจ้งเตือนและผู้รับผิดชอบการตอบสนอง แล้วตรวจสอบหลักฐานจากโลกจริงหลังการใช้งานแทนการสันนิษฐานว่าประสิทธิภาพออฟไลน์จะคงอยู่ ประเมินใหม่เมื่อแหล่งข้อมูล, ผู้ใช้, โมเดล, ผู้จำหน่าย, นโยบาย, ฮาร์ดแวร์ หรือวัตถุประสงค์เปลี่ยนแปลง ระบบที่ดูแลต้องมีเอกสารการกู้คืน, การเรียนรู้จากเหตุการณ์, ขั้นตอนการลบและการเก็บรักษา, และจุดชัดเจนที่ควรปิดการทำงานหรือแทนที่
คำถามที่พบบ่อย
ตัวแยกแยะของ GAN เป็นโมเดลเชิงแยกแยะหรือไม่?
มันทำหน้าที่แยกแยะระหว่างการฝึกเท่านั้น แต่ GAN ทั้งหมดเป็นกรอบงานเชิงสร้างที่ผลลัพธ์ถูกสร้างโดยตัวสร้าง
การเรียนรู้เชิงแยกแยะเป็นการเรียนรู้ที่มีผู้สอนเสมอหรือไม่?
ไม่ คำนี้อธิบายความสัมพันธ์หรือเส้นแบ่งที่ถูกสร้างแบบเชิงแยกแยะ ส่วนการมีผู้สอนอธิบายสัญญาณการฝึก วัตถุประสงค์สมัยใหม่อาจทำให้หมวดหมู่เหล่านี้คลุมเงือก
อ้างอิงหลัก












