โมเดลและแพลตฟอร์ม AI
DiffSeg : การแบ่งส่วนภาพแบบ Zero-Shot โดยไม่ต้องมีการกำกับข้อมูลโดยใช้ Stable Diffusion

 เพิ่ม Unite.AI ลงในแหล่งข้อมูลที่คุณต้องการบน Google
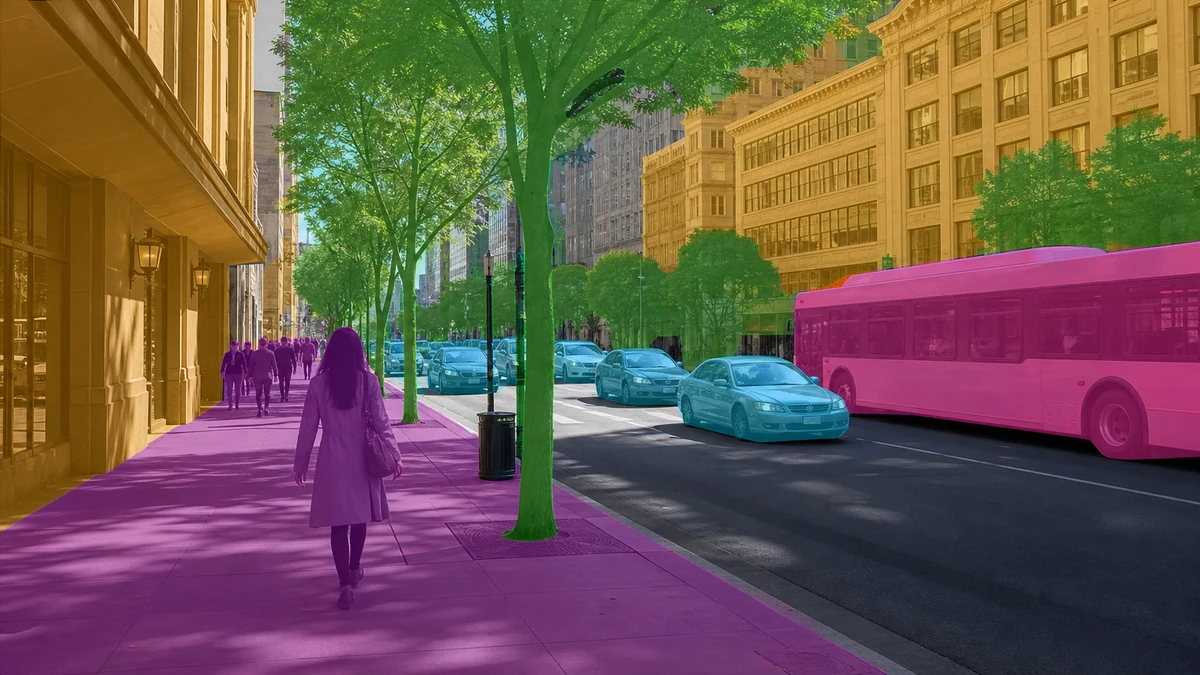
หนึ่งในความท้าทายหลักในการสร้างแบบจำลองการมองเห็นด้วยคอมพิวเตอร์คือการสร้างมาสก์แบ่งส่วนภาพที่มีคุณภาพสูง การพัฒนาล่าสุดในการฝึกอบรมแบบกำกับข้อมูลขนาดใหญ่ทำให้สามารถแบ่งส่วนภาพแบบ Zero-Shot ได้หลากหลายรูปแบบ นอกจากนี้ การฝึกอบรมแบบไม่ต้องมีการกำกับข้อมูลยังทำให้การแบ่งส่วนภาพง่ายขึ้นโดยไม่ต้องมีการกำกับข้อมูลอย่างกว้างขวาง อย่างไรก็ตาม การสร้างเฟรมเวิร์กการมองเห็นด้วยคอมพิวเตอร์ที่สามารถแบ่งส่วนภาพใดๆ ในสถานการณ์ Zero-Shot โดยไม่ต้องมีการกำกับข้อมูลยังคงเป็นงานที่ซับซ้อน การแบ่งส่วนภาพเชิงความหมาย เป็นแนวคิดพื้นฐานในการสร้างแบบจำลองการมองเห็นด้วยคอมพิวเตอร์ ซึ่งเกี่ยวข้องกับการแบ่งภาพออกเป็นบริเวณที่มีความหมายเหมือนกัน เทคนิคนี้เป็นพื้นฐานสำหรับงานที่หลากหลาย เช่น การถ่ายภาพทางการแพทย์ การแก้ไขภาพ การขับขี่อัตโนมัติ และอื่นๆ 
เพื่อพัฒนาการสร้างแบบจำลองการมองเห็นด้วยคอมพิวเตอร์ มันจำเป็นที่การแบ่งส่วนภาพจะไม่จำกัดอยู่ในเซตข้อมูลที่มีหมวดหมู่จำกัด แต่ควรเป็นงานพื้นฐานที่หลากหลายสำหรับการใช้งานอื่นๆ อย่างไรก็ตาม ค่าใช้จ่ายในการเก็บฉลากบนพิกเซลต่อพิกเซลเป็นความท้าทายที่สำคัญ ซึ่งจำกัดการพัฒนาของวิธีการแบ่งส่วนภาพแบบ Zero-Shot และแบบกำกับข้อมูลที่ไม่ต้องมีการกำกับข้อมูลหรือการเข้าถึงข้อมูลล่วงหน้า ในบทความนี้ เราจะพูดถึงวิธีการที่ชั้น Self-Attentionในแบบจำลอง Stable Diffusion สามารถช่วยให้สร้างแบบจำลองที่สามารถแบ่งส่วนภาพใดๆ ในสถานการณ์ Zero-Shot โดยไม่ต้องมีการกำกับข้อมูลอย่างเหมาะสม ชั้น Self-Attentionเหล่านี้เข้าใจแนวคิดของวัตถุที่ได้เรียนรู้จากแบบจำลอง Stable Diffusionที่ได้รับการฝึกอบรมล่วงหน้า
DiffSeg : อัลกอริทึมแบ่งส่วนภาพแบบ Zero-Shot ที่ได้รับการปรับปรุง
การแบ่งส่วนภาพเชิงความหมาย เป็นกระบวนการที่แบ่งภาพออกเป็นหลายส่วน โดยแต่ละส่วนมีเซมานติกส์ที่เหมือนกัน เทคนิคนี้เป็นพื้นฐานสำหรับงานที่หลากหลาย ตามแนวทางดั้งเดิม การทำงานการมองเห็นด้วยคอมพิวเตอร์แบบ Zero-Shot มักจะพึ่งพาการแบ่งส่วนภาพแบบกำกับข้อมูล โดยใช้เซตข้อมูลขนาดใหญ่ที่มีหมวดหมู่ที่ได้รับการกำกับข้อมูลและฉลาก อย่างไรก็ตาม การนำการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลไปใช้ในสถานการณ์ Zero-Shot ยังคงเป็นความท้าทาย ในขณะที่วิธีการแบบกำกับข้อมูลแบบดั้งเดิมมีประสิทธิภาพ แต่ค่าใช้จ่ายในการกำกับข้อมูลพิกเซลต่อพิกเซลมักจะสูงเกินไป ซึ่งเน้นย้ำถึงความจำเป็นในการพัฒนาวิธีการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลในสถานการณ์ที่ไม่จำกัด โดยที่แบบจำลองไม่ต้องการข้อมูลที่ได้รับการกำกับข้อมูลหรือการเข้าถึงข้อมูลล่วงหน้า
เพื่อแก้ไขข้อจำกัดนี้ DiffSeg เสนอวิธีการประมวลผลภายหลังแบบใหม่ โดยใช้ความสามารถของ Stable Diffusion เพื่อสร้างแบบจำลองแบ่งส่วนภาพทั่วไปที่ถ่ายโอนแบบ Zero-Shot ไปยังภาพใดๆ ได้ แบบจำลอง Stable Diffusion แสดงประสิทธิภาพในการสร้างภาพความละเอียดสูงตามข้อความพรอมป์ต์ สำหรับภาพที่สร้างขึ้น แบบจำลองเหล่านี้สามารถสร้างมาสก์แบ่งส่วนภาพด้วยพรอมป์ต์ที่สอดคล้องกัน ซึ่งโดยทั่วไปครอบคลุมเฉพาะวัตถุเด่นในส่วนหน้าของภาพ
ในทางตรงกันข้าม DiffSeg เป็นวิธีการประมวลผลภายหลังที่สร้างมาสก์แบ่งส่วนภาพจากเทนเซอร์แอตเทนชันในชั้น Self-Attention ของแบบจำลองดิฟฟิวชัน อัลกอริทึมประกอบด้วยสามส่วนหลัก ได้แก่ การผสานแอตเทนชันแบบวนซ้ำ การรวมแอตเทนชัน และการระงับค่าที่ไม่ใช่ค่าสูงสุด (Non-Maximum Suppression) ตามภาพต่อไปนี้

อัลกอริทึม DiffSeg รักษาข้อมูลที่มองเห็นได้ตลอดหลายความละเอียดโดยการรวมเทนเซอร์การให้ความสนใจ 4 มิติพร้อมความสอดคล้องเชิงพื้นที่ และใช้กระบวนการรวมแบบวนซ้ำโดยการสุ่มตัวอย่างจุดยึด จุดยึดเหล่านี้ทำหน้าที่เป็นพื้นฐานสำหรับการรวมมาสก์การให้ความสนใจที่มีจุดยึดวัตถุเดียวกันซึ่งจะถูกดูดซับในที่สุด กระบวนการรวมนี้ถูกควบคุมโดยวิธีการ KL divergence เพื่อวัดความคล้ายคลึงกันระหว่างแผนที่การให้ความสนใจสองแผนที่
เมื่อเปรียบเทียบกับวิธีการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลที่ใช้การรวมกลุ่ม DiffSeg ไม่ต้องการให้ผู้ใช้ระบุจำนวนกลุ่มล่วงหน้า และแม้ไม่มีการเข้าถึงข้อมูลล่วงหน้า อัลกอริทึม DiffSeg ก็สามารถสร้างการแบ่งส่วนภาพได้โดยไม่ต้องใช้ทรัพยากรเพิ่มเติมโดยรวม อัลกอริทึม DiffSeg เป็น วิธีการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลและแบบ Zero-Shot ที่ใหม่ ซึ่งใช้แบบจำลอง Stable Diffusionที่ได้รับการฝึกอบรมล่วงหน้า และสามารถแบ่งส่วนภาพได้โดยไม่ต้องมีการกำกับข้อมูลหรือการเข้าถึงข้อมูลล่วงหน้า
DiffSeg : แนวคิดพื้นฐาน
DiffSeg เป็นอัลกอริทึมที่ใหม่ซึ่งสร้างขึ้นจากความเข้าใจของแบบจำลองการแพร่กระจาย การแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูล และการแบ่งส่วนภาพแบบ Zero-Shot
แบบจำลองการแพร่กระจาย
อัลกอริทึม DiffSeg สร้างขึ้นจากความเข้าใจของแบบจำลองการแพร่กระจายที่ได้รับการฝึกอบรมล่วงหน้า แบบจำลองการแพร่กระจายเป็นหนึ่งในเฟรมเวิร์กการสร้างที่ได้รับความนิยมมากที่สุดสำหรับการสร้างแบบจำลองการมองเห็นด้วยคอมพิวเตอร์ และได้เรียนรู้กระบวนการแพร่กระจายไปข้างหน้าและย้อนกลับจากภาพที่มีสัญญาณรบกวนแบบเกาส์เซียนที่มีสมบัติเหมือนกันทุกทิศทางที่ตัวอย่างไปจนถึงการสร้างภาพ แบบจำลอง Stable Diffusionเป็นรูปแบบที่ได้รับความนิยมมากที่สุดของแบบจำลองการแพร่กระจาย และใช้ในการทำงานที่หลากหลาย รวมถึงการแบ่งส่วนภาพแบบกำกับข้อมูล การจำแนกภาพแบบ Zero-Shot การจับคู่ความสอดคล้องเชิงความหมาย การแบ่งส่วนภาพที่ใช้ข้อมูลกำกับอย่างมีประสิทธิภาพ และการแบ่งส่วนภาพแบบเปิดคำศัพท์ อย่างไรก็ตาม ปัญหาเดียวที่มีในการใช้แบบจำลองการแพร่กระจายคือการพึ่งพาคุณลักษณะที่มีมิติสูงในการทำงานเหล่านี้ และมักต้องการการฝึกอบรมเพิ่มเติมเพื่อให้ได้ประโยชน์จากคุณลักษณะเหล่านี้อย่างเต็มที่
การแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูล
อัลกอริทึม DiffSeg มีความเกี่ยวข้องกับการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูล ซึ่งเป็นแนวปฏิบัติสมัยใหม่ของ AI ที่มุ่งหมายเพื่อสร้างมาสก์แบ่งส่วนภาพที่หนาแน่นโดยไม่ต้องใช้การกำกับข้อมูล อย่างไรก็ตาม เพื่อให้ได้ผลลัพธ์ที่ดี แบบจำลองการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลต้องการการฝึกอบรมแบบไม่ต้องมีการกำกับข้อมูลบางอย่างบนเซตข้อมูลเป้าหมาย แบบจำลองการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลสามารถแบ่งออกเป็นสองประเภท: การรวมกลุ่มโดยใช้แบบจำลองที่ได้รับการฝึกอบรมล่วงหน้า และการรวมกลุ่มตามความไม่เปลี่ยนแปลง กลุ่มแรกใช้คุณลักษณะเชิงจำแนกที่แบบจำลองซึ่งฝึกไว้ล่วงหน้าเรียนรู้มาเพื่อสร้างมาสก์แบ่งส่วนภาพ ส่วนกลุ่มที่สองใช้อัลกอริทึมจัดกลุ่มทั่วไปที่ปรับสารสนเทศร่วมระหว่างภาพสองภาพให้เหมาะสม เพื่อแบ่งภาพเป็นกลุ่มเชิงความหมายและหลีกเลี่ยงการแบ่งส่วนภาพที่เสื่อมสภาพ
การแบ่งส่วนภาพแบบ Zero-Shot
อัลกอริทึม DiffSeg มีความเกี่ยวข้องกับการแบ่งส่วนภาพแบบ Zero-Shot ซึ่งเป็นวิธีการที่สามารถแบ่งส่วนภาพใดๆ โดยไม่ต้องฝึกบนข้อมูลเป้าหมายหรือมีความรู้เกี่ยวกับข้อมูลนั้นล่วงหน้า แบบจำลองการแบ่งส่วนภาพแบบ Zero-Shot ได้แสดงให้เห็นถึงความสามารถในการถ่ายโอนแบบ Zero-Shot ที่น่าประทับใจในระยะหลัง แม้ว่าจะต้องการข้อความและคำแนะนำในการแบ่งส่วนภาพ ในทางกลับกัน อัลกอริทึม DiffSeg ใช้แบบจำลองการแพร่กระจายเพื่อสร้างการแบ่งส่วนภาพโดยไม่ต้องมีการสืบค้นและการสังเคราะห์ภาพหลายภาพหรือการรู้จักเนื้อหาของวัตถุ
DiffSeg : วิธีการและสถาปัตยกรรม
อัลกอริทึม DiffSeg ใช้ชั้น Self-Attentionในแบบจำลอง Stable Diffusionที่ได้รับการฝึกอบรมล่วงหน้าเพื่อสร้างงานแบ่งส่วนภาพที่มีคุณภาพสูง
แบบจำลอง Stable Diffusion
แบบจำลอง Stable Diffusionเป็นแนวคิดพื้นฐานในเฟรมเวิร์ก DiffSeg แบบจำลอง Stable Diffusionเป็นเฟรมเวิร์กการสร้าง AI ที่ได้รับความนิยมมากที่สุด และเป็นหนึ่งในแบบจำลองการแพร่กระจายที่ได้รับความนิยมมากที่สุด หนึ่งในคุณลักษณะหลักของแบบจำลองการแพร่กระจายคือการผ่านไปข้างหน้าและย้อนกลับ ในการผ่านไปข้างหน้า มีการเพิ่มสัญญาณรบกวนแบบเกาส์เซียนที่มีสมบัติเหมือนกันทุกทิศทางเล็กน้อยไปยังภาพที่แต่ละขั้นตอนจนกระทั่งภาพกลายเป็นภาพสัญญาณรบกวนแบบเกาส์เซียนที่มีสมบัติเหมือนกันทุกทิศทาง ในทางกลับกัน ในการผ่านย้อนกลับ แบบจำลองการแพร่กระจายจะลบสัญญาณรบกวนแบบเกาส์เซียนที่มีสมบัติเหมือนกันทุกทิศทางออกจากภาพสัญญาณรบกวนแบบเกาส์เซียนที่มีสมบัติเหมือนกันทุกทิศทางเพื่อฟื้นฟูภาพเดิมโดยไม่มีสัญญาณรบกวนแบบเกาส์เซียนที่มีสมบัติเหมือนกันทุกทิศทาง
เฟรมเวิร์ก Stable Diffusionใช้การออกแบบแบบ Encoder-Decoder และ U-Net โดยมีชั้นการให้ความสนใจ โดยใช้ Encoder เพื่อบีบอัดภาพลงในปริภูมิแฝงที่มีมิติเชิงพื้นที่ที่เล็กกว่า และใช้ Decoder เพื่อขยายภาพ U-Net ประกอบด้วยชุดของบล็อกแบบโมดูลาร์ โดยแต่ละบล็อกประกอบด้วยคอมโพเนนต์ใดคอมโพเนนต์หนึ่ง: ชั้น Transformer หรือชั้น ResNet
ส่วนประกอบและสถาปัตยกรรม
ชั้น Self-Attentionในแบบจำลองการแพร่กระจายจัดกลุ่มสารสนเทศของวัตถุที่มีอยู่ในรูปแบบของแผนที่การให้ความสนใจเชิงพื้นที่ และ DiffSeg เป็นวิธีการประมวลผลภายหลังที่ใหม่เพื่อรวมเทนเซอร์การให้ความสนใจเข้ากับมาสก์แบ่งส่วนภาพที่ถูกต้อง โดยมีกระบวนการที่ประกอบด้วยสามส่วนหลัก: การรวมการให้ความสนใจ การระงับค่าที่ไม่ใช่ค่าสูงสุด และการรวมการให้ความสนใจแบบวนซ้ำ
การรวมการให้ความสนใจ
สำหรับภาพเข้าที่ผ่านชั้น U-Net และ Encoder แบบจำลอง Stable Diffusionสร้างเทนเซอร์การให้ความสนใจทั้งหมด 16 ตัว โดยมี 5 ตัวสำหรับแต่ละมิติ จุดประสงค์หลักในการสร้างเทนเซอร์ 16 ตัวคือการรวมเทนเซอร์การให้ความสนใจเหล่านี้ที่มีความละเอียดต่างๆ เข้ากับเทนเซอร์ที่มีความละเอียดสูงสุด เพื่อให้บรรลุเป้าหมายนี้ อัลกอริทึม DiffSeg จัดการทั้งสี่มิติแตกต่างกัน
จากสี่มิติ สองมิติสุดท้ายของเทนเซอร์การให้ความสนใจมีความละเอียดที่แตกต่างกัน แต่สอดคล้องกันเชิงพื้นที่ เนื่องจากแผนที่พื้นที่ 2 มิติของเฟรมเวิร์ก DiffSeg สอดคล้องกับความสัมพันธ์ระหว่างตำแหน่งและตำแหน่งพื้นที่ ดังนั้น เฟรมเวิร์ก DiffSeg จึงสุ่มตัวอย่างใหม่ในสองมิตินี้ของแผนที่การให้ความสนใจทั้งหมดไปยังความละเอียดสูงสุด ซึ่งก็คือ 64 x 64 ในทางกลับกัน มิติแรกสองมิติแสดงถึงตำแหน่งอ้างอิงของแผนที่การให้ความสนใจตามที่แสดงในภาพต่อไปนี้

เนื่องจากมิติเหล่านี้แสดงถึงตำแหน่งของแผนที่การให้ความสนใจ จึงจำเป็นต้องรวมแผนที่การให้ความสนใจเหล่านี้ตามลำดับ นอกจากนี้ เพื่อให้แน่ใจว่าแผนที่การให้ความสนใจที่รวมกันมีการกระจายที่ถูกต้อง เฟรมเวิร์กจะทำให้การแจกแจงเป็นมาตรฐานหลังการรวมกัน โดยแต่ละแผนที่การให้ความสนใจจะได้รับน้ำหนักตามความละเอียด
การรวมการให้ความสนใจแบบวนซ้ำ
ในขณะที่จุดประสงค์หลักของการรวมการให้ความสนใจคือการคำนวณเทนเซอร์การให้ความสนใจ จุดประสงค์หลักคือการรวมแผนที่การให้ความสนใจในเทนเซอร์เข้ากับ ชุดข้อเสนอวัตถุ โดยแต่ละข้อเสนอประกอบด้วยหมวดหมู่พื้นผิวหรือวัสดุ (stuff) หรือการกระตุ้นของวัตถุเดียว วิธีแก้ปัญหาที่เสนอคือการนำอัลกอริทึม K-Means ไปใช้กับการกระจายที่ถูกต้องของเทนเซอร์เพื่อค้นหากลุ่มของวัตถุ อย่างไรก็ตาม การใช้ K-Means ไม่ใช่วิธีแก้ปัญหาที่เหมาะสมที่สุด เนื่องจากการรวมกลุ่ม K-Means ต้องการให้ผู้ใช้ระบุจำนวนกลุ่มล่วงหน้า นอกจากนี้ การใช้อัลกอริทึม K-Means อาจส่งผลให้ได้ผลลัพธ์ที่แตกต่างกันสำหรับภาพเดียวกัน เนื่องจากขึ้นอยู่กับการเริ่มต้นแบบสุ่ม เพื่อเอาชนะอุปสรรค เฟรมเวิร์ก DiffSeg เสนอการสร้างตัวอย่างกริดเพื่อสร้างข้อเสนอโดยการรวมแผนที่การให้ความสนใจแบบวนซ้ำ
การระงับค่าที่ไม่ใช่ค่าสูงสุด
ขั้นตอนก่อนหน้าของการรวมการให้ความสนใจแบบวนซ้ำให้ผลลัพธ์เป็นรายการข้อเสนอวัตถุในรูปแบบของแผนที่การให้ความสนใจหรือแผนที่ความน่าจะเป็น โดยแต่ละข้อเสนอประกอบด้วยการกระตุ้นของวัตถุ เฟรมเวิร์กใช้การระงับค่าที่ไม่ใช่ค่าสูงสุดเพื่อแปลงรายการข้อเสนอวัตถุเป็นมาสก์แบ่งส่วนภาพที่ถูกต้อง กระบวนการนี้มีประสิทธิภาพ เนื่องจากแต่ละองค์ประกอบในรายการเป็นแผนที่การกระจายความน่าจะเป็นแล้ว สำหรับทุกตำแหน่งเชิงพื้นที่ทั่วแผนที่ทั้งหมด อัลกอริทึมจะหาดัชนีของความน่าจะเป็นที่ใหญ่ที่สุด และกำหนดสมาชิกภาพตามดัชนีของแผนที่ที่สอดคล้องกัน
DiffSeg : การทดลองและผลลัพธ์
เฟรมเวิร์กที่ทำงานบนการแบ่งส่วนภาพแบบไม่ต้องมีการกำกับข้อมูลใช้สองมาตรฐานการแบ่งส่วนภาพ ได้แก่ Cityscapes และ COCO-stuff-27 มาตรฐานการแบ่งส่วนภาพ Cityscapes เป็นเซตข้อมูลการขับขี่อัตโนมัติที่มี 27 หมวดหมู่ระดับกลาง ในขณะที่มาตรฐานการแบ่งส่วนภาพ COCO-stuff-27 เป็นเวอร์ชันที่ได้รับการดูแลของเซตข้อมูล COCO-stuff เดิม ซึ่งรวมหมวดหมู่ วัตถุ 80 หมวดหมู่และพื้นผิวหรือวัสดุ 91 หมวดหมู่เข้าด้วยกันเป็น 27 หมวดหมู่ นอกจากนี้ เพื่อวิเคราะห์ประสิทธิภาพการแบ่งส่วนภาพ เฟรมเวิร์ก DiffSeg ใช้ค่าเฉลี่ยอัตราส่วนพื้นที่ส่วนทับซ้อนต่อพื้นที่รวม (mIoU) และความแม่นยำของพิกเซล (ACC) และเนื่องจากอัลกอริทึม DiffSeg ไม่สามารถให้ฉลากเชิงความหมายได้ จึงใช้อัลกอริทึมการจับคู่ฮังการีเพื่อจับคู่มาสก์การแบ่งส่วนภาพที่คาดการณ์ไว้กับมาสก์การแบ่งส่วนภาพที่แท้จริง ในกรณีที่จำนวนมาสก์การแบ่งส่วนภาพที่คาดการณ์ไว้มากกว่าจำนวนมาสก์การแบ่งส่วนภาพที่แท้จริง เฟรมเวิร์กจะพิจารณาการคาดการณ์ที่ไม่ตรงกันเหล่านี้เป็นผลลบลวง
นอกจากนี้ เฟรมเวิร์ก DiffSeg ยังเน้นย้ำถึงข้อกำหนดสามด้านสำหรับการอนุมานผล ได้แก่ การพึ่งพาภาษา (LD) การปรับตัวแบบไม่มีผู้สอน (UA) และภาพเสริม (AX) การพึ่งพาภาษาหมายถึงวิธีการต้องใช้ข้อความอธิบายเพื่ออำนวยความสะดวกในการแบ่งส่วนภาพสำหรับภาพ การปรับตัวแบบไม่มีผู้สอนหมายถึงวิธีการต้องใช้การฝึกอบรมแบบไม่ต้องมีการกำกับข้อมูลบนเซตข้อมูลเป้าหมาย ในขณะที่ภาพเสริมหมายถึงวิธีการต้องใช้ภาพเพิ่มเติมเป็นภาพสังเคราะห์หรือเป็นกลุ่มภาพอ้างอิง
ผลลัพธ์
บนมาตรฐานการแบ่งส่วนภาพ COCO เฟรมเวิร์ก DiffSeg รวมสองบรรทัดฐาน K-Means ได้แก่ K-Means-S และ K-Means-C บรรทัดฐาน K-Means-C รวม 6 กลุ่มที่คำนวณโดยการเฉลี่ยจำนวนวัตถุในภาพที่ประเมิน ในขณะที่บรรทัดฐาน K-Means-S ใช้จำนวนกลุ่มเฉพาะสำหรับแต่ละภาพตามจำนวนวัตถุในภาพที่แท้จริง และผลลัพธ์บนบรรทัดฐานทั้งสองนี้แสดงไว้ในภาพต่อไปนี้

ตามที่เห็นได้ บรรทัดฐาน K-Means มีประสิทธิภาพเหนือกว่าวิธีการที่มีอยู่ ซึ่งแสดงให้เห็นถึงประโยชน์ของการใช้เทนเซอร์การให้ความสนใจตนเอง สิ่งที่น่าสนใจคือ บรรทัดฐาน K-Means-S มีประสิทธิภาพเหนือกว่าบรรทัดฐาน K-Means-C ซึ่งบ่งชี้ว่าจำนวนกลุ่มเป็นไฮเปอร์พารามิเตอร์ที่สำคัญ และการปรับให้เหมาะสมเป็นสิ่งจำเป็นสำหรับแต่ละภาพ นอกจากนี้ แม้ว่าจะพึ่งพาเทนเซอร์การให้ความสนใจตนเองเท่ากัน เฟรมเวิร์ก DiffSeg ก็มีประสิทธิภาพเหนือกว่าบรรทัดฐาน K-Means ซึ่งแสดงให้เห็นถึงความสามารถของเฟรมเวิร์ก DiffSeg ในการให้การแบ่งส่วนภาพที่ดีกว่า และหลีกเลี่ยงข้อเสียของการใช้บรรทัดฐาน K-Means
บนเซตข้อมูล Cityscapes เฟรมเวิร์ก DiffSeg ให้ผลลัพธ์ที่คล้ายกับเฟรมเวิร์กที่ใช้ข้อมูลนำเข้าที่มีความละเอียดต่ำกว่า 320 ในขณะที่มีประสิทธิภาพเหนือเฟรมเวิร์กที่ใช้ข้อมูลนำเข้าที่มีความละเอียดสูงกว่า 512 ทั้งในด้านความแม่นยำและ mIoU

ตามที่กล่าวไว้ก่อนหน้านี้ เฟรมเวิร์ก DiffSeg ใช้หลายไฮเปอร์พารามิเตอร์ตามที่แสดงในภาพต่อไปนี้

การรวมการให้ความสนใจเป็นแนวคิดพื้นฐานที่ใช้ในเฟรมเวิร์ก DiffSeg และผลกระทบของการใช้น้ำหนักรวมที่แตกต่างกันแสดงไว้ในภาพต่อไปนี้ โดยมีความละเอียดของภาพคงที่

ตามที่สังเกตได้ แผนที่ที่มีความละเอียดสูงในภาพ (b) โดยมีแผนที่ 64 x 64 ให้การแบ่งส่วนภาพที่มีรายละเอียดมากที่สุด แม้ว่าการแบ่งส่วนเหล่านี้จะมีการแตกหักเล็กน้อย ในทางกลับกัน แผนที่ที่มีความละเอียดต่ำกว่า 32 x 32 มีแนวโน้มที่จะแบ่งส่วนภาพโดยไม่จำเป็น แม้ว่าจะส่งผลให้ได้การแบ่งส่วนภาพที่สอดคล้องกันมากขึ้น ในภาพ (d) แผนที่ที่มีความละเอียดต่ำล้มเหลวในการสร้างการแบ่งส่วนภาพ เนื่องจากภาพทั้งหมดถูกรวมเข้าด้วยกันเป็นวัตถุเดียวโดยใช้การตั้งค่าไฮเปอร์พารามิเตอร์ที่มีอยู่ สุดท้าย ภาพ (a) ที่ใช้กลยุทธ์การรวมแบบสัดส่วนให้ผลลัพธ์ที่มีรายละเอียดที่ดีขึ้นและความสอดคล้องที่สมดุล
ความคิดสุดท้าย
การแบ่งส่วนภาพแบบ Zero-Shot โดยไม่ต้องมีการกำกับข้อมูลยังคงเป็นหนึ่งในความท้าทายที่ยิ่งใหญ่ที่สุดสำหรับแบบจำลองการมองเห็นด้วยคอมพิวเตอร์ และแบบจำลองที่มีอยู่ต้องอาศัยการปรับตัวแบบไม่มีผู้สอนที่ไม่ใช่ Zero-Shot หรือทรัพยากรภายนอก เพื่อเอาชนะความท้าทายนี้ เราได้พูดถึงวิธีการที่ชั้น Self-Attentionในแบบจำลอง Stable Diffusion สามารถช่วยให้สร้างแบบจำลองที่สามารถแบ่งส่วนภาพใดๆ ในสถานการณ์ Zero-Shot โดยไม่ต้องมีการกำกับข้อมูลอย่างเหมาะสม ชั้น Self-Attentionเหล่านี้เข้าใจแนวคิดของวัตถุที่ได้เรียนรู้จากแบบจำลอง Stable Diffusionที่ได้รับการฝึกอบรมล่วงหน้า เราได้พูดถึง DiffSeg อีกด้วย ซึ่งเป็นวิธีการประมวลผลภายหลังที่ใหม่ซึ่งมีจุดมุ่งหมายเพื่อใช้เฟรมเวิร์ก Stable Diffusionในการสร้างแบบจำลองแบ่งส่วนภาพที่สามารถถ่ายโอนแบบ Zero-Shot ไปยังภาพใดๆ อัลกอริทึม DiffSeg พึ่งพา Inter-Attention Similarity และ Intra-Attention Similarity เพื่อรวมแผนที่การให้ความสนใจแบบวนซ้ำเข้ากับมาสก์แบ่งส่วนภาพที่ถูกต้องเพื่อให้ได้ผลลัพธ์ที่ดีที่สุดในมาตรฐานการแบ่งส่วนภาพที่ได้รับความนิยม