
AGI och framtidens AI
Vad är Turingtestet och varför är det viktigt?

 Lägg till Unite.AI bland dina föredragna källor på Google
Den Turingtestet växte fram ur Alan Turings 1950‑artikel “Computing Machinery and Intelligence”. Istället för att försöka definiera tänkande föreslog Turing ett imitation‑spel: en mänsklig förhörsledare utbyter skriftliga meddelanden med osedda deltagare och avgör vem som är människa och vem som är maskin.
Testet förblir inflytelserikt eftersom det omvandlar en abstrakt filosofisk fråga till en observerbar interaktion. Det är också begränsat: att framstå som människa i en konversation är inte samma sak som att vara sanningsenlig, kunnig, säker, medveten eller generellt intelligent.
Viktiga slutsatser
- Turings ursprungliga imitation‑spel är ett textbaserat beteendetest, inte en checklista över interna kognitiva egenskaper.
- Resultaten beror på utvärderaren, prompten, varaktigheten, deltagarinstruktionerna och poängregeln.
- En modell kan imitera mänsklig konversation samtidigt som den hallucinerar fakta eller misslyckas i enkla robusthetstester.
- Modern utvärdering kräver uppgiftsmått, adversarial‑testning, mänsklig granskning och risk‑specifik evidens utöver konversation.
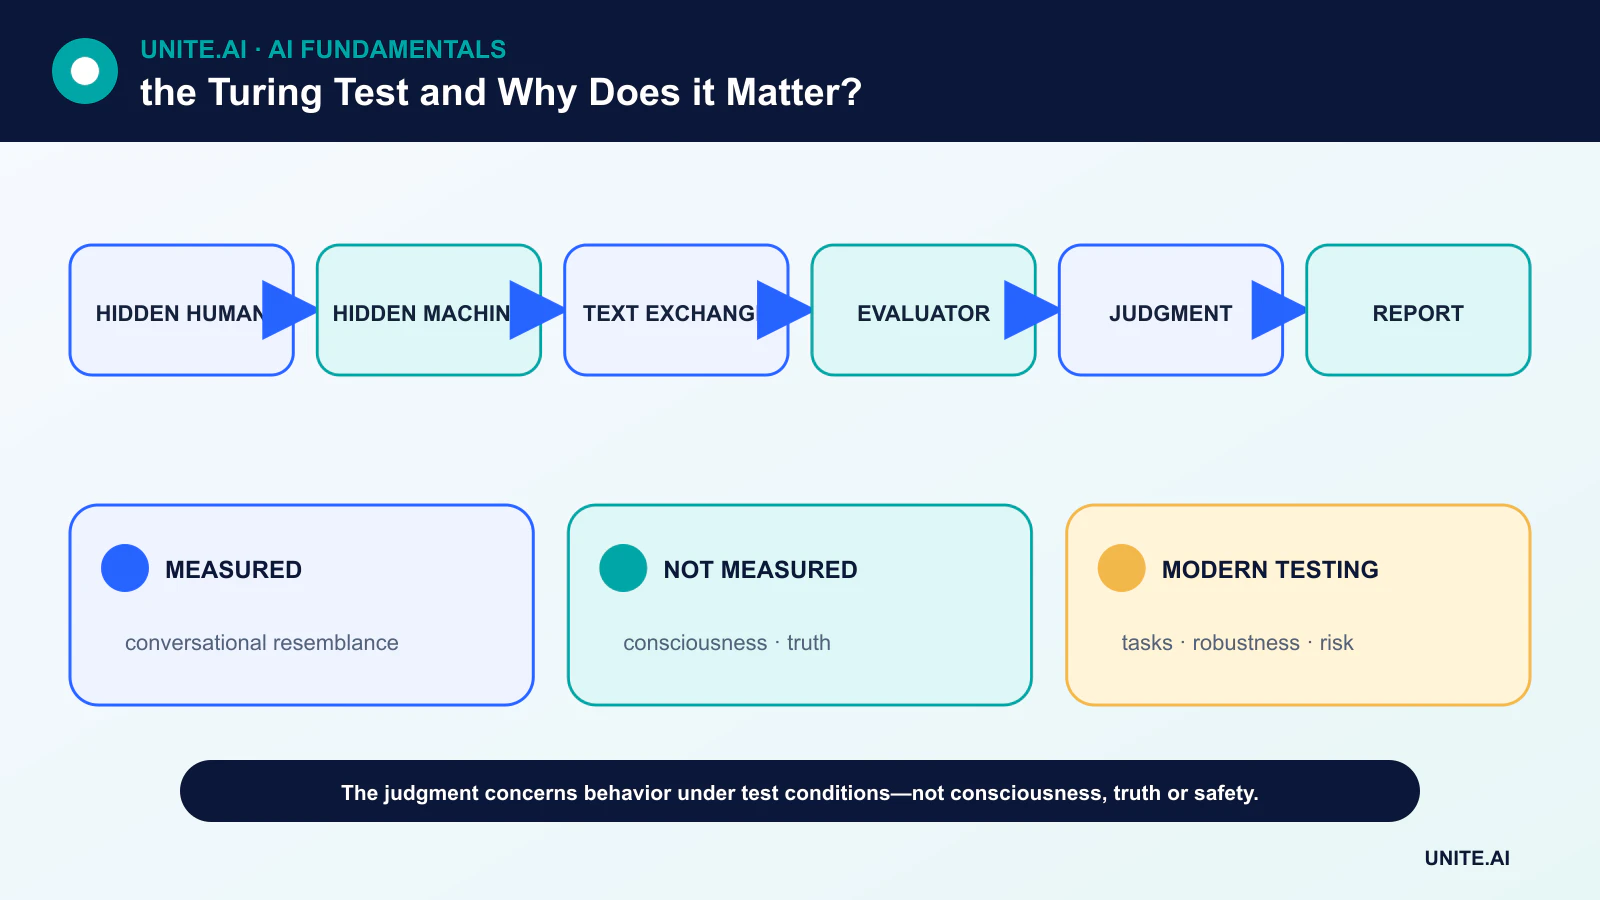
Turings imitation‑spel
I den ursprungliga upplägget kommunicerade en förhörsledare på avstånd så att röst och utseende inte avslöjade identiteten. Turing frågade om en maskin kunde prestera tillräckligt bra i spelet så att en utvärderare inte på ett tillförlitligt sätt kunde skilja den från en människa.
Denna operativa ram undvek behovet av att fastställa en definition av tänkande. Den påstod inte att varje övertygande utbyte bevisar intelligens, och den specificerade inte någon universell godkännandestandard som gäller för någon senare chatbot‑demonstration.
Vad ett resultat faktiskt mäter
En prövning mäter beteendemässig otydlighet under definierade förhållanden. Korta konversationer, oerfarna domare eller prompts som valts av systemets skapare kan göra uppgiften enklare. En noggrann rapport bör redovisa urval av transkript, antal och bakgrund på domarna, jämförelsepersoner, tidsgräns och statistisk metod.
Ett system kan också utnyttja förväntningar: undvikande, humor, typografiska fel och rollspel kan framstå som mänskligt utan att demonstrera pålitligt resonemang. Omvänt kan ett ovanligt formellt mänskligt svar felklassificeras som maskingenererat.
Vad Turingtestet inte fastställer
Testet mäter inte direkt medvetande, subjektiv upplevelse, faktuell korrekthet, kausal förståelse eller moralisk handlingsförmåga. Det avslöjar inte träningsdata, modellarkitektur eller felmodeller utanför konversationen. Det säger också lite om icke‑språklig intelligens såsom fysisk manipulation.
Moderna språkssystem byggs med transformer‑neuronätverk och djupinlärning, men deras flytande utsagor kan fortfarande genereras från inlärd statistisk struktur snarare än en verifierad världsmodell.
Hur modern AI‑utvärdering utvidgar frågan
Samtida utvärdering använder reserverade uppgiftsuppsättningar, kalibrerad osäkerhet, robusthetstester, red‑team‑övningar, faktakontroller och studier av mänskliga preferenser. Ett textklassificerings-mått kan testa ett definierat beteende, medan scenariobaserad utvärdering kan testa om ett system följer policy under press.
Ingen enskild benchmark fångar varje implementering. Testkontamination kan blåsa upp poäng, och statiska benchmarks uppmuntrar överanpassning. Utvärderingen bör upprepas när modeller, data, prompts, verktyg och användarpopulationer förändras.
Varför testet fortfarande är viktigt
Turingtestet förutsåg en central lärdom i AI‑utvärdering: bedöm observerbar förmåga snarare än att förlita sig på påståenden om en intern essens. Det tvingar oss också att fråga vilka mänskliga beteenden som räknas som bevis och hur ett experimentellt upplägg formar en slutsats.
Dess bästa moderna användning är som en historisk och konceptuell referensram. Att klara ett imitation‑spel kan vara intressant, men beslut om implementering kräver bevis kopplade till den faktiska uppgiften, berörda användare och förutsebara skador.
Vad Turingtestet mäter
Alan Turings imitation‑spel frågade om en förhörsledare som kommunicerade via text på ett tillförlitligt sätt kunde skilja en maskin från en person. Det omformulerade en abstrakt debatt om huruvida maskiner tänker till ett observerbart konversations‑experiment. Testet beror på deltagare, varaktighet, protokoll, ämnen och bedömningsregel; det finns ingen enskild universell poäng. Att klara innebär att producera mänskliga svar under den uppsättningen. Det mäter inte direkt faktuell korrekthet, resonemang, medvetande, autonomi, perception, förkroppsligande, pålitlighet eller fördelaktigt beteende i verkligheten.
Mänsklig imitation kan belöna undvikande, persona, misstag, humor eller manipulation. En domare kan förväxla en människa med en maskin eller påverkas av förväntningar, språk och kulturellt sammanhang. Korta konversationer möjliggör knep som misslyckas vid längre interaktion. Omvänt kan ett mycket användbart system för matematik, översättning eller proteindesign misslyckas eftersom det inte låtsas vara mänskligt. Testet mäter därför en social och språklig förmåga som formas av utvärderaren, inte en fullständig rangordning av intelligens.
Moderna språkmodeller och starkare utvärdering
Stora språkmodeller kan upprätthålla flytande dialog genom att förutsäga sekvenser från bred träningsdata och senare finjustering, men flyt är svag evidens för sanning eller förståelse. Memorerade mönster, verktygsåtkomst, dolda prompts, latens och urvalinställningar påverkar resultaten. Kontrollerade utvärderingar bör redovisa modell och protokoll, förhindra informationsläckage, inkludera adversarial‑ och domänfrågor samt poängsätta osäkerhet och källhänvisning. En demonstration som valts från lyckade konversationer kan inte uppskatta tillförlitlighet över hela användningsfördelningen.
Modern utvärdering är multidimensionell: uppgiftsnoggrannhet, kalibrering, robusthet, långsiktig konsistens, säkerhet, bias, integritet, säkerhet, effektivitet och mänskliga resultat. Beteendetester bör kompletteras med process‑evidens, red‑team‑övningar, reproducerbara benchmarks och övervakning i verkligheten. Benchmarks kan mättas upp eller hamna i träningsdata, så privata och uppdaterade testuppsättningar behövs. För system som agerar bör verktygsbehörigheter, återhämtning och konsekvenser utvärderas separat från samtalskvalitet.
Varför testet fortfarande är viktigt
Turingtestet förblir historiskt viktigt eftersom det fokuserar på beteende och svårigheten att definiera intelligens. Det väcker också fortsatta frågor om antropomorfism och bedrägeri. Gränssnitt bör identifiera syntetiska agenter snarare än att behandla felidentifikation som framgång, särskilt i kritiska sammanhang. Använd testet som ett filosofiskt verktyg och en konversationsutvärdering, inte som en certifiering av generell intelligens eller personlighet. Den viktiga implementeringsfrågan är vad systemet på ett tillförlitligt sätt kan göra, med vilka bevis och begränsningar, och vem som är ansvarig när det misslyckas.
Arbetsexempel: en kontrollerad konversationsutvärdering
Utvärderare jämför människor och flera AI‑system i textkonversationer med fast varaktighet, ämnen, språk och fördolda identiteter. Domare registrerar om de tror att varje deltagare är människa och poängsätter även faktualitet, konsistens, hjälpsamhet, osäkerhet och manipulation. Flera domare och konversationer uppskattar variation, och protokollet förhindrar att modellutvecklare väljer gynnsamma transkript. Mänsklig felklassificering ger en nödvändig baslinje för tolkning av resultatet.
Ett system som lurar domare men uppfinner fakta deklareras inte som generellt intelligent, medan en tydligt avklarad specialistmodell kan vara mycket användbar trots att den misslyckas med imitation. Resultaten inkluderar prompt, modell, urvalsmekanism, verktygsåtkomst och domaregenskaper. Experimentet är utformat som ett test av mänsklig liknande konversation. Implementeringsbeslut använder separata bevis för uppgiftskorrekthet, säkerhet, integritet och återhämtning, och gränssnittet identifierar agenten snarare än att göra bedrägeri till produktmål.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underservade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, granska sedan verkliga bevis efter implementering snarare än att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återhämtning, incident‑lärande, raderings‑ och behållningsrutiner samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Har någon AI definitivt klarat Turingtestet?
Det finns ingen enskild officiell testmyndighet eller universellt accepterat protokoll. Offentliga demonstrationer använder olika regler, så påståenden om att ha “klarat” är inte direkt jämförbara.
Bevisar ett misslyckat test att ett system är ointelligent?
Nej. Ett specialiserat system kan vara mycket kapabelt utan att imitera en mänsklig konversationsstil.
Primära referenser












