Grunderna i AI
Vad är Emotion AI (affektiv databehandling), och varför är det viktigt?

 Lägg till Unite.AI bland dina föredragna källor på Google
Emotion AI, ofta kallad affektiv databehandling, tillämpar beräkning på signaler som är förknippade med affekt, såsom språk, vokal prosodi, ansiktsrörelser, hållning, fysiologi eller interaktionsmönster. Ett system kan klassificera en etikett, uppskatta dimensioner såsom valens och arousal, eller anpassa ett gränssnitt.
Resultatet är en inferens – inte en direkt avläsning av ett inre känslotillstånd. Uttryck varierar mellan person, kultur, kontext, hälsa och situation, så samma observerbara signal kan stödja flera förklaringar. Användningar med höga insatser kräver starka bevis, samtycke och juridisk granskning.
Viktiga slutsatser
- Definiera det observerbara målet exakt; emotion, uttryck, sentiment, stress och engagemang är inte utbytbara.
- Validera på den avsedda populationen och miljön, inte bara på ett kuraterat referensvärde.
- Föredra assistans och användarkontroll framför dold övervakning eller konsekvensbaserade automatiska bedömningar.
- Dokumentera osäkerhet, datarättigheter, lagringstid, undergruppsprestanda och en möjlighet att bestrida beslut.
Signalering och modellmål
Textmodeller kan uppskatta uttryckt sentiment; ljudmodeller använder timing, tonhöjd och energi; visionsmodeller analyserar rörelser; fysiologiska system kan använda hjärtfrekvens eller hudkonduktans. Multimodala system kombinerar signaler, men fler sensorer ger inte automatiskt en mer sanningsenlig etikett.
En etikett som ‘frustrerad’ beror på annoteringsinstruktioner och kontext. Sentimentanalys av ord är snävare än att härleda en persons känslomässiga tillstånd, och ingen av dem bör förväxlas med klinisk bedömning.
Varför kontext och osäkerhet dominerar
Människor maskerar, överdriver eller uttrycker känslor på olika sätt. Funktionsnedsättning, språk, belysning, mikrofonkvalitet och sociala normer kan förändra observerade signaler. Laboratoriedatamängder kanske inte representerar ett callcenter, klassrum, fordon eller klinik.
Utvärdera kalibrering, avståelse, fel per grupp, tvärdomänprestanda och alternativ. Förvirringsmatriser hjälper till att visa vilka etiketter som blandas ihop, men en kvalitativ granskning behövs för att förstå varför.
Användbara och riskfyllda tillämpningar
Användarstyrda tillämpningar kan stödja tillgänglighet, reflekterande dagboksskrivning, adaptiv träning eller en säkerhetsvarning. Dessa användningar bör tydligt ange vad som mäts, möjliggöra korrigering och undvika att överskatta säkerheten.
Anställning, utbildning, försäkring, polisarbete och hälsoavgöranden innebär mycket högre insatser. EU:s AI‑lag förbjuder vissa emotion‑igenkänningsanvändningar på arbetsplatser och i utbildning, med vissa undantag, och klassificerar andra användningar enligt risk. Kraven varierar mellan jurisdiktioner och förändras över tid.
Ansvarsfull implementering
Fråga om uppgiften alls kräver en emotionell inferens. Använd dataminimering, tydligt syfte, kort lagringstid, säkerhet, oberoende testning, användarmeddelande och mänsklig granskning. Undvik att bygga sekundära profiler från signaler som samlats in för ett annat ändamål.
Tillämpa förklarlig AI-metoder utan att antyda att en salienskarta bevisar en emotion. Kommunicera osäkerhet i enkelt språk och ge ett meningsfullt sätt att välja bort eller bestrida ett konsekvent resultat.
Hur affekt representeras
Kategoriska modeller förutsäger etiketter som glädje, ilska, rädsla, sorg eller neutral. Dimensionella modeller uppskattar kontinuerliga värden såsom valens, arousal och dominans. Bedömningsmodeller beskriver hur en person värderar en händelse. Dessa representationer är teorier och mätningsval, inte utbytbara sanningsvärden.
Annotationer kan komma från personen som upplever händelsen, en observatör, en kliniker eller ett experimentellt protokoll. Självrapport har introspektiva och återkallningsbegränsningar; observatörsetiketter härleder tillstånd från beteende; fysiologiska mätningar speglar arousal och många icke‑emotionella processer. En datamängd bör ange vems perspektiv etiketten representerar.
Temporär modellering är viktig eftersom affekt utvecklas över tid. Ram‑nivå ansiktsetiketter kan överreagera på tillfälliga rörelser, medan ett genomsnitt på uttalsnivå kan dölja förändring. Fönsterlängd, synkronisering mellan sensorer, saknade kanaler och talarbasis påverkar resultatet.
Modelleringspipeline efter modalitet
Visionspipelines upptäcker och justerar ansikten eller kroppar, extraherar ramar eller landmärken, och klassificerar sedan rumsliga och temporala egenskaper. Ocklusion, kameravinkel, kompression, hudton, glasögon, ansiktsvariation och avsiktlig uttryck kan förändra prestanda. Ansiktsaktionsenheter beskriver rörelse mer direkt än en påstådd emotion och kan vara ett säkrare mål.
Ljudpipelines separerar tal, normaliserar nivå och modellerar spektrala, prosodiska och temporala mönster. En högre tonhöjd kan indikera spänning, stress, en fråga eller talarvanor. Textpipelines fångar uttryckt bedömning och kontext men förlorar ton om de inte kombineras med ljud. Multimodal fusion kan ske på funktions‑, beslut‑ eller kors‑uppmärksamhetsnivå.
Personalisering kan kalibrera till en individs grundnivå, men kräver mer data och skapar en känslig långsiktig profil. System bör föredra lokal eller kortvarig anpassning där det är möjligt och måste undvika att använda en persons data för orelaterade inferenser utan ett giltigt syfte.
Utvärdering, mänskliga faktorer och skyddsåtgärder
Att slumpmässigt dela upp ramar från samma video mellan träning och test skapar läckage. Håll tillbaka personer, sessioner, enheter, platser och tidsperioder enligt det avsedda påståendet. Rapportera makromått så att vanliga klasser inte döljer misslyckanden på sällsynta tillstånd, och inkludera ett avstå‑alternativ för tvetydig input.
Användarstudier bör mäta om anpassning faktiskt hjälper. Ett gränssnitt som ändrar ton baserat på en felaktig inferens kan upplevas som påträngande eller nedlåtande. Låt användare korrigera systemet, välja anpassningsgrad och se den funktionella anledningen till ett svar utan att tilldelas en definitiv emotionell etikett.
Hög‑risk implementering kräver en konsekvensbedömning, juridisk granskning, säkerhet och ett förbud mot sekundära användningar. Spara råvideo eller biometrik endast när det är nödvändigt, begränsa åtkomst och definiera radering. Använd inte emotionspoäng som enda bevis för bedrägeri, prestation, kompetens, avsikt eller mental hälsa.
Utvärdera ett emotion‑AI‑fall innan implementering
Börja med att definiera det påstådda konstruktionen: ansiktsrörelse, vokal prosodi, självrapporterad känsla, observerat beteende eller ett kliniskt tillstånd är inte utbytbara. Identifiera beslutet som kommer att använda resultatet och om en mindre påträngande signal kan tjäna det. Ett system som anpassar spelsvårighet efter explicit frustrationsfeedback har en annan evidens‑ och riskprofil än ett som härleder anställdas ärlighet från en webbkamera.
Validering kräver representativa personer, kulturer, språk, enheter, kontexter och inspelningsförhållanden, med sanningsdata som är lämplig för påståendet. Jämför med enkla baslinjer och rapportera osäkerhet, undergruppsfel, oenighet mellan bedömare och prestanda utanför laboratoriet. Omvandla inte ett sannolikhetspoäng till ett kategoriskt påstående om vad en person känner. Ge användare korrigering, möjlighet att välja bort och en icke‑biometrisk väg där det är möjligt.
Förbjud konsekvensbaserade beslut som enbart baseras på härledd emotion, särskilt inom anställning, utbildning, försäkring, polisarbete, sjukvård och tillgång till tjänster. Minimera lagring av råa ljud‑ och videodata, isolera biometriska identifierare och kontrollera sekundär användning. Dokumentation bör förklara träningskontext, avsedd användning, ogiltiga användningar och kända förväxlingsfaktorer såsom funktionsnedsättning, maskering, stress, kultur eller medicinering. Emotion AI är ett mätningspåstående som kräver bevis, inte ett magiskt fönster till intern upplevelse.
Praktisk implementeringschecklista
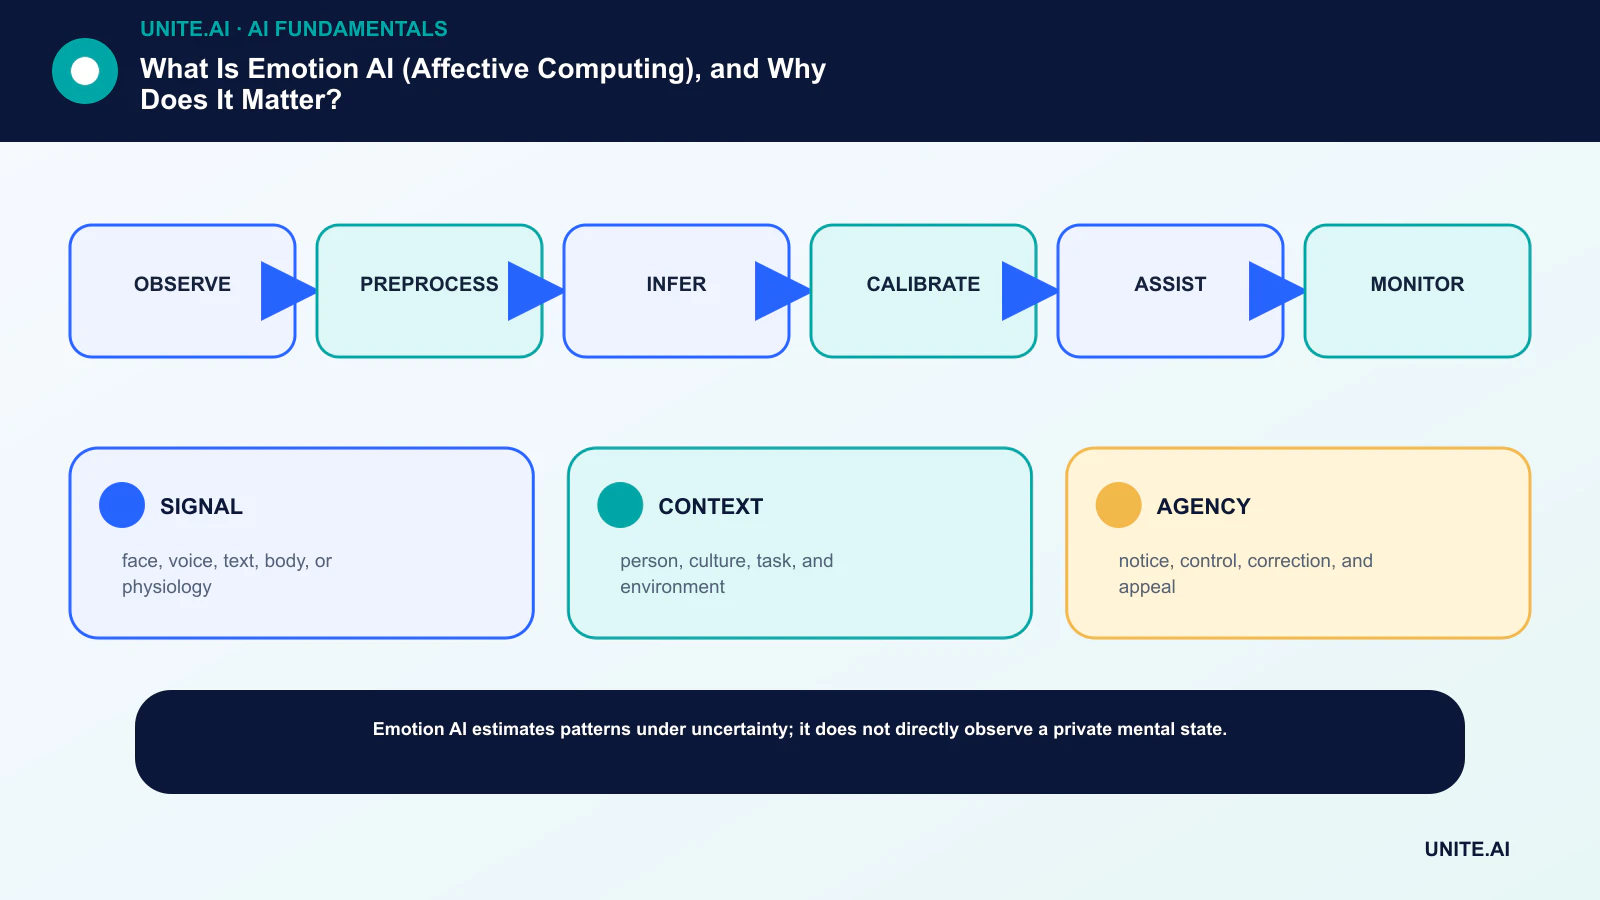
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: observera → förbehandla → inferera → kalibrera → assistera → övervaka. Utse en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt godkännande‑ och stoppkriterier, testa representativa fel och definiera övervakning, återgång och granskning innan omfattningen utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Innan lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, randvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna release, ändra en tröskel, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom ett tekniskt framgångsrikt pilotprojekt inte garanterar pålitlig prestanda i större skala.
- SIGNAL: ansikte, röst, text, kropp eller fysiologi.
- CONTEXT: person, kultur, uppgift och miljö.
- AGENCY: information, kontroll, korrigering och överklagande.
Vanliga frågor
Kan AI exakt läsa av känslor från ett ansikte?
Den kan förutsäga dataset‑etiketter från ansiktsrörelser, men dessa rörelser bestämmer inte unikt en intern emotion. Noggrannheten beror starkt på kontext, population, etiketter och mätningsdesign.
Är emotion AI lagligt?
Det beror på användning, data, personer och jurisdiktion. Vissa kontexter är förbjudna eller hög‑risk. Organisationer behöver aktuell juridisk rådgivning, inte en generisk teknisk checklista.
Primära referenser