Grunderna i AI
Vad är förklarbar AI?

 Lägg till Unite.AI bland dina föredragna källor på Google
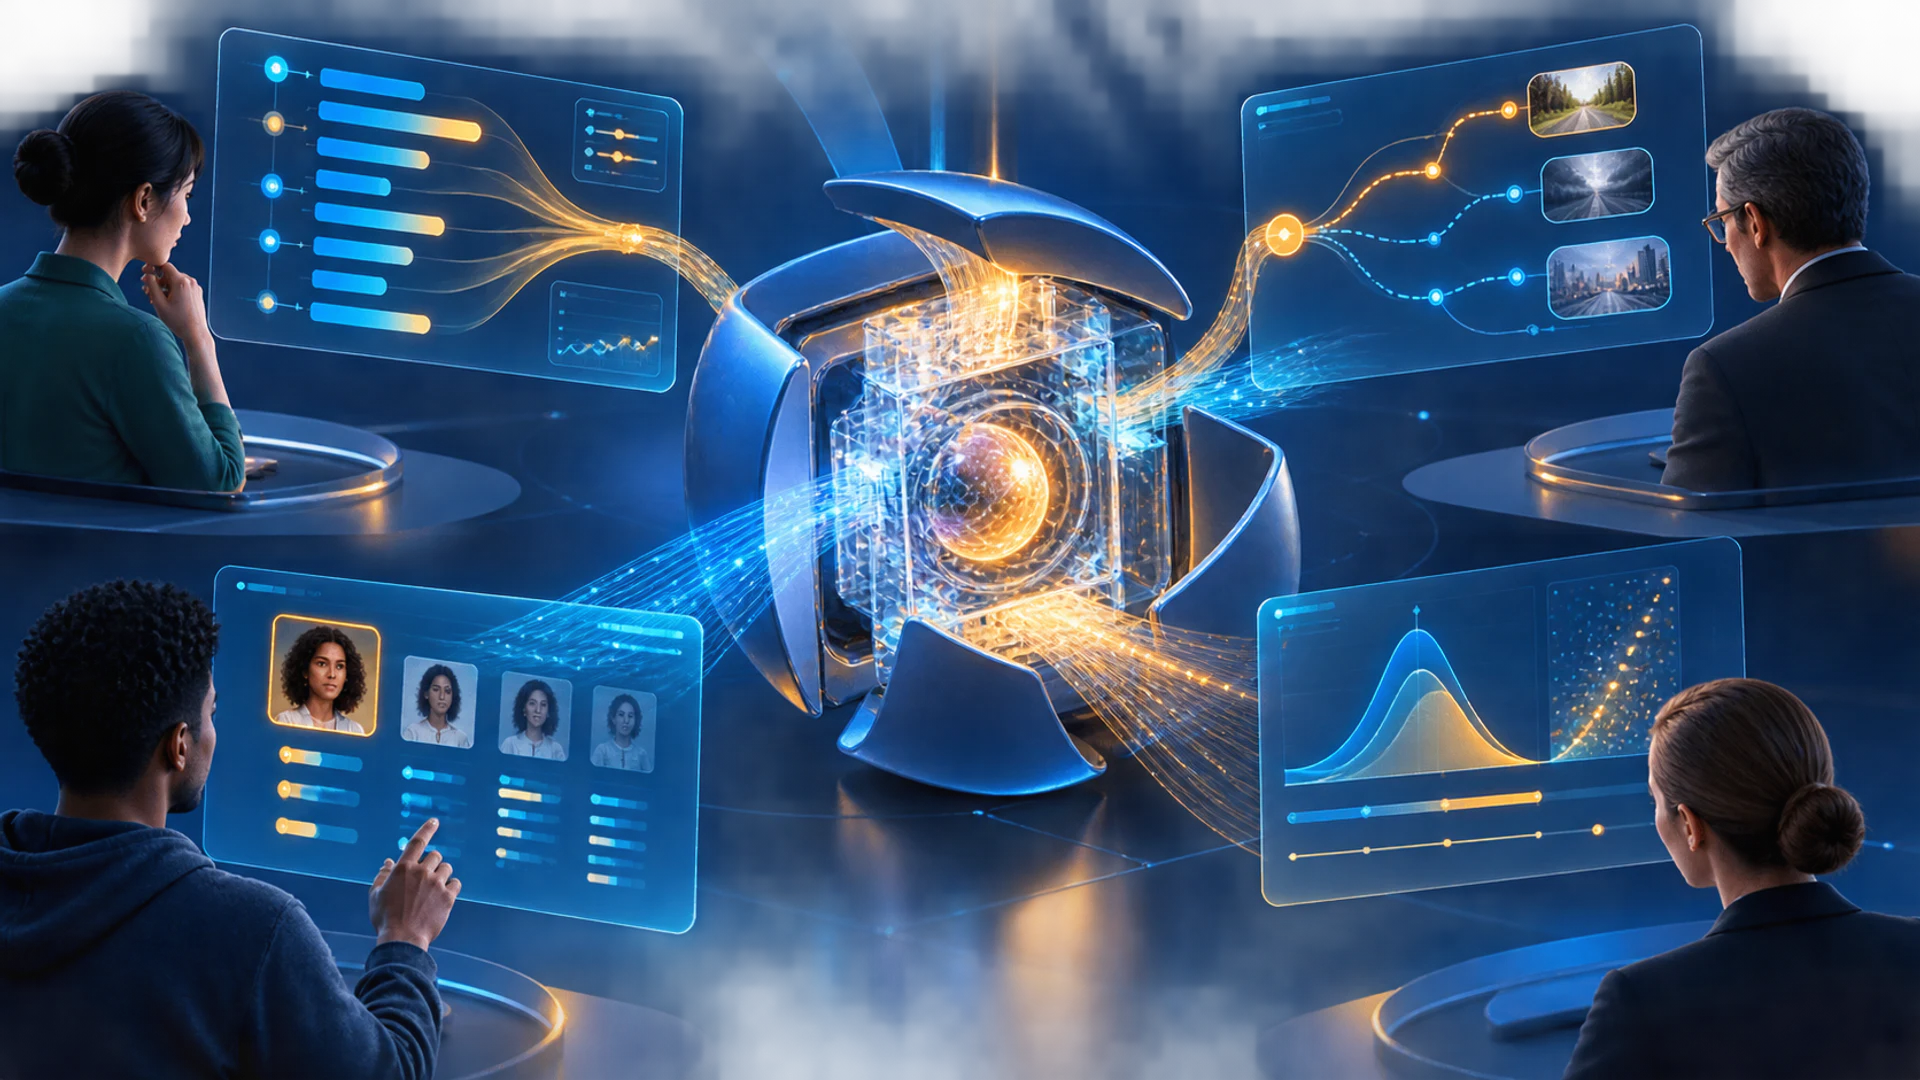
Förklarbar AI (XAI) omfattar metoder och praxis som hjälper människor att förstå ett AI‑systems beteende eller resultat. En förklaring kan beskriva påverkande indata, visa ett liknande exempel, presentera en kontrafaktisk förändring, sammanfatta en global regel eller meddela när systemet inte vet.
Ingen förklaring är universellt bäst. En utvecklare som felsöker en modell, en revisor som testar policyefterlevnad och en person som påverkas av ett beslut behöver olika bevis. Förklaringar måste därför utvärderas för noggrannhet, innebörd och avsett användningsområde – inte bara visuell attraktivitet.
Viktiga slutsatser
- Transparens beskriver tillgänglig information; tolkbarhet handlar om innebörd; förklaring kommunicerar bevis eller skäl.
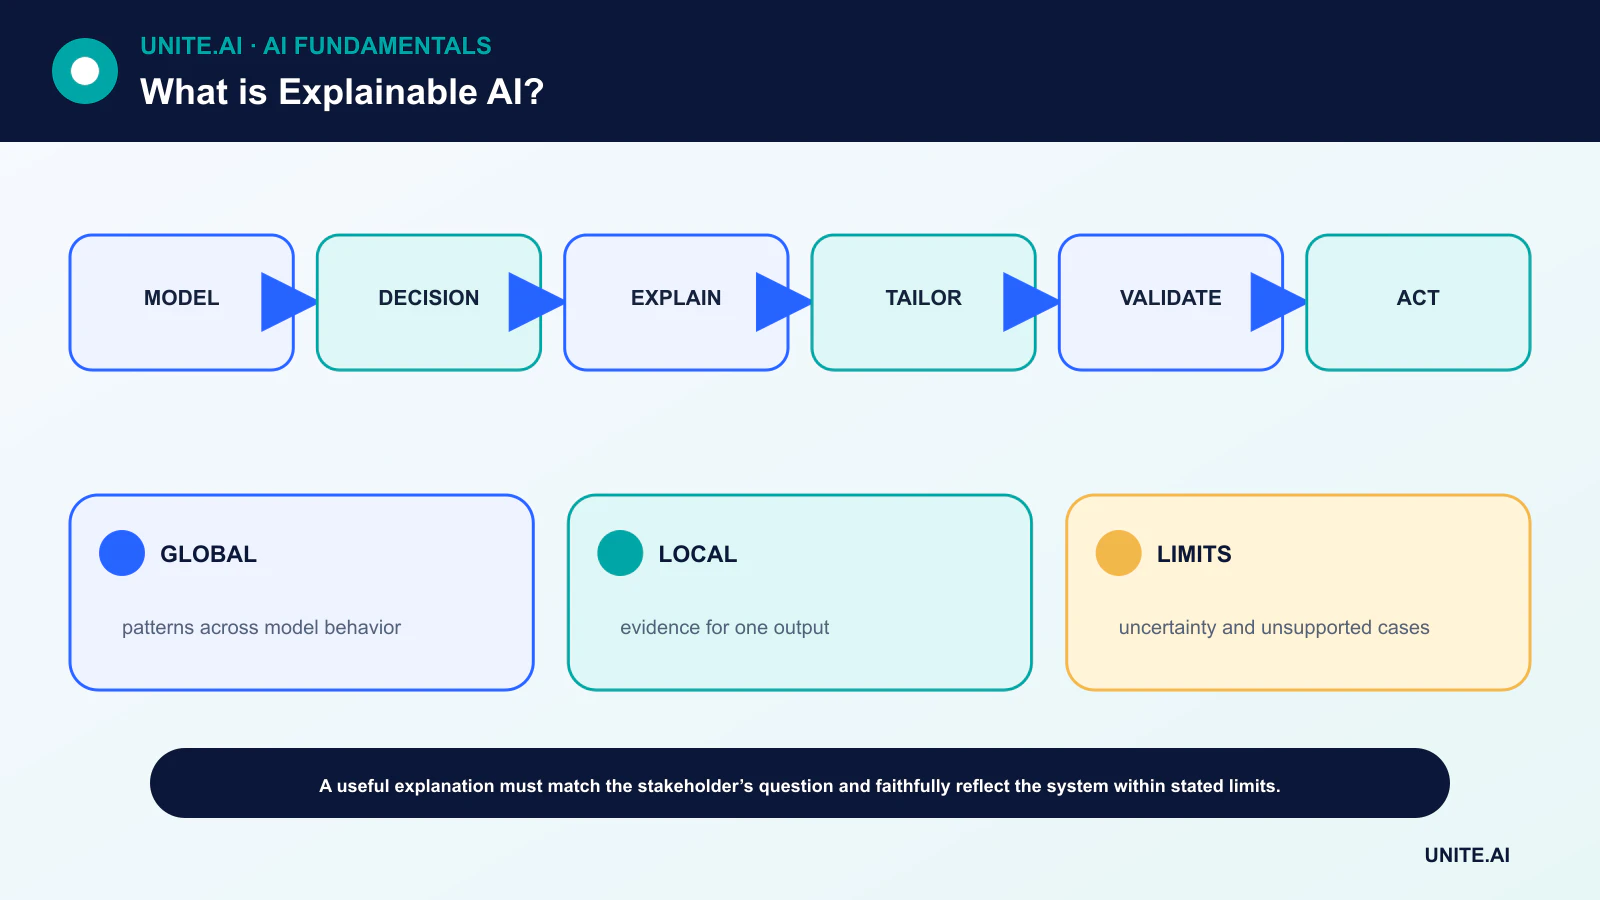
- Globala metoder sammanfattar en modell, medan lokala metoder behandlar en enskild prediktion eller ett litet område.
- Post‑hoc‑förklaringar kan vara användbara men kan vara instabila eller otrogna mot den underliggande modellen.
- En förklaring bevisar inte rättvisa, kausalitet, robusthet eller korrekthet.
Fyra principer för användbara förklaringar
NIST föreslår att ett system ska ge en förklaring, göra den meningsfull för den avsedda användaren, säkerställa att den exakt återger systemets process och kommunicera sina kunskapsgränser. Dessa principer skiljer mellan att en förklaring finns och dess kvalitet.
Betydelse är publikspecifik. En kortfattad orsakskod kan hjälpa en sökande, medan en modellutvecklare kan behöva fördelningar, egenskapsbeteende och felkluster. Båda bör kopplas till samma dokumenterade system och beslutskontext.
Intrinsiska och post‑hoc‑metoder
En gles linjär modell eller en begränsad beslutsträd kan vara direkt tolkbar inom sitt giltiga område. En komplex modell kan istället använda post‑hoc‑egenskapsattribution, en lokal surrogat, exempel, salienskartor eller kontrafaktiska analyser.
Intrinsisk enkelhet är inte automatiskt sanningsenlig när egenskaper är dåligt definierade eller pipeline är dold. Post‑hoc‑komplexitet är inte automatiskt missvisande. Metoden måste testas mot den fråga den är avsedd att besvara.
Egenskapsattribution och korrelerade indata
Attributionsmetoder fördelar delar av ett resultat till indataegenskaper under explicita antaganden. LIME anpassar en enkel lokal surrogat runt en prediktion; SHAP‑relaterade metoder kopplar additiva attributioner till Shapley‑värdekoncept.
Korrelerade egenskaper kan dela eller utbyta attribution, och en hög attribution är inte en kausal effekt. Att ändra en egenskap isolerat kan skapa en omöjlig person, bild eller transaktion. Förklaringar bör ange sina grundvärden, urval och beroendeantaganden.
Kontrafaktiska analyser, exempel och globalt beteende
En kontrafaktisk analys frågar vilken genomförbar förändring som skulle ändra ett resultat. Begränsningar är väsentliga: en handlingsbar förklaring får inte föreslå oföränderliga, illegala eller orealistiska förändringar. Exempelfokuserade metoder visar prototyper eller inflytelserika träningsfall men kan avslöja privata data.
Global analys granskar prestanda, partiell beroende, monotonicitet, interaktioner och subgruppsbeteende. För ensemblemetoder som gradient boosting kombineras sammanfattningar med lokala bevis och direkta tester av förväntade begränsningar.
Validera förklaringen och systemet
Testa sanningsenlighet, stabilitet under små störningar, konsistens över likvärdiga indata, användarförståelse och om förklaringen stödjer ett lämpligt beslut. Adversariella tester bör kontrollera om en övertygande förklaring kan följa ett felaktigt eller manipulerat resultat.
XAI hör till en bredare utvärdering: kvalitet mätt på data som hållits utanför träningen, kalibrering, rättvisa, integritet, säkerhet, övervakning och överklagandemekanismer. En förklaring kan stödja ansvarsskyldighet, men den kan inte ersätta en ansvarstagande styrning.
Målsättningar för förklaringar och metodfamiljer
Förklarbar AI bör börja med en fråga och en publik: varför ett beslut inträffade, hur modellen i allmänhet beter sig, vilket bevis som påverkade den, vad som skulle förändra resultatet, eller om en policy följdes. Lokala förklaringar behandlar en prediktion; globala förklaringar sammanfattar bredare beteende. Inneboende tolkbara modeller visar koefficienter, regler eller strukturer, medan post‑hoc‑metoder approximerar komplexa modeller. En förklaring av modellbeteende är inte automatiskt en kausal förklaring av världen eller ett rättfärdigande för att ett beslut är rättvist.
Egenskapsattributionsmetoder inkluderar gradienter, integrerade gradienter, SHAP‑liknande värden, permutation och lokala surrogatmodeller. Exempelfokuserade förklaringar hämtar inflytelserika eller liknande fall; kontrafaktiska analyser föreslår förändringar kopplade till ett annat resultat; konceptmetoder relaterar interna representationer till mänskliga kategorier. Varje metod har antaganden om grundvärden, oberoende mellan egenskaper, lokal linearitet eller modellåtkomst. Korrelerade variabler, interaktioner och förbehandling kan göra attributioner instabila eller missvisande. Jämför metoder och stör indata för att testa om en förklaring förutsäger beteende.
Utvärdering och mänskliga faktorer
Utvärdera sanningsenlighet – huruvida förklaringen stämmer med modellen – separat från plausibilitet för en person. Testa stabilitet, känslighet, fullständighet, sparsitet och nytta för en definierad uppgift såsom felsökning eller överklagande. Mänskliga studier kräver representativa deltagare och bör mäta beslutskvalitet, felupptäckt, förtroende och tid, inte om användare anser att ett diagram är tydligt. En övertygande förklaring kan öka förtroendet för en felaktig modell, så gränssnitt måste visa osäkerhet, alternativ och begränsningar.
Kontrafaktiska analyser bör vara genomförbara, handlingsbara och inte föreslå förändring av skyddade eller oföränderliga egenskaper. Förklaringar kan läcka modell‑ eller personlig information och hjälpa angripare att reverse‑engineera beslut. Tillämpa åtkomstkontroller och minimera den information som lämnas ut. För reglerade eller högpåverkande tillämpningar, bevara dataproveniens, modellversion, tröskel och faktisk beslutslogik; en generisk grafik över egenskapers betydelse kan inte ersätta ett juridiskt meningsfullt skäl eller mänsklig granskning.
Använda förklaringar ansvarsfullt
Välj den enklaste modellen som uppfyller prestanda‑ och driftsbehov, men offra inte giltigheten för ytlig tolkbarhet. Kombinera förklaringar med subgruppstester, robusthetskontroller, kausal analys där relevant, och resultatövervakning. Dokumentera avsedd publik och ogiltiga slutsatser. Om en förklaring förändras efter en ofarlig störning, undersök innan implementering. Förklarbarhet är bevis om ett system under en metod; den är värdefull för felsökning, tillsyn och kommunikation, men den garanterar inte sanning, rättvisa, säkerhet eller förståelse.
Praktiskt exempel: förklara en kreditriskmodell
En långivare definierar först publiken och det nödvändiga skälet: sökande behöver korrekta beslutsfaktorer och en korrigeringsväg, medan utvecklare behöver diagnostik. En kalibrerad tolkbar baslinje jämförs med en boostad modell. Lokala attributioner, kontrafaktiska analyser och global felanalys testas för sanningsenlighet, stabilitet, korrelerade egenskapsbeteenden och nytta. Förklaringar får inte föreslå förändring av ålder, funktionshinder eller annan oföränderlig egenskap, och de presenteras inte som kausala effekter.
Produktionsbeslutsposten bevarar källdata, egenskapstransformering, modell, tröskel, policy och mänsklig handling. Sökande kan bestrida felaktiga data och få en meningsfull granskning. Övervakning kontrollerar resultat‑ och förklaringsstabilitet över grupper och modelluppdateringar. Om en plausibel förklaring förändras vid en ofarlig störning av en egenskap eller utelämnar en avgörande policyregel, stoppas implementeringen. Förklarbarhet kompletterar validering och procedurala rättigheter; den ursäktar inte ett ogiltigt mål, diskriminerande resultat eller avsaknad av ansvarig mänsklig myndighet.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Dokumentera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Före lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker reserv och verifiera övervakning med medvetet injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla onödig känslig data. Definiera larmtrösklar och en ansvarig för svar, och granska sedan verkliga bevis efter implementering i stället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system kräver också dokumenterad återhämtning, incident‑lärande, raderings‑ och bevarandeprocesser samt en tydlig punkt då det ska inaktiveras eller ersättas.
Vanliga frågor
Är uppmärksamhetskartor förklaringar?
De kan vara diagnostiska signaler, men uppmärksamhetsvikter ensamma garanterar inte att de sanningsenligt återger orsakerna till en modells resultat.
Kräver förklarbar AI en enkel modell?
Inte alltid. Komplexa modeller kan analyseras med post‑hoc‑metoder, men dessa förklaringar kräver oberoende validering och tydligt angivna begränsningar.
Primära referenser