Grunderna i AI
Hur man bygger en chatbot: Arkitektur, data, säkerhet och utvärdering

 Lägg till Unite.AI bland dina föredragna källor på Google
En chatbot är en applikation som tar emot ett meddelande, avgör vad användaren behöver och returnerar ett svar via text eller tal. Moderna system kan kombinera regler, sökning, klassificerare, transformers, verktyg och stora språkmodeller snarare än att förlita sig på en enda modell.
Att bygga en användbar chatbot är därför ett produkt- och systemproblem. Dialoglagret måste kopplas till pålitlig kunskap och affärshandlingar, medan identitet, behörigheter, loggning, utvärdering, fallback och mänsklig eskalering begränsar vad boten får göra.
Viktiga slutsatser
- Börja med en avgränsad användaruppgift och ett mätbart framgångskriterium.
- Separera språkgenerering från sökning, verktyg, behörigheter och affärsregler.
- Testa kompletta konversationer, inklusive tvetydighet, avbrott, avslag och återhämtning.
- Behandla prompts och modellutdata som opålitlig data; övervaka produktionen och bevara eskaleringsvägar.
Definiera uppgiften innan du väljer en modell
Skriv ner vem användaren är, vad de försöker åstadkomma, vilka data systemet kan komma åt och vilka åtgärder som kräver bekräftelse. En FAQ‑bot, en orderstatus‑assistent och en kontohanterings‑agent har mycket olika riskprofiler.
Skapa en icke‑AI‑baslinje och ett acceptansset av representativa konversationer. Mät uppgiftsfullbordan, svarsstöd, svarstid, avhopp, eskalering och kostnaden för skadliga fel. En flytande demo är inte bevis på att arbetsflödet fungerar pålitligt.
Använd en lagerbaserad arkitektur
En typisk pipeline innehåller en kanaladapter, sessionsstatus, inmatningsvalidering, avsikts‑ eller routningslogik, sökning, en svar‑ eller policy‑modell, verktygsadaptrar och observabilitet. Sökning kan förankra svar i godkända dokument; verktyg utför kontrollerade åtgärder via explicita scheman.
Behåll deterministiska kontroller utanför språkmodellen. Autentisering, auktorisation, lagergränser, återbetalningar och irreversibla åtgärder bör verkställas av applikationskod. Prompt‑engineering kan forma beteende, men det är inte ett åtkomstkontrollsystem.
Designa dialog, kunskap och återhämtning tillsammans
Bra konversationer hanterar ofullständiga förfrågningar, korrigeringar, flera avsikter och referenser till tidigare turer. Spara endast den kontext som behövs för uppgiften, gör lagring synlig och skilj på ett användaruttalande och ett pålitligt faktum som returneras av ett godkänt system.
När förtroende eller bevis är otillräckliga bör boten ställa en fokuserad fråga, erbjuda ett säkert alternativ eller överföra till en person med en kort sammanfattning. Återhämtning är en del av kärnupplevelsen – inte ett kantfall som läggs till efter lansering.
Utvärdera och driftsätt hela systemet
Testa sökkvalitet, verktygsval, argumentnoggrannhet, policyefterlevnad, motståndskraft mot prompt‑injektion, sekretessläckage och slut‑till‑slut‑resultat. Genomför red‑team‑adversariella indata och verifiera att ett skadligt dokument inte tyst kan åsidosätta systeminstruktioner.
Versionera prompts, index, modeller, policies och verktyg. Granska provtagna konversationer med sekretesskontroller, observera drift och felkluster, och upprätthåll återställning. Denna operativa disciplin kopplar chatbot‑utveckling till AIOps och incidentrespons.
Kärnkomponenter i chatboten i mer detalj
Kanalagret normaliserar inmatning från webbchat, mobilappar, meddelandeplattformar eller tal. Ett sessionslager kopplar meddelanden till en autentiserad eller anonym konversation, verkställer utgångsdatum och lagrar endast det tillstånd som behövs för uppgiften. Inmatningskontroller begränsar storlek och filtyper, upptäcker osäkra data och tar bort markup som nedströmsystem inte bör köra.
En router avgör sedan om förfrågan tillhör ett deterministiskt flöde, sökning, generering eller en mänsklig kö. Klassiska avsiktsklassificerare är fortfarande användbara när etikettmängden är stabil; språkmodeller är mer flexibla men svårare att kalibrera. Hybridrouterar kan reservera reglerade eller högvolymsuppgifter för testade arbetsflöden och använda en generell modell för öppna förklaringar.
Svarslagret bör bära bevis och tillstånd separat. En genererad mening kan citera ett hämtat avsnitt, men applikationen måste bevara vilken källa och version som stödde det. Konversationsminnet bör skilja användarpreferenser från verifierad kontodata och får aldrig låta ett tidigare användarmeddelande ge nya behörigheter.
Sökning, verktyg och transaktioner
Sökkvalitet börjar innan vektorsökning. Dokument behöver ägarskap, åtkomstetiketter, kanoniska versioner, användbara segment och borttagningsdatum. Omformulering av frågor, nyckelordssökning, inbäddningar, filter och omrankning kan kombineras. Utvärderingen bör mäta om nödvändigt bevis hämtades, om irrelevanta avsnitt uteslöts och om svaret faktiskt följer beviset.
Verktyg omvandlar ett modelförslag till en typad begäran till applikationskod. Varje verktyg kräver ett avgränsat syfte, ett explicit schema, server‑sidovalidering, minst‑privilegier‑uppgifter, tidsgränser, idempotens där det är möjligt och ett tydligt resultat. Modellen bör inte konstruera råa databasfrågor eller godtyckliga URL:er när en begränsad affärsoperation kan exponeras istället.
Transaktioner kräver bekräftelse vid åtagandet. Visa användaren de relevanta fälten – mottagare, belopp, adress, datum eller åtkomständring – och behandla inte ett gammalt ‘ja’ som godkännande för en ny åtgärd. För flerstegsarbete, håll en tillståndsmaskin utanför modellen så att en omstart eller omordnad meddelande inte kan hoppa över ett obligatoriskt steg.
En praktisk bygg‑ och utvärderingsplan
Börja med tjugo till femtio representativa uppgifter och inkludera misslyckade, tvetydiga och utanför räckhåll‑förfrågningar. Markera den förväntade åtgärden, bevis, eskalering och förbjudet beteende. Implementera det enklaste fungerande flödet, och lägg sedan till sökning eller generering endast där det förbättrar ett mätt resultat. Detta skapar en återanvändbar regressionssvit innan gränssnittet blir komplext.
Utvärdera komponenter och konversationer separat. Sökmått, verktygsanrop‑noggrannhet, policykontroller och svarsstöd diagnostiserar specifika fel; uppgiftsfullbordan och användarinsats avslöjar systemnivåkvalitet. Använd flerstegstester som korrigerar tidigare detaljer, avbryter ett flöde, byter ämne, håller tillbaka nödvändig information och utlöser beroendefel.
Produktionsutrullning bör ske i steg per användargrupp, uppgift och behörighet. Övervaka icke‑stödda påståenden, upprepade förtydliganden, verktygsavslag, eskalering, svarstid och avhopp. Granska sekretess‑säkra exempel, upprätthåll en nödstopp‑väg för varje verktyg och använd incidentresultat för att uppdatera prompts, data, kod och testsetet tillsammans.
Arbetsexempel: en support‑chatbot från prototyp till produktion
Anta att en återförsäljare vill ha en chatbot som svarar på beställnings‑ och returfrågor. Definiera först stödjade avsikter, eskaleringsvillkor, godkänd kunskap, autentiseringsregler och förbjudna åtgärder. Bygg ett testset från avidentifierade historiska frågor, inklusive vaga förfrågningar, stavfel, flerspråkig inmatning, arga användare, prompt‑injektion och frågor utan svar. En sökbaslinje bör returnera bevis innan någon generativt svar får påstå policy‑ eller orderstatus.
Körningen kan klassificera avsikt, hämta policyavsnitt, begära identitetsverifiering endast när kontodata behövs, anropa ett snävt avgränsat order‑API, komponera ett svar och bifoga källhänvisningar. Varje verktygsanrop kräver ett explicit schema, auktorisationskontroll, tidsgräns, omförsökningspolicy och en idempotensnyckel. Modellen bör aldrig konstruera råa databasfrågor eller bestämma egna behörigheter. Åtgärder med hög påverkan som avbokning eller återbetalning kräver bekräftelse och, över definierade gränser, mänskligt godkännande.
Utvärdera avsiktens noggrannhet, svarskorrekthet, bevisstöd, avslagskvalitet, lyckad hantering, eskaleringsprecision, svarstid och kostnad per löst samtal. Granska resultat efter avsikt och användargrupp snarare än ett genomsnitt. I produktion, logga samtyckes‑medvetna spår, verktygsresultat, hämtade dokumentversioner och användarkorrigeringar. Rulla ut gradvis, jämför med den befintliga kanalen och inaktivera funktioner när fel, missbruk eller beroendetrösklar överskrids.
Praktisk implementeringschecklista
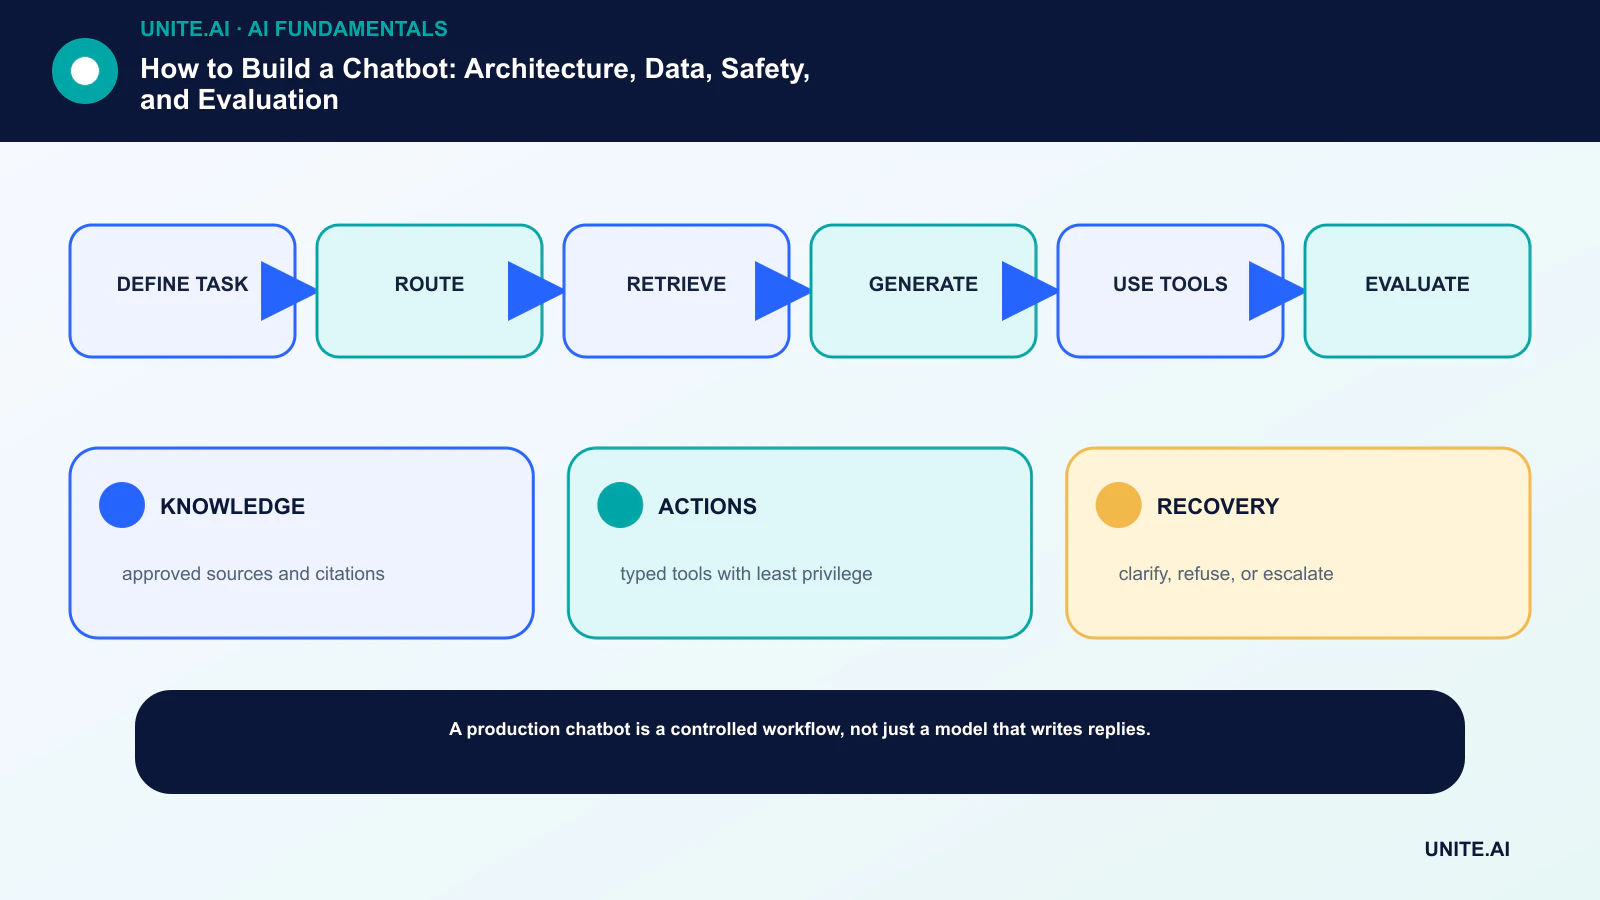
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: definiera uppgift → routa → hämta → generera → använda verktyg → utvärdera. Ange en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt acceptans‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan räckvidden utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Före lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, randvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna releasen, ändra en tröskel, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom en tekniskt framgångsrik pilot inte garanterar pålitlig prestanda i större skala.
- KUNSKAP: godkända källor och hänvisningar.
- ÅTGÄRDER: typade verktyg med minsta privilegium.
- ÅTERHÄMTNING: förtydliga, avvisa eller eskalera.
Vanliga frågor
Behöver en chatbot en stor språkmodell?
Nej. Regler, sökning, formulär och små klassificerare kan vara säkrare och billigare för avgränsade uppgifter. En LLM är användbar när flexibel språkförståelse eller generering ger ett mätbart värde.
Vad bör testas innan lansering?
Representativa uppgifter, icke‑stödda förfrågningar, tvetydigt språk, verktygsfel, sekretessgränser, adversariella prompts, mänsklig överlämning, svarstid och noggrannheten i varje följdåtgärd.
Primära referenser