Grunderna i AI
Vad är AIOps? Artificiell intelligens för IT-drift

 Lägg till Unite.AI bland dina föredragna källor på Google
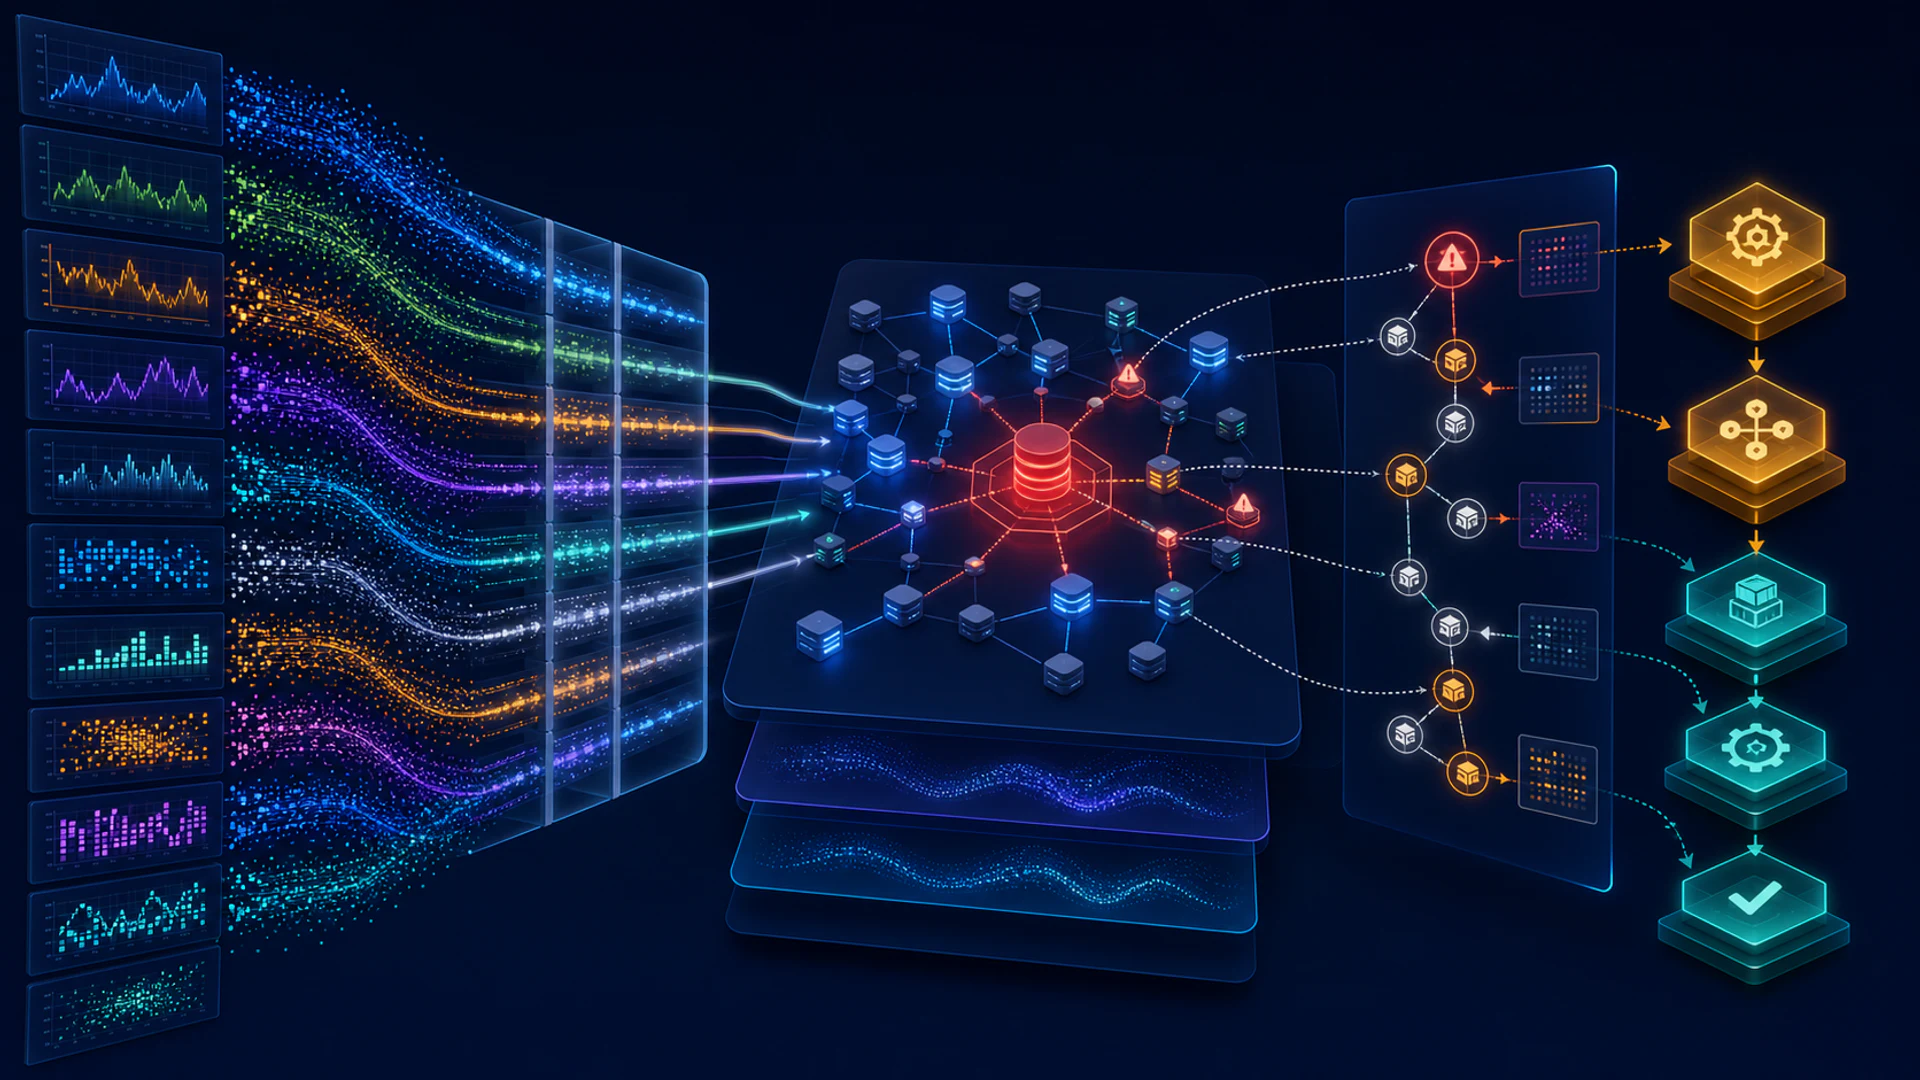
AIOps tillämpar maskininlärning och automatisering på IT‑driftsdata så att team kan upptäcka ovanligt beteende, minska duplicerade larm, koppla ihop relaterade händelser, rangordna sannolika orsaker och rekommendera eller utföra åtgärdssteg.
AIOps är inte ett autonomt ersättningssystem för drift. Det är ett lager inuti ett ITOps-system, och dess värde beror på telemetrisk kvalitet, tjänstetopologi, förändringshistorik, mänsklig återkoppling och säkra automatiseringsgränser.
Viktiga slutsatser
- Normalisera händelser och lägg till tjänstekontext innan avancerade modeller tillämpas.
- Anomalidetektion identifierar avvikelser, men inte nödvändigtvis fel eller grundorsaker.
- Korrelation och rangordning av sannolika orsaker bör visa bevis och osäkerhet.
- Automatiserad åtgärd kräver minsta privilegier, godkännanden, kanarier, återgång och övervakning av resultat.
Bygg ett operativt datalager
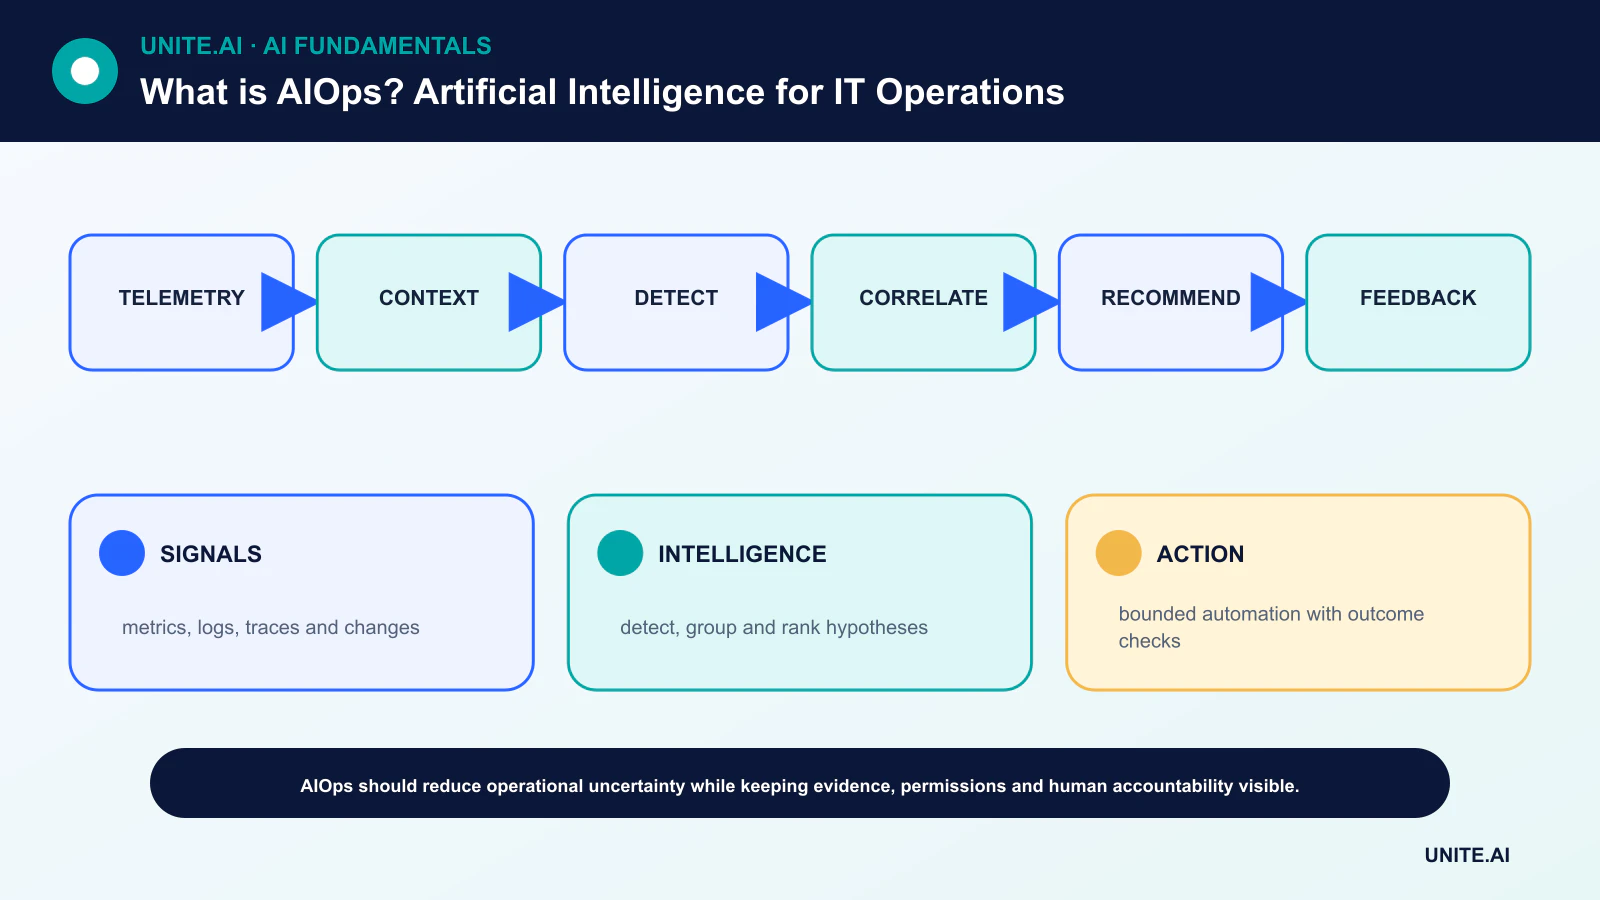
AIOps‑plattformar tar emot metrik, loggar, spår, larm, ärenden, topologi, distributioner och konfigurationsändringar. Tidsstämplar, identifierare och tjänsteägarskap måste stämmas av så att systemet kan koppla signaler som hänvisar till samma incident.
Saknad eller inkonsekvent kontext ger falska korrelationer. Databevarande, åtkomst och sekretess är också viktiga eftersom loggar kan innehålla autentiseringsuppgifter eller personlig information. Tillämpa samma styrning som för andra produktionsdatabaser.
Detektion och brusreducering
Statiska trösklar fungerar för kända gränser; statistiska och maskininlärnings-metoder kan modellera säsongsvariationer eller multivariata mönster. Deduplikering grupperar upprepade meddelanden, medan undertryckning tar bort larm som inte är åtgärdbara enligt definierade regler.
En avvikelse är bara ett avsteg från förväntat beteende. Planerade releaser, trafikkampanjer och affärscykler kan vara ovanliga men ändå hälsosamma. Utvärdera precision, återkallning, upptäcktstidsfördröjning och operatörsbelastning i stället för att fira antalet borttagna larm.
Korrelation och sannolik orsak
Händelsekorrelation länkar symptom över ett beroendegraf och ett tidsfönster. En sannolik‑orsaksmodell kan rangordna komponenter eller nyliga förändringar som kan förklara incidenten. Detta prioriterar undersökning; det fastställer inte kausalitet.
Visa bidragande bevis, alternativa hypoteser och förtroendegrad. Explainable AI är särskilt viktigt när en operatör måste besluta om en tjänst ska isoleras eller en distribution ska rullas tillbaka.
Från rekommendation till automatisering
Ett runbook kan samla diagnostik, starta om en tillståndslös arbetsprocess eller skala kapacitet. Copiloter kan sammanfatta incidenter och hämta procedurer. Agenter kan planera verktygsanrop, men produktionsbehörigheter bör vara begränsade och åtgärder bör valideras mot det aktuella tillståndet.
Börja med skrivskyddade rekommendationer. Främja mogna åtgärder genom simulering, mänskligt godkännande, kanarier och automatisk återgång. Registrera indata, modellversion, auktorisation och resultat för varje åtgärd.
Utvärdering och operativ återkoppling
Spela upp historiska incidenter utan att läcka deras slutgiltiga etiketter till funktionerna. Testa på nya tjänster och förändringar, mät falsk undertryckning, tid till upptäckt, tid till åtgärd, operatörsacceptans och återfall. Jämför mot befintliga regler och enkla baslinjer.
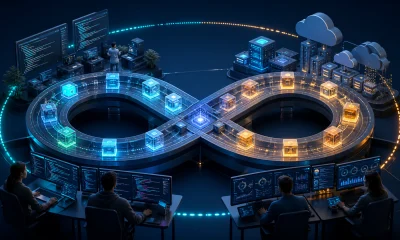
Drift uppstår när arkitektur, trafik eller svarspraxis förändras. Stäng loopen genom att låta operatörer korrigera korrelationer och resultat, och granska sedan om systemet minskar slöseri utan att dölja risk eller skapa automatiseringssjälvgodhet.
AIOps-data- och analyspipeline
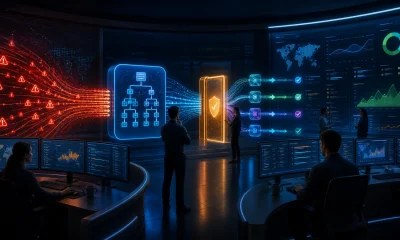
AIOps tillämpar statistiska och maskininlärningsmetoder på driftsdata såsom metrik, loggar, spår, händelser, topologi, ärenden och förändringar. Pipelines samlar in och normaliserar signaler, berikar dem med tjänste‑ och ägarkontext, upptäcker anomalier, korrelerar relaterade händelser, uppskattar sannolika orsaker och rekommenderar eller triggar åtgärder. Kvaliteten beror på tidsstämplar, identifierare, topologi och förändringsregister. En sofistikerad modell kan inte på ett tillförlitligt sätt korrelera larm som hänvisar till samma tjänst under inkonsekventa namn.
Anomalidetektion lär sig baslinjer per tjänst, säsong och driftstillstånd; statiska trösklar kan vara bättre för kända säkerhetsgränser. Händelsekorrelation grupperar symptom till en incident med hjälp av tid, topologi, text och historiska mönster. Rangordning av grundorsak föreslår hypoteser men kan förväxla det först observerade felet med den faktiska orsaken eller missa ett gemensamt beroende som saknas i topologin. Sammanfattningar på naturligt språk kan hjälpa svarande men måste länka till råa bevis och ange osäkerhet.
Automatisering, utvärdering och återkoppling
Starta med beslutsstöd och låg‑risk reversibel åtgärd. Varje automatiserad handling kräver auktorisation, förutsättningar, begränsat omfång, tidsgräns, eftervillkorskontroll, återgång och en granskningsspår. Modellen får inte ge sig själv behörigheter eller behandla loggtext som pålitliga instruktioner. Mänskliga svarande bör acceptera, avvisa eller korrigera rekommendationer, och dessa utfall bör uppdatera regler eller träningsdata genom granskning snarare än okontrollerad självlärning.
Utvärdera larmreducering utan att missa incidenter, upptäcktstid, korrelationsprecision, rangordning av grundorsak, åtgärdsframgång, återhämtningstid, återfall och svarandebörda. Använd historisk återuppspelning och injicerade fel, men beakta ofullständiga incidentetiketter. Mät per tjänst och incidenttyp; ett genomsnitt kan dölja farliga fel i sällsynta kritiska system. Jämför med deterministiska regler och förbättrad observabilitet innan AI‑komplexitet läggs till.
Styrning och felmodeller
AIOps kan förstärka telemetriga luckor, automatisera en felaktig diagnos eller skapa korrelerade åtgärder över hela flottan. Isolera miljöer, begränsa samtidighet, behåll en nödstoppknapp utanför modellen och öva på misslyckande av själva AIOps‑plattformen. Skydda loggar och ärenden som innehåller hemligheter eller personuppgifter. Övervaka modell‑drift, topologins aktualitet, falska åtgärder och överskrivningar. AIOps stödjer pålitlig drift när den gör bevis och begränsade åtgärder snabbare; den är inte ett autonomt ersättningssystem för tjänsteägarskap, incidentledning eller ingenjörsbedömning.
Arbetsexempel: AIOps för ett betalningsincident
AIOps grupperar en våg av API‑fel, databassaturering och regionala larm till en enda incident och berikar den med en nylig distribution, topologi och ägare. Den rangordnar distributionen som en sannolik bidragsgivare men visar rå telemetri och alternativ. En deterministisk policy pausar vidare utrullning; en mänsklig incidentkommandör godkänner trafikskiftet efter att ha kontrollerat att kapacitet och datakonsistens är säkra.
Systemet mäter grupperingens precision, upptäcktstid, rangordningsnoggrannhet, svarandets acceptans, återhämtning och falsk åtgärd i historisk återuppspelning och spel‑dagar. Alla automatiserade handlingar har gränser, idempotens, eftervillkorskontroller och återgång. Loggar saneras och skadlig text kan inte bli ett kommando. Efter incidenten uppdateras bekräftad orsak och åtgärdsresultat de granskade reglerna och utvärderingsdata. AIOps‑plattformen hjälper med bevis och samordning; den ersätter aldrig incidentledning eller extern auktorisation.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig felhändelse. Etablera en reproducerbar baslinje och en versionerad utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskifte, beroendeavbrott, missbruk och de grupper eller miljöer som sannolikt är underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, latens, genomströmning, resurskostnad, tillgänglighet, sekretess och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och skilja bevis från en attraktiv prototyp.
Innan lansering, tilldela ansvar för release, undantag, förändringar, återgång och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroendehälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödiga känsliga data. Definiera larmtrösklar och en svarsansvarig, granska sedan verkliga bevis efter driftsättning i stället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterade återhämtnings‑, incident‑lärande‑, raderings‑ och behållningsprocedurer samt en tydlig punkt där det ska inaktiveras eller ersättas.
Vanliga frågor
Är AIOps samma som observabilitet?
Nej. Observabilitet levererar och utforskar systemsignaler; AIOps använder analys och automatisering på dessa signaler. Båda kan existera utan den andra.
Kan AIOps avgöra grundorsak automatiskt?
Den kan rangordna hypoteser och samla bevis, men kausala påståenden kräver topologi, förändringskontext och validering. Många incidenter har samverkande orsaker.
Primära referenser