Grunderna i AI
Vad är IT-drift (ITOps)?

 Lägg till Unite.AI bland dina föredragna källor på Google
IT‑drift (ITOps) är arbetet med att driva de tekniktjänster som en organisation är beroende av. Det omfattar beräkning, nätverk, identitet, slutpunkter, molnplattformar, databaser, lagring, säkerhetskopior och de operativa processerna som håller dessa komponenter tillgängliga, säkra och stödbara.
Modern ITOps är inte begränsad till ett nätverksoperationscenter som övervakar instrumentpaneler. Team hanterar i allt större utsträckning programvarudefinierad infrastruktur, plattformstjänster, automatisering och distribuerat ägande samtidigt som de behåller ansvar för incidenter, kapacitet, kontinuitet och servicenivåer.
Viktiga slutsatser
- ITOps hanterar tjänster och deras beroenden över lokala, moln‑ och edge‑miljöer.
- Observabilitet, konfiguration och inventering ger det sammanhang som behövs för att tolka fel.
- Incidenthantering återställer tjänsten; problemhantering behandlar återkommande eller systematiska orsaker.
- ITOps överlappar med ITSM, SRE, DevOps, SecOps och AIOps men är inte identisk med någon av dem.
Tjänster, tillgångar och konfiguration
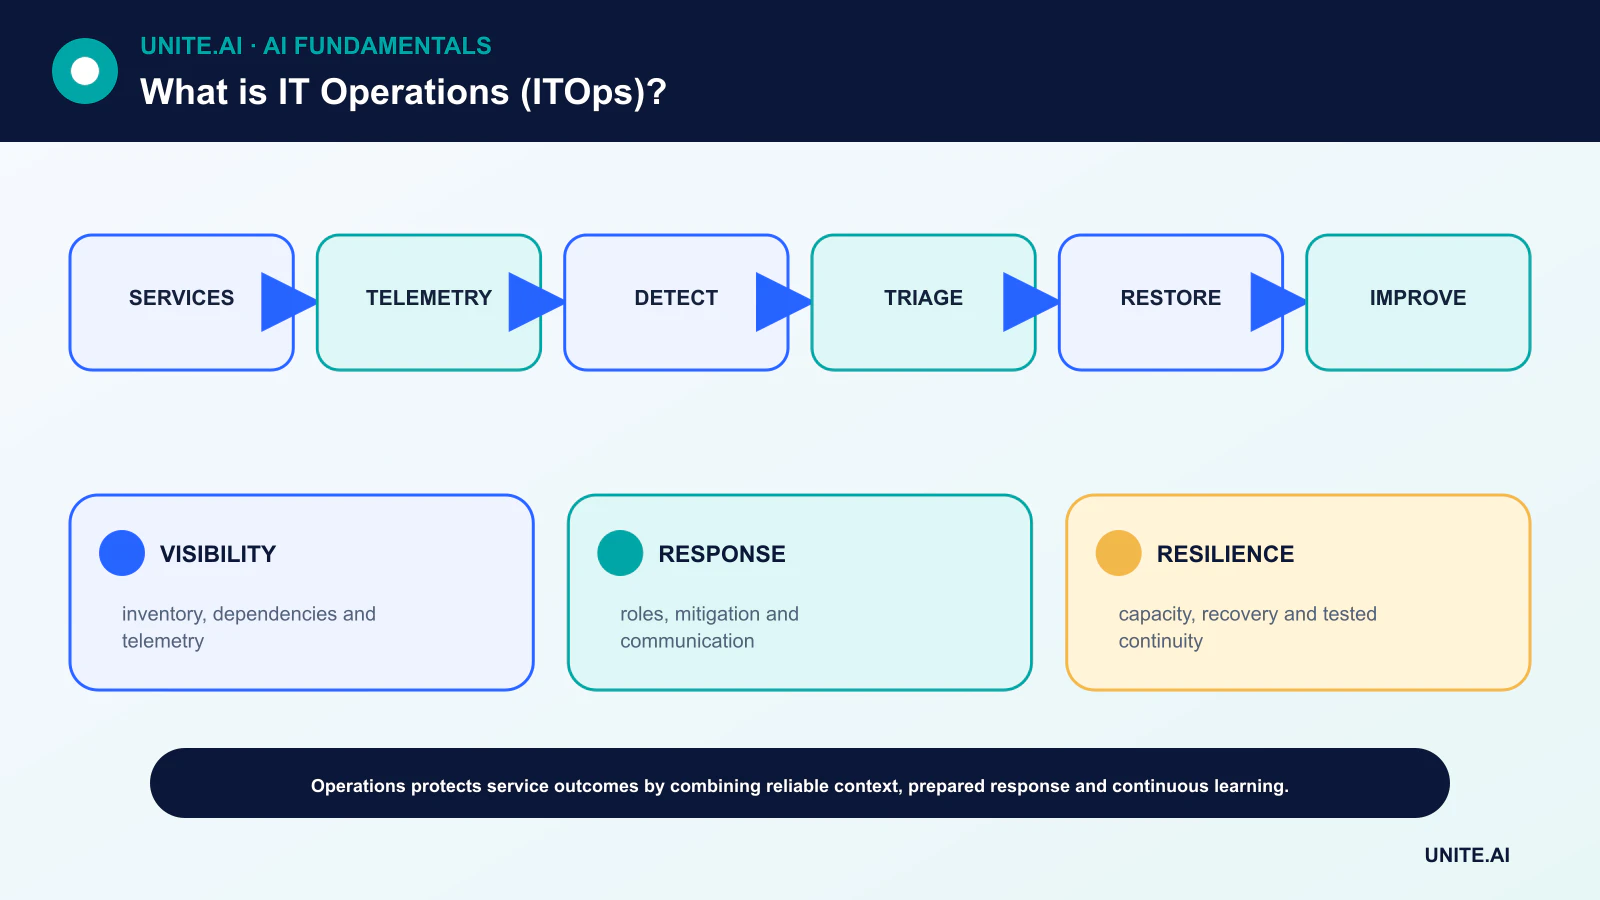
Drift börjar med att veta vilka tjänster som finns, vem som äger dem, vilka användare som är beroende av dem och vilken infrastruktur som stödjer dem. Tillgångsinventering registrerar komponenter; konfigurationshantering registrerar relevanta relationer och kontrollerat tillstånd.
En inventering som aldrig avstämmas blir missvisande. Automatisera upptäckt där det är användbart, identifiera auktoritativa källor och registrera förtroende eller aktualitet i stället för att låtsas att varje beroendemapp är komplett.
Observabilitet och tjänstemål
Mått kvantifierar beteende, loggar registrerar händelser och spår följer arbete över tjänster. Syntetiska kontroller kan testa en användarresa. Användbar observabilitet börjar med frågor och tjänstemål, och samlar sedan de signaler som behövs för att besvara dem.
Varningar bör identifiera förhållanden som kräver snabb åtgärd. Tröskelvärden utan användarpåverkan skapar brus, medan avsaknad av beroendekontext fördröjer diagnos. AIOps kan hjälpa till med korrelation, men det kräver pålitlig telemetri och operativ återkoppling.
Incident-, problem- och förändringshantering
Incidenthantering samordnar upptäckt, triage, begränsning, kommunikation och återställning. Klara roller minskar förvirring under press. En tillfällig lösning kan återställa tjänsten medan en senare problemundersökning adresserar djupare orsaker.
Förändringshantering utvärderar och registrerar risk utan att göra varje förändring till en kö. Standardiserade, automatiserade och lågriskförändringar kan följa förhandsgodkända vägar; förändringar med stor påverkan kräver starkare bevis, schemaläggning och återställningsförberedelser.
Kapacitet, motståndskraft och kontinuitet
Team prognostiserar resursbehov, tar bort flaskhalsar och testar beteende under belastning. Säkerhetskopior är bara användbara när återställning testas. Redundans hjälper bara när felmodeller är oberoende och failover faktiskt fungerar.
Affärskontinuitet definierar prioriteringar, återställningstid och acceptabel dataförlust. Beroenden på identitet, DNS, molnkontrollplaner och leverantörer bör inkluderas i övningar snarare än att antas vara tillgängliga.
ITOps, ITSM, SRE och DevOps
IT‑servicehantering tillhandahåller processer för att anpassa tjänster till organisationens behov. Site Reliability Engineering tillämpar mjukvaruteknik på drift och använder servicenivåmål och felbudgetar. DevOps förenar utvecklings‑ och driftfeedback.
SecOps fokuserar på hot och svar, medan ITOps upprätthåller en bredare tjänstehälsa. Organisationsscheman skiljer sig; det viktiga kravet är tydligt ägande och delade bevis över dessa discipliner.
ITOps‑operativmodellen
IT‑drift håller organisationens tekniktjänster tillgängliga, presterande, säkra och återställningsbara. Omfattningen inkluderar vanligtvis slutpunkter, identitet, nätverk, servrar, moln, lagring, samarbete, databaser, övervakning, servicedesk, backup och leverantörstjänster. Modern ITOps sträcker sig över egen infrastruktur och hanterade plattformar, så ansvaret måste vara tydligt även när driften outsourcas. En konfigurations‑ eller tjänsteinventering kopplar tekniska komponenter till ägare, användare, beroenden, dataklassificering och affärskritikalitet.
Servicehantering organiserar incidenter, förfrågningar, problem, förändringar, tillgångar, kunskap och servicenivåer. Incidenthantering återställer tjänsten; problemhantering undersöker återkommande orsaker; förändringsmöjliggörande bedömer och samordnar risk. Att behandla varje förändring som en långsam godkännandeprocess skapar kringvägar, medan ohanterad automatisering skapar okontrollerade fel. Standardiserade lågriskförändringar kan förhandsauktoriseras och automatiseras; högriskförändringar kräver bevis, kommunikation, återställning och schemaläggning baserat på påverkan.
Tillförlitlighet, kapacitet och kontinuitet
Övervakning bör följa användarorienterade tjänster och deras beroenden, inte bara antalet enheter. Definiera tillgänglighet, svarstid, kapacitet, aktualitet och stödobjektiv tillsammans med affärsägare. Varningssystemet ska larma vid handlingsbara symptom och felbudgetförbrukning; berika händelser med ägarskap och senaste förändringar. Kapacitetsplaneringsmodeller beaktar efterfrågan, mättnad, licenser och ledtid. Molnelasticitet minskar fördröjning vid provisionering men eliminerar inte kvoter, regionala begränsningar eller kostnadskontroll.
Affärskontinuitet kräver testade säkerhetskopior, återställning, identitetsåterhämtning, nätverksalternativ, leverantörskontakter och manuella rutiner. Definiera återställningstid‑ och återställningspunktmål per tjänst. En backup är inte bevis på återställning förrän den har återställts och validerats. Öva ransomware, förlust av region, utgångna certifikat, identitetsavbrott och leverantörsfel. Spåra konfiguration och infrastruktur som kod där det är möjligt så att återställning kan reproduceras.
Säkerhet, automatisering och mätvärden
Använd minsta privilegium, patch‑ och sårbarhetshantering, slutpunktskontroller, nätverkssegmentering, loggning och incidentrespons. Automatisera repetitivt arbete med idempotens, begränsningar, godkännanden och revision. Mät tjänstetillgänglighet, incidentåterkomster, förfrågningsuppfyllelse, förändringsfel, återhämtning, patchexponering, kapacitet, kostnad och användartillfredsställelse – inte bara ärendet stängning. ITOps är framgångsrik när tekniken stödjer arbetet förutsägbart och kan återhämta sig från fel, inte när infrastrukturen ser upptagen ut eller instrumentpaneler visar fler gröna indikatorer.
Arbetsexempel: återställa en samarbetsservice
Ett företag definierar ett återställningstid‑mål på fyra timmar och ett återställningspunktmål på en timme för en samarbetsplattform. Det inventerar identitet, DNS, nätverk, data, nycklar, konfiguration, integrationer och leverantörsberoenden. En återställningsövning antar att den primära regionen och administratörskontot är otillgängliga. Operatörer aktiverar en oberoende skyddad nödfallsidentitet, återställer tjänstekonfiguration och data i en isolerad region och validerar behörigheter, meddelanden, integrationer och klientåtkomst. Affärsägare verifierar den återställda tjänsten med realistiska användarresor snarare än att enbart förlita sig på infrastruktur‑hälsokontroller.
Övningen registrerar faktisk dataförlust, förfluten tid, manuella steg, misslyckade kontakter och dolda beroenden. En backup som återställer filer men inte krypteringsnycklar eller identitetspolicy markeras som ofullständig. Korrigerande åtgärder får ägare och datum, och körboken uppdateras och testas på nytt. Övervaknings‑ och kommunikationsmallar inkluderas. Organisationen mäter återhämtningsbevis snarare än backup‑jobbets framgång, med insikt om att pålitlig ITOps måste återställa den tjänst användarna behöver under realistiska felförhållanden.
Implementeringsbevis och operativ beredskap
Ett produktionsbeslut kräver mer än en lyckad demonstration. Definiera avsedda användare, driftsmiljö, indata, utdata, beroenden, ägare och konsekvensen av varje viktig fel. Etablera en reproducerbar baslinje och en versionsstyrd utvärderingsuppsättning innan finjustering. Testa vanliga fall, randvillkor, felaktig eller saknad indata, fördelningsskift, beroendeavbrott, missbruk samt de grupper eller miljöer som sannolikt blir underbetjänade. Mät uppgiftskvalitet tillsammans med kalibrering eller osäkerhet, svarstid, genomströmning, resurskostnad, tillgänglighet, integritet och säkerhet. Registrera varje transformation och tröskel så att en oberoende granskare kan reproducera resultatet och särskilja bevis från en attraktiv prototyp.
Före lansering, tilldela myndighet för release, undantag, förändringar, återställning och pensionering. Använd en stegvis utrullning, bevara en säker återgång och verifiera övervakning med avsiktligt injicerade fel. Operativ telemetri bör avslöja indata‑kvalitet, utdata‑beteende, modell‑ eller regelversion, beroende‑hälsa, mänskliga överskrivningar och bekräftade resultat utan att samla in onödiga känsliga data. Definiera varningströsklar och en ansvarig för respons, granska sedan verkliga bevis efter distribution i stället för att anta att offline‑prestanda kvarstår. Omvärdera när datakällor, användare, modeller, leverantörer, policyer, hårdvara eller mål förändras. Ett underhållet system behöver också dokumenterade återställnings-, incident‑lärande-, raderings‑ och bevarandeprocesser samt en tydlig punkt där det ska inaktiveras eller ersättas.
Vanliga frågor
Vad är det primära målet med ITOps?
Att leverera och återställa pålitliga tekniktjänster inom överenskomna säkerhets-, prestanda-, kontinuitets- och kostnadsramar.
Drivs molninfrastrukturen helt av molnleverantören?
Nej. Leverantörer driver delar av den underliggande plattformen, medan kunderna förblir ansvariga för konfiguration, identitet, data, arbetsbelastningar, övervakning och många servicenivåbeslut.
Primära referenser