
Grunderna i AI
Vad är incidentautomatisering? Arbetsflöden, skyddsmekanismer och användningsfall

 Lägg till Unite.AI bland dina föredragna källor på Google
Incidentautomatisering använder mjukvara för att upptäcka, berika, dirigera, samordna och ibland åtgärda operativa eller säkerhetsincidenter. Den kopplar övervakningssignaler till runbooks, ärendehantering, kommunikation, åtkomstkontroller och återställningsåtgärder så att svarande spenderar mindre tid på att kopiera data och mer tid på att fatta beslut.
Automatisering är inte ett borttagande av mänskligt ansvar. Ett säkert program skiljer lågrisk deterministiska steg från åtgärder som kan påverka kunder eller produktion, och tillämpar sedan godkännanden, avgränsade autentiseringsuppgifter, revisionsspår, tidsgränser och återställning beroende på påverkan.
Viktiga slutsatser
- Automatisera upprepningsbar insamling av bevis innan du försöker med autonom åtgärd.
- Använd allvarlighetsgrad, förtroende, påverkningsradie och reverserbarhet för att välja en godkännandenivå.
- Behandla varje runbook som versionsstyrd produktionskod med tester och en ansvarig.
- Mät upptäckt, bekräftelse, återställning, återupprepning och användarpåverkan – inte bara antalet larm.
Från signal till samordnad respons
Ett arbetsflöde kan avduplicera larm, bifoga senaste utrullningar och loggar, identifiera tjänsteägaren, öppna ett incidentregister, larma beredskapsgruppen, skapa en kommunikationskanal och påbörja en tidslinje. Dessa steg minskar den kognitiva belastningen utan att automatiskt göra en riskfylld diagnos.
Korrelation måste bevara bevis. Om en plattform grupperar symptom för aggressivt kan den dölja samtidiga incidenter. Koppla automatiseringen till IT‑drift-ägarskap och behåll de råa signalerna som svarande kan behöva.
Välj åtgärder efter risk
Read‑only‑frågor, ögonblicksbilder och reversibla trafikförflyttningar är generellt enklare att automatisera än att radera data, rotera breda autentiseringsuppgifter eller ändra ett produktionsschema. Definiera förutsättningar, en exekveringstidgräns, eftervillkor och en återställning för varje åtgärd.
Använd minst privilegierade tjänsteidentiteter och separera auktorisation från arbetsflödesmotorn. Steg med hög påverkan bör kräva en identifierad godkännare. Om AIOps föreslår en orsak eller åtgärd, behöver svarande fortfarande stödjande bevis och ett säkert sätt att avvisa dem.
Bygg pålitliga runbooks
En runbook bör deklarera indata, beroenden, ägare, omfattning, felbeteende och genererade bevis. Testa den i staging och under spel‑dagar. Idempotenta steg är värdefulla eftersom en omstart inte skapar ytterligare skada.
Versionera och granska automatisering som annan mjukvara. Övervaka utgång av autentiseringsuppgifter, API‑ändringar, hastighetsgränser, partiell exekvering och dold koppling mellan tjänster. Manuella rutiner förblir nödvändiga när automatiseringsplattformen själv är otillgänglig.
Lär efter återställning
Automatisering bör bevara en tidsstämplad logg över signaler, beslut, åtgärder, godkännanden och resultat. En skuldfri granskning kan sedan separera bidragande systemförhållanden från den slutgiltiga utlösen och omvandla lärdomar till testade förbättringar.
Användbara mått inkluderar medeltid för bekräftelse och återställning, andel säkra steg som automatiserats, felaktig‑åtgärds‑frekvens, återkommande incidenter och kundpåverkan. Koppla resultaten till DevOps-planering istället för att optimera för antalet stängda ärenden.
Typer av incidentautomatisering
Händelseautomatisering normaliserar och berikar inkommande signaler. Koordinationsautomatisering skapar ett incidentregister, larmar ägare, öppnar kommunikationskanaler och publicerar statusuppdateringar. Diagnostikautomatisering kör read‑only‑frågor eller tar ögonblicksbilder. Åtgärdsautomatisering förändrar systemtillstånd, medan återställningsautomatisering verifierar tjänstehälsa och stänger temporära mitigeringar.
Dessa kategorier bör inte dela en gemensam standardtillit. Berikning kan ofta köras automatiskt; ett produktions‑failover kan kräva förtroendekontroller och en godkännare; datatillbakagång kräver vanligtvis en incidentchef och applikationsägare. Kontroll bör följa potentiell påverkan, inte om steget implementeras av en regel eller en maskininlärningsmodell.
Säkerhetsincidenter lägger till krav på bevarandet av bevis. Automatisering måste undvika att ändra en komprometterad värd innan flyktig data har fångats, exponera känsliga indikatorer i offentliga kanaler eller karantänsätta delad infrastruktur utan att förstå påverkningsradien. Operativa och forensiska runbooks kan överlappa, men deras ordning kan skilja sig.
Arbetsflödesdesign och kontrollplan
Modellera runbooken som explicita tillstånd med förutsättningar och slutresultat. Varje åtgärd bör rapportera startad, lyckad, misslyckad, tidsgränsen överskriden eller hoppad över, tillsammans med en oföränderlig exekveringsidentifierare. En central orkestrator kan samordna steg, men nedströms tjänster bör verkställa sin egen auktorisation och validera indata oberoende.
Använd avgränsade, kortlivade autentiseringsuppgifter och begränsa nätverkspår från automationsmotorn. Separera utvecklings‑, test‑ och produktions‑körningar. Hemligheter får inte visas i chatttranskript eller loggar. För åtgärder med hög påverkan, krävs två‑personers godkännande eller en nödlägesroll vars användning skapar en omedelbar granskningsspår.
Designa för partiell fel. Ett ärende kan skapas medan larmning misslyckas; en trafikförflyttning kan lyckas i en region och tidsgränsen överskridas i en annan. Kompenserande åtgärder, avstämningsjobb och tydligt ägarskap förhindrar att arbetsflödet rapporterar framgång enbart för att orkestreringsprocessen avslutats.
Exempel, testning och mognad
Ett moget första användningsfall är uttömning av databasanslutningar: samla pool‑metrik, senaste utrullningar, långsamma frågor och ägarinformation; öppna en incident; föreslå en reversibel skalning eller trafikåtgärd; kräva godkännande; och sedan verifiera felrate och svarstid. samma mönster kan användas för certifikatutgång, diskutryck, misslyckade jobb eller misstänkt kontohändelse.
Testa runbooks med enhetstester, mockade API:er, staging‑incidenter, spel‑dagar och kontrollerade produktionsövningar. Inför föråldrad data, behörighetsavslag, långsamma beroenden, duplicerade händelser och motstridiga incidenter. Bekräfta att omförsök är säkra och att svarande kan ta manuell kontroll utan att kämpa mot automatiseringen.
Mognad utvecklas från notifikation, till berikning, till guidade åtgärder, till begränsad auto‑åtgärd. Framsteg bör baseras på bevis: stabil diagnos, låg felaktig‑åtgärds‑frekvens, verifierad återställning och tydlig användarnytta. Autonom avslutning bör vara sällsynt tills systemet kan bevisa återhämtning och bevara tillräckligt med bevis för senare lärande.
Arbetsexempel: automatisering av en produktionsservice‑incident
Tänk på ett betalnings‑API vars felrate ökar efter en utrullning. Övervakning skickar ett strukturerat larm som innehåller tjänst, miljö, region, version, felbudget och runbook‑länk. Automatisering berikar det med ändringspost, beroendehälsa, senaste loggar och ägarskap, och grupperar sedan duplicerade larm till en incident. En deterministisk policy kan omedelbart pausa vidare utrullning; en återställning bör kräva bevis på att den nya versionen är orsakssamband och att återställning är säker.
Arbetsflödet utser en incidentchef, öppnar kommunikationskanaler, registrerar en tidslinje och föreslår diagnostiska steg. Automatisk åtgärd startar med lågrisk, reversibla åtgärder såsom att flytta trafik till en frisk instans. Varje åtgärd kräver auktorisation, samtidighetsgränser, en tidsgräns, verifierade eftervillkor och återställning. Generativa sammanfattningar kan hjälpa svarande, men käll‑telemetri och kommandon förblir synliga så att teamet kan ifrågasätta en felaktig berättelse.
Mät tid till upptäckt, bekräftelse, begränsning och återhämtning; larmvolym; duplicat‑undertryckning; åtgärdsframgång; återupprepning; och skada orsakad av automatisering. Genomför spel‑dagar för utgångna autentiseringsuppgifter, partiella regioner, missledande larm och misslyckade återställningar. Efter återhämtning, bevara den faktiska tidslinjen, identifiera bidragande tekniska och organisatoriska förhållanden, uppdatera runbooks och tester, och följ korrigerande arbete till slutförande snarare än att betrakta en snabb begränsning som slutet på pålitlighetsarbetet.
Praktisk implementeringschecklista
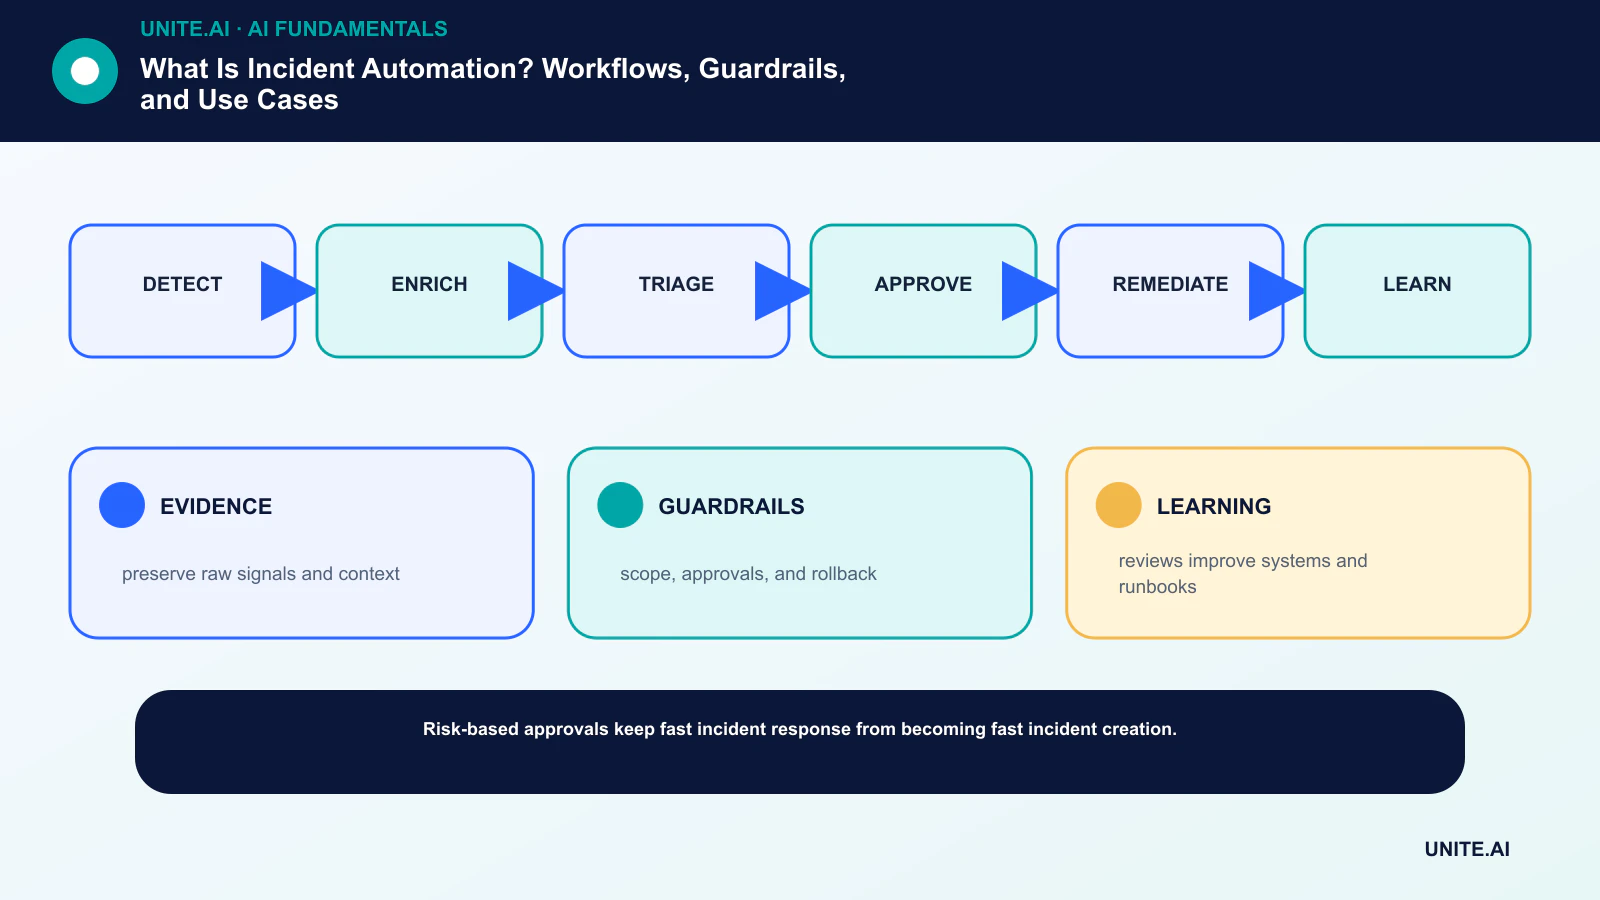
Omvandla konceptet till ett avgränsat, testbart arbetsflöde: upptäcka → berika → triagera → godkänna → åtgärda → lära. Namnge en ansvarig ägare, dokumentera data och beroenden, etablera en enkel baslinje, sätt godkännande‑ och stoppkriterier, testa representativa fel och definiera övervakning, återställning och granskning innan räckvidden utökas. Registrera versioner och antaganden så att ett annat team kan reproducera resultatet och förstå vad som förändrats.
Före lansering, genomför en dokumenterad beredskapsgranskning med de personer som bygger, driver, säkrar och påverkas av systemet. Testa normala fall, gränsvillkor, beroendefel och missbruk; bevara bevisen och olösta risker. Definiera vem som kan godkänna en release, ändra en tröskel, åsidosätta ett resultat eller stoppa driften. Ompröva beslutet när verkliga data anländer, eftersom en tekniskt framgångsrik pilot inte garanterar pålitlig prestanda i större skala.
- BEVIS: bevara råa signaler och kontext.
- SKYDDSRÄTTNINGAR: omfattning, godkännanden och återställning.
- LÄRANDE: granskningar förbättrar system och runbooks.
Vanliga frågor
Är incidentautomatisering detsamma som AIOps?
Nej. AIOps tillämpar analys eller maskininlärning på driftdata. Incidentautomatisering är det bredare exekverings‑ och samordningslagret; det kan använda enkla regler, AIOps‑resultat eller båda.
Vad bör automatiseras först?
Börja med högfrekventa, lågrisk, välförstådda steg såsom berikning, ägarsökning, bevisinsamling, statusuppdateringar och reversibla diagnostik.
Primära referenser











