
Основы ИИ
Что такое глубокое обучение с подкреплением?

 Добавьте Unite.AI в избранные источники в Google
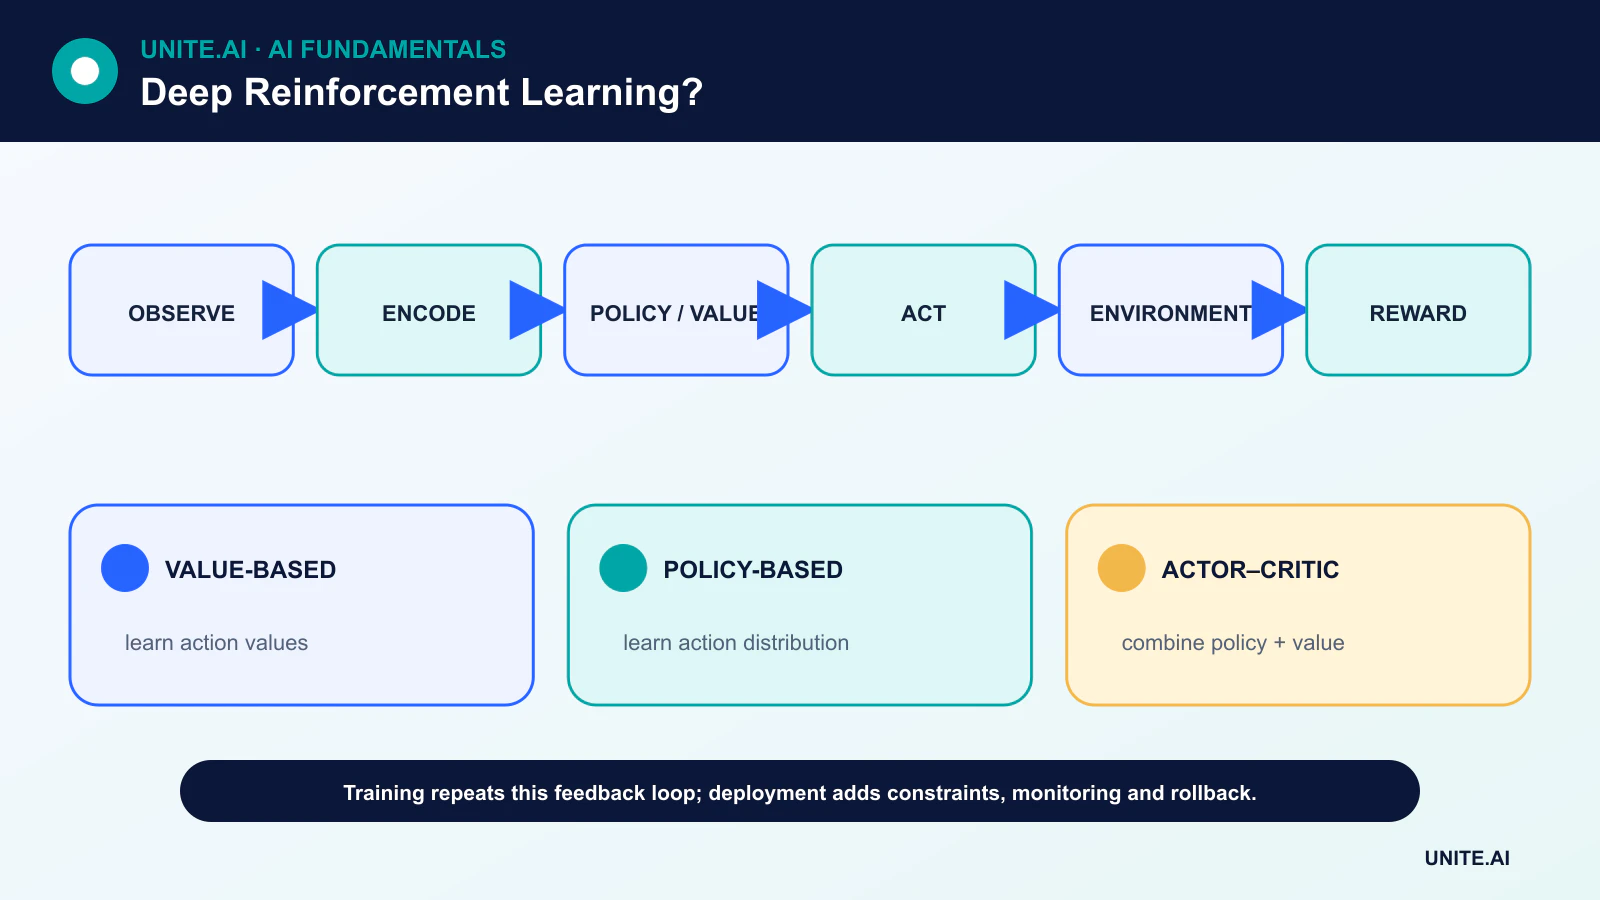
Глубокое обучение с подкреплением (deep RL) сочетает обучение с подкреплением и глубокие нейронные сети. Агент наблюдает состояние, выбирает действие, получает награду и новое наблюдение, затем корректирует политику или функцию ценности, чтобы улучшить будущие решения.
Глубокая сеть не устраняет сложные аспекты обучения с подкреплением. Она предоставляет гибкий способ представлять изображения, потоки датчиков, большие пространства действий или сложные функции ценности. Исследование, отложенное вознаграждение, нестабильное обучение и безопасная оценка в реальном мире остаются ключевыми инженерными задачами.
Ключевые выводы
- Глубокое обучение с подкреплением изучает последовательные решения через взаимодействие, а не из фиксированной таблицы размеченных примеров.
- Методы, основанные на ценности, оценивают, насколько хороши действия; методы политики напрямую обучают распределение действий; методы актёр‑критик комбинируют оба подхода.
- Буферы воспроизведения, целевые сети и тщательный дизайн наград могут улучшить обучение, но ни один из них не гарантирует надёжное поведение.
- Высокий показатель в симуляторе не является доказательством надёжности, безопасности или успешного переноса в реальный мир.
Проблема принятия решений: состояния, действия и награды
Многие задачи глубокого обучения с подкреплением моделируются как марковский процесс принятия решений. В момент t агент получает состояние или наблюдение st, выбирает действие at, затем получает награду rt+1 и следующее состояние. Целью является ожидаемая дисконтированная отдача, а не только следующая награда.
Коэффициент дисконтирования определяет, насколько важны отдалённые награды. Функция награды задаёт, чего будет стремиться процесс оптимизации, поэтому неполный прокси может приводить к поведению, которое технически успешно, но операционно нежелательно. Это одна из причин, почему дизайн наград и тестирование ограничений требуют такого же внимания, как и архитектура модели.
Методы, основанные на ценности, политике и актёр‑критик
Алгоритм, основанный на ценности, оценивает ценность состояния или действия. Глубокие Q‑сети используют нейронную сеть для аппроксимации Q‑значений и обычно выбирают действие с наивысшей оценкой, сохраняя некоторую исследовательскую составляющую. Алгоритм градиентного спуска по политике оптимизирует параметризованную политику, выдающую распределение действий.
Поэтому глубокое обучение с подкреплением опирается на те же основы, что и глубокое обучение, градиентный спуск и обратное распространение.
Почему буферы воспроизведения и целевые сети помогают
Последовательные образцы опыта коррелированы, а обновление сети меняет цели, используемые последующими обновлениями. Воспроизведение опыта разрывает часть этой временной корреляции, выбирая более старые переходы. Целевая сеть меняется медленнее, чем онлайн‑сеть, делая бутстрэп‑цели менее волатильными.
Эти механизмы повышают стабильность обучения, но настройка всё равно важна. Скорость обучения, график исследования, масштаб награды, состав буфера воспроизведения и ёмкость сети могут влиять на результат. Следует сообщать несколько случайных инициализаций, поскольку один запуск может вводить в заблуждение.
Офлайн‑RL, модель‑ориентированный RL и переход от симуляции к реальности
Офлайн‑RL обучается на фиксированном журнале данных без сбора новых взаимодействий. Это может быть полезно, когда исследование дорогостоящее или небезопасное, однако политика должна избегать действий, слабо представленных в журнале. Модель‑ориентированный RL обучает или использует модель переходов для планирования, меняя дополнительные предположения на эффективность выборки.
В робототехнике часто обучают в симуляции, рандомизируя физические параметры, а затем дообучают или проверяют на реальном оборудовании. Разрыв между симуляцией и реальностью всё ещё может выявлять ошибки восприятия, синхронизации, динамики контактов и непредвидённые граничные случаи. Система обучения с подкреплением должна оцениваться при возмущениях, смещении распределения и явных ограничениях безопасности.
Оценка и развертывание
Полезная оценка разделяет обучающие и тестовые среды, сообщает распределения отдачи, а не только лучшую оценку, и проверяет нарушения ограничений, частоту вмешательств и поведение в худшем случае. Для реальных систем командам также необходимы мониторинг, процедуры отката, ограниченные пространства действий и возможность человеческого вмешательства.
Глубокое обучение с подкреплением наиболее привлекательно, когда решения последовательные, доступна обратная связь и ручные правила управления недостаточны. Оно является плохим выбором, когда есть обильные размеченные данные, обычный оптимизатор решает задачу или исследование ставит людей или активы под угрозу.
Архитектуры глубокого RL и сигналы обучения
Глубокое обучение с подкреплением использует нейронные сети для представления функции ценности, политики, модели окружения или их комбинации. Глубокая Q‑сеть предсказывает значения действий и обучается на целевых значениях временной разницы; воспроизведение опыта уменьшает корреляцию между обновлениями, а целевая сеть стабилизирует меняющуюся цель. Методы градиентного спуска по политике напрямую оптимизируют ожидаемую отдачу, а методы актёр‑критик используют обученного критика для снижения дисперсии градиента. Непрерывные действия часто требуют детерминированных или стохастических вариантов актёр‑критик, тогда как дискретные высокоразмерные действия нуждаются в тщательном исследовании и проектировании вывода.
Обучение является нестационарным, поскольку политика меняет собираемые данные. Данные воспроизведения становятся вне политики, бутстрэп‑цели зависят от текущих оценок, а аппроксимация функций может усиливать ошибки — комбинация иногда называется смертельной триадой. Двойные оцениватели снижают переоценку ценности; функции преимущества улучшают распределение кредита; бонусы энтропии стимулируют исследование; ограниченные цели ограничивают разрушительные обновления политики. Нормализуйте наблюдения и награды только при безопасном состоянии без утечки, и фиксируйте окружение, обёртку, повтор действий, завершение и предобработку наград, поскольку каждый из этих факторов меняет задачу.
Оценка, симуляторы и безопасность развертывания
Отчёт о распределении отдачи следует делать по независимым инициализациям и экземплярам окружения, а не только по лучшему запуску. Оцените эффективность выборки, нарушения ограничений, катастрофические результаты, чувствительность к масштабу награды и устойчивость к шуму наблюдений, задержкам, ошибкам привода и изменённой динамике. Сравните с скриптовым управлением, классическим управлением, обучением под наблюдением и более простыми RL‑методами. Выделите варианты окружения и протестируйте метрики без награды, поскольку агент может эксплуатировать запрограммированную награду, не выполняя задуманную задачу. Анализ видео и траекторий часто раскрывает поведение, скрытое в агрегированной отдаче.
Симуляция позволяет исследовать, но вводит разрыв реальности. Рандомизируйте соответствующую физику и восприятие, калибруйте по реальным измерениям и используйте консервативный перенос. Журналированные данные или офлайн‑RL избегают онлайн‑исследования, но не могут надёжно оценивать действия, не поддерживаемые политикой поведения. Производственные системы должны ограничивать набор действий, их частоту, ресурсы и рабочий диапазон; требовать одобрения для действий с высоким воздействием; и включать проверенный безопасный контроллер или механизм остановки. Мониторьте входы политики, распределение действий, награду, реальные результаты и вмешательства, с откатом к проверенной версии политики.
Конкретный пример управления
Для маршрутизации складских роботов определите состояние по местоположению, нагрузке, уровню заряда, близкому трафику и очереди задач; действия — по разрешённым перемещениям и решениям о зарядке; награду — по выполненной работе, энергии, загруженности и ограничениям безопасности. Сначала обучайте в откалиброванном симуляторе с рандомизированным спросом и сбоями датчиков, затем сопоставляйте с реальными решениями. Никогда не позволяйте обученной политике обходить систему предотвращения столкновений. Оценивайте пропускную способность вместе с почти‑сбоями, тупиками, авариями батареи и наихудшей задержкой. Проект считается успешным только если многоуровневая система улучшает операции, не передавая неприемлемый риск исследования людям или оборудованию.
Практический пример: DRL для охлаждения дата‑центра
Дата‑центр ограничивает агента RL утверждёнными точками охлаждения и обучает его в симуляторе, откалиброванном на основе исторических данных о погоде, нагрузке, температурах и отклике оборудования. Награда включает энергопотребление, но жёсткие ограничения отдельно защищают температуру, влажность и циклирование оборудования. Модельно‑прогнозирующее управление и существующие правила служат базовыми. Оценка охватывает сезоны, шум датчиков, задержку привода, отказ оборудования, необычные нагрузки и несколько инициализаций, с отчётом об энергии, нарушениях, дисперсии и восстановлении.
Обученная политика работает в режиме теневого тестирования перед ограниченным пробным участком. Внешний контроллер безопасности ограничивает действия, а операторы могут вмешиваться. Мониторятся частота действий, покрытие состояний, неопределённость модели и реальные результаты объекта; несоответствие симуляции или повторные вмешательства вызывают откат. Обновление оборудования или логики управления создаёт новую версию окружения и валидацию. Экономия энергии принимается только тогда, когда надёжность, тепловой запас, обслуживание и реакция на неисправности остаются не менее сильными, чем у базовой линии.
Доказательства реализации и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочее окружение, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор для оценки перед настройкой. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиг распределения, отказ зависимостей, неправильное использование и группы или окружения, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развертывание, сохраняйте безопасный резерв и проверяйте мониторинг с преднамеренно введёнными сбоями. Оперативная телеметрия должна раскрывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реакцию, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте при изменении источников данных, пользователей, моделей, поставщиков, политик, аппаратного обеспечения или целей. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткого момента, когда её следует отключить или заменить.
Часто задаваемые вопросы
Является ли глубокое обучение с подкреплением тем же, что и глубокое обучение?
Нет. Глубокое обучение предоставляет функции‑аппроксиматоры; обучение с подкреплением обеспечивает взаимодействие, награду и цель последовательного принятия решений.
Означает ли высокая награда, что агент выучил задуманное поведение?
Не обязательно. Это лишь означает, что политика нашла поведение, которое хорошо оценивается по реализованной награде и в данной среде. Всё равно требуются независимые проверки безопасности и соответствия цели.
Основные ссылки












