
Основы ИИ
Что такое обучение с подкреплением по человеческой обратной связи (RLHF)?

 Добавьте Unite.AI в избранные источники в Google
Обучение с подкреплением по человеческой обратной связи (RLHF) — это семейство методов, использующих человеческие оценки для оптимизации модели, когда желаемое поведение трудно формализовать простым автоматическим вознаграждением. Для языковых моделей люди обычно сравнивают варианты ответов, а обученная модель предпочтений преобразует эти сравнения в обучающий сигнал.
RLHF может сделать предобученную модель более полезной или лучше соответствующей письменной политике, но не гарантирует её правдивости или согласованности с интересами каждого пользователя. Результат зависит от того, кто предоставляет обратную связь, как выбираются подсказки, что может представлять модель вознаграждения и как ограничивается оптимизация.
Ключевые выводы
- RLHF обычно следует за предобучением и обучением с учителем по инструкциям.
- Парные предпочтения обучают модель вознаграждения или предпочтений; затем оптимизация политики отдаёт предпочтение ответам с более высоким баллом.
- Хакерство вознаграждения, разногласия аннотаторов, сдвиг распределения и переоптимизация остаются важными рисками.
- Оценивать конечную политику следует напрямую по качеству задачи, безопасности, калибровке и эффектам на подгруппы.
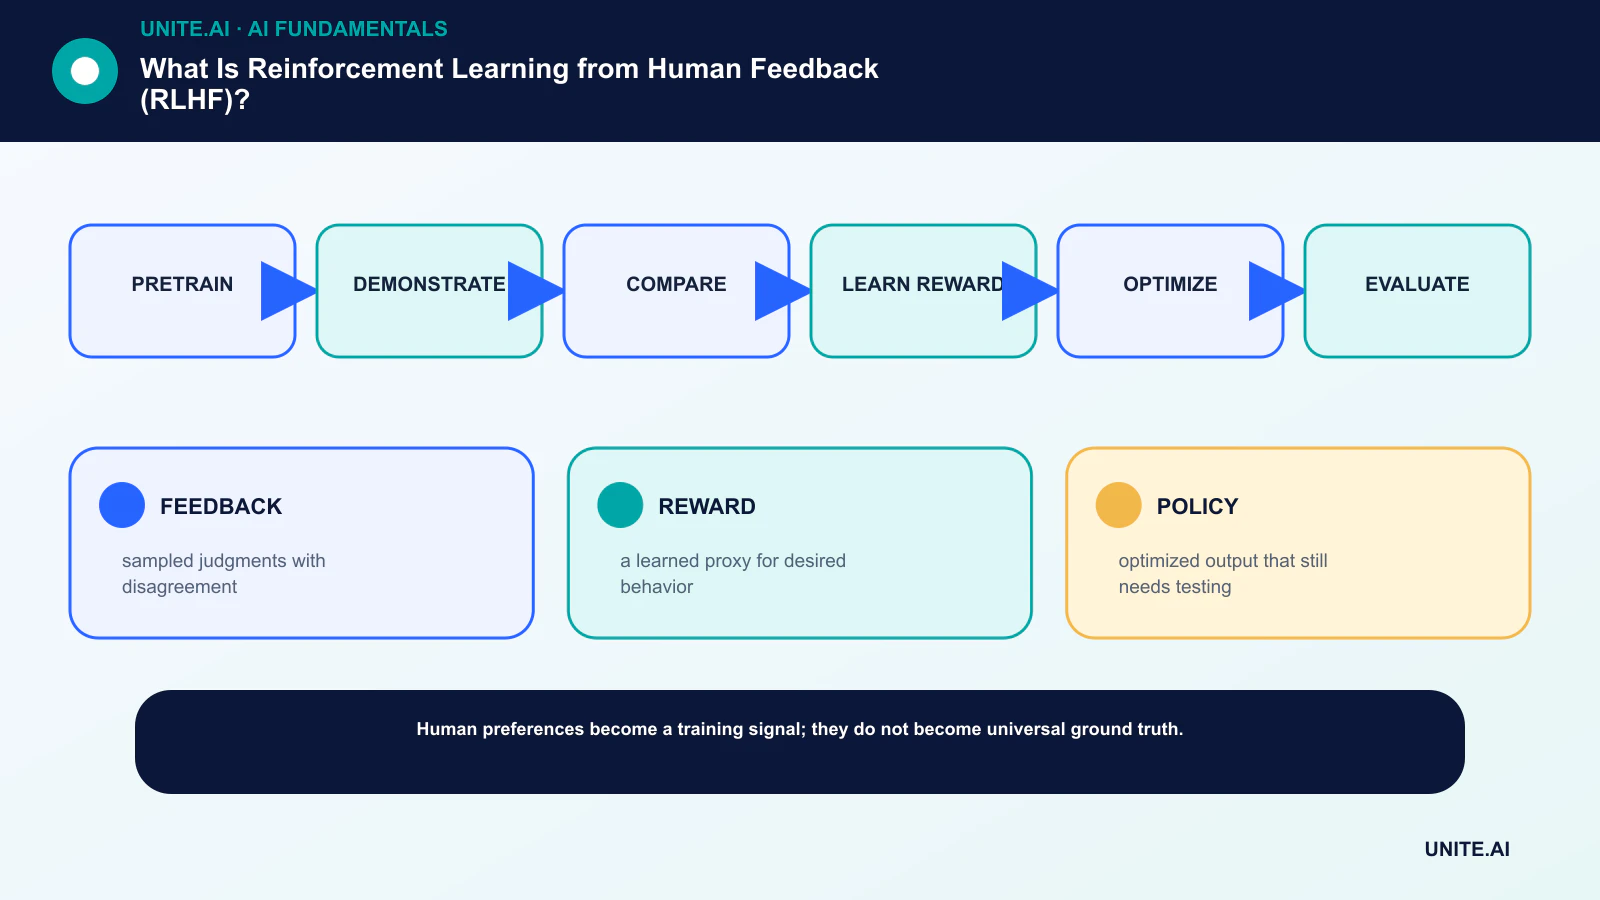
Типичный конвейер RLHF
Сначала языковая модель изучает широкую статистическую структуру в процессе предобучения. Затем обучение с учителем по инструкциям использует демонстрации желаемых ответов. Для сбора предпочтений аннотаторы ранжируют или выбирают между ответами на одну и ту же подсказку.
Модель вознаграждения обучается предсказывать эти сравнения. Алгоритм обучения с подкреплением, например PPO, может оптимизировать языковую модель относительно полученного вознаграждения, а штраф препятствует отклонению слишком далеко от референсной политики.
Обратная связь — измерение, а не истина
Аннотаторы могут расходиться во мнениях, потому что инструкции неоднозначны, экспертиза различается или ценности действительно конфликтуют. Позиция, многословность, уверенность и стиль могут влиять на предпочтения. Качественная программа обучает оценщиков, измеряет согласие, проверяет примеры и сохраняет неопределённость.
Выборка также важна. Если набор предпочтений исключает сложные языки, домены или вредоносный контент, модель вознаграждения не сможет надёжно их контролировать. Дисциплина Data‑science так же важна, как и оптимизатор.
Режимы отказа
Политика может эксплуатировать уязвимости обученного вознаграждения, генерируя ответы, которые получают высокий балл, но не соответствуют изначальному намерению. Чрезмерная оптимизация может снизить разнообразие, усилить предпочтительный стиль или сделать модель излишне согласующейся.
Сама модель вознаграждения может давать сбои за пределами своего обучающего распределения. Командам следует тестировать адверсариальные подсказки, фактические задачи, границы отказа, калибровку и поведение при разных уровнях оптимизации, а не полагаться лишь на один агрегированный показатель выигрыша предпочтений.
Альтернативы и дополнения
Прямая оптимизация предпочтений (Direct Preference Optimization) обучается на парах предпочтений без отдельного обучения политики через онлайн‑цикл обучения с подкреплением. Отбор отклонений, обучение с учителем по предпочтениям, правила‑основанная обратная связь и надзор процесса предлагают другие компромиссы.
Ни один метод не устраняет необходимость в подсказках, поиске, инструментах и контроле на уровне приложений. Постобучение формирует поведение; развернутые системы всё равно требуют обоснованных доказательств, разрешений, мониторинга и эскалации человеком.
Как обучаются модели предпочтений
Для подсказки x и двух ответов y₁ и y₂ модель предпочтений присваивает скалярные оценки и обучается так, чтобы предпочтительный ответ получил более высокий балл. Распространённая функция потерь основана на вероятности того, что одна оценка превышает другую. Это преобразует множество парных оценок в функцию, способную оценивать новые сгенерированные ответы.
Модель усваивает любые сигналы, предсказывающие собранные выборы. Если оценщики отдают предпочтение уверенной прозе, более длинным ответам, определённым культурным нормам или знакомым точкам зрения, эти корреляции могут стать признаками вознаграждения. Сбалансированные инструкции, контрпримеры, экспертный обзор и аудиты поверхностных предпочтений уменьшают, но не устраняют проблему.
Данные о предпочтениях могут включать ничьи, ранжирование, критики, скалярные метки или демонстрации. Выбор пар имеет значение: сравнения между явно разными ответами дают мало информации о тонких границах качества, тогда как только сложные пары могут сделать обучение нестабильным. Активный отбор может целенаправленно искать информативные разногласия, но при этом менять распределение данных.
Оптимизация политики и регуляризация
RLHF на основе PPO выбирает ответы текущей политики, оценивает их моделью вознаграждения и обновляет политику, чтобы увеличить ожидаемое вознаграждение. Штраф Кульбака‑Лейблера или аналогичное ограничение удерживает политику рядом с обучающим референсом, ограничивая разрушительный дрейф и препятствуя эксплуатации узких слабостей модели вознаграждения.
Сила оптимизации — параметр выбора. Слишком небольшая сила оставляет желаемое поведение без изменений; слишком большая может привести к хакерству вознаграждения, повторяющимся фразам, льстивому поведению или снижению разнообразия. В течение обучения следует сопоставлять метрики качества и безопасности с вознаграждением и отклонением, а не выбирать контрольную точку лишь по вознаграждению.
Методы прямой оптимизации предпочтений выводят целевую функцию из пар предпочтений и референсной модели без явного онлайн‑цикла RL. Они могут упростить обучение, но всё равно наследуют качество предпочтений, покрытие и предположения о референсной политике. Конституционная или генерируемая ИИ обратная связь меняет того, кто предоставляет метки; это не отменяет необходимости проверять ценности и сбои с участием людей.
Оценка и управление данными
Используйте слепые сравнения, тесты, специфичные для задач, адверсариальные подсказки, проверки фактичности, точность и полноту отказов, а также обзор подгрупп. По возможности отделяйте оценщиков от обучающих данных. Показатель выигрыша против более старой модели может скрывать абсолютные провалы, когда оба кандидата плохи.
Документируйте набор аннотаторов, их оплату, экспертизу, географию, язык, инструкции, воздействие на вредоносный контент, разногласия, процесс арбитража и контроль качества. Работа с обратной связью может нести психологический риск, а ответственные операции с данными включают поддержку работников и право отказаться от тревожных заданий.
После развертывания отслеживайте дрейф предпочтений и переобобщение. Политика, настроенная на повседневную помощь, может вести себя плохо в медицинском или юридическом контексте. Сохраняйте границы доменов, поиск, разрешения и эскалацию вне предположений RLHF и переобучайте только при наличии новых доказательств, оправдывающих изменение.
Конкретный конвейер обучения и оценки RLHF
Обычный проект начинается с предобученной языковой модели и набора инструкций для обучения с учителем. Затем аннотаторы сравнивают варианты ответов согласно письменному рубрику, охватывающему корректность, релевантность, стиль, безопасность и неопределённость. Парные предпочтения обучают модель вознаграждения или напрямую оптимизируют политику. Выборка должна включать обычные задачи, сложные граничные случаи, адверсариальные подсказки, несколько языков и области, где аннотаторы действительно расходятся во мнениях.
Точность модели вознаграждения на отложенных сравнениях необходима, но не достаточна. Оптимизированная политика может эксплуатировать ошибки вознаграждения, становиться излишне многословной, отказывать в безвредных запросах или терять способности. Отслеживайте бенчмарки задач, человеческие предпочтения, калибровку, безопасность, разнообразие и отклонение от референсной модели в ходе обучения. Периодически собирайте новые сравнения от меняющейся политики, чтобы данные предпочтений покрывали действительно генерируемые ответы.
Документируйте, кто предоставлял предпочтения, их инструкции, оплату, разногласия, контроль качества и культурные или доменные ограничения. Привлекайте экспертов‑рецензентов там, где ошибки могут нанести специализированный вред. Проводите ред‑тестинг как модели вознаграждения, так и финальной политики, поддерживайте регрессионные тесты поведения и поэтапное развертывание. RLHF формирует поведение согласно измеренным предпочтениям; он не доказывает правдивость, не устраняет предвзятость и не решает более широкую проблему формулирования того, что модель должна делать в каждом контексте.
Практический чек‑лист реализации
Превратите концепцию в ограниченный, проверяемый рабочий процесс: предобучение → демонстрация → сравнение → обучение вознаграждения → оптимизация → оценка. Назначьте ответственного владельца, задокументируйте данные и зависимости, установите простой базовый уровень, определите критерии приемки и остановки, протестируйте типичные сбои и задайте мониторинг, откат и ревью перед расширением охвата. Записывайте версии и допущения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают и затрагивают систему. Протестируйте обычные случаи, граничные условия, отказы зависимостей и злоупотребления; сохраните доказательства и нерешённые риски. Определите, кто может одобрять выпуск, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после получения реальных данных, потому что технически успешный пилот не гарантирует надёжную работу в масштабе.
- ОБРАТНАЯ СВЯЗЬ: отобранные оценки с разногласиями.
- ВОЗНАГРАЖДЕНИЕ: обученный прокси‑сигнал желаемого поведения.
- ПОЛИТИКА: оптимизированный вывод, требующий дальнейшего тестирования.
Часто задаваемые вопросы
RLHF — это то же самое, что дообучение?
RLHF — это форма постобучения, использующая вознаграждения, полученные из предпочтений. Обучение с учителем напрямую обучает на целевых выводах; во многих конвейерах применяются оба подхода.
RLHF делает модель правдивой?
Он может улучшить поведение, измеряемое процессом обратной связи, но модель всё равно может быть ошибочной, убедительной или стратегически эксплуатировать вознаграждение. Для правдивости требуется прямая оценка и обоснование.
Основные ссылки












