Основы ИИ
Что такое AIOps? Искусственный интеллект для ИТ‑операций

 Добавьте Unite.AI в избранные источники в Google
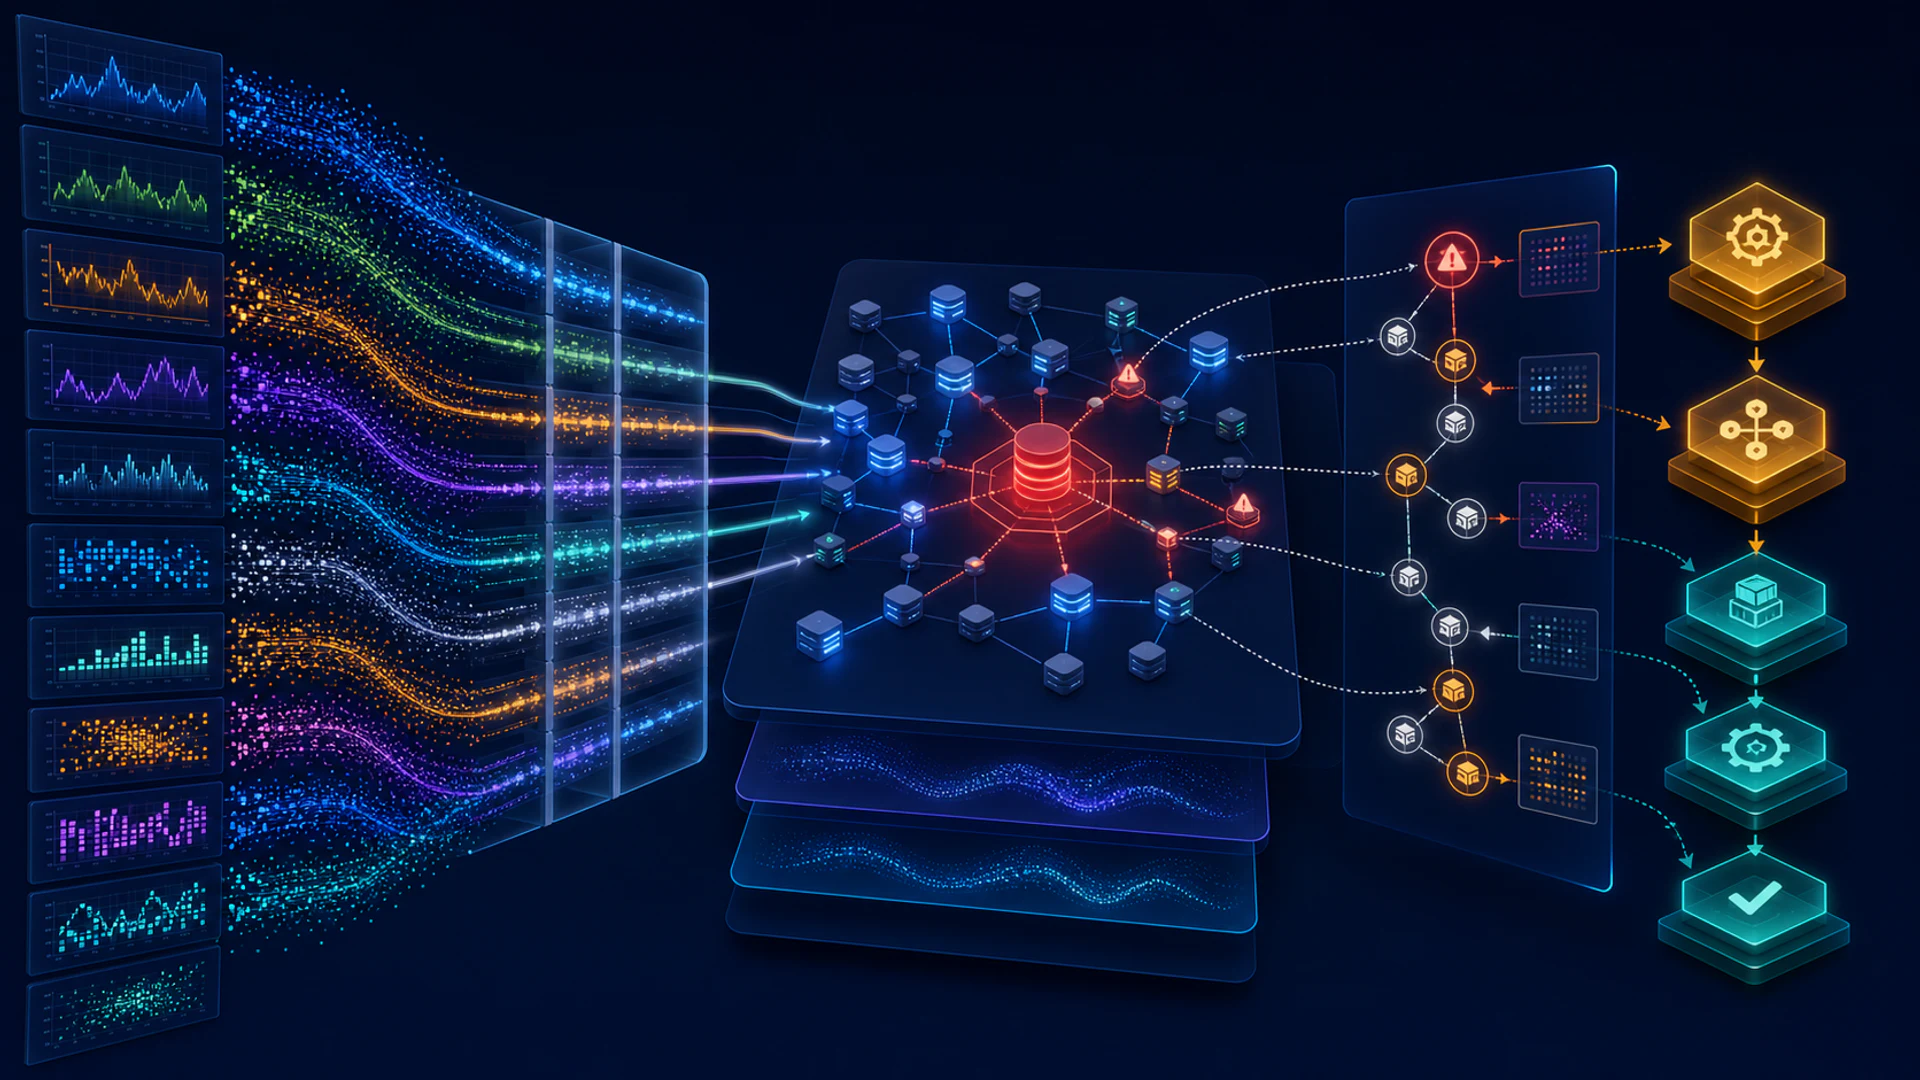
AIOps применяет машинное обучение и автоматизацию к данным ИТ‑операций, позволяя командам обнаруживать аномальное поведение, уменьшать количество дублирующих оповещений, связывать связанные события, ранжировать вероятные причины и рекомендовать или выполнять действия реагирования.
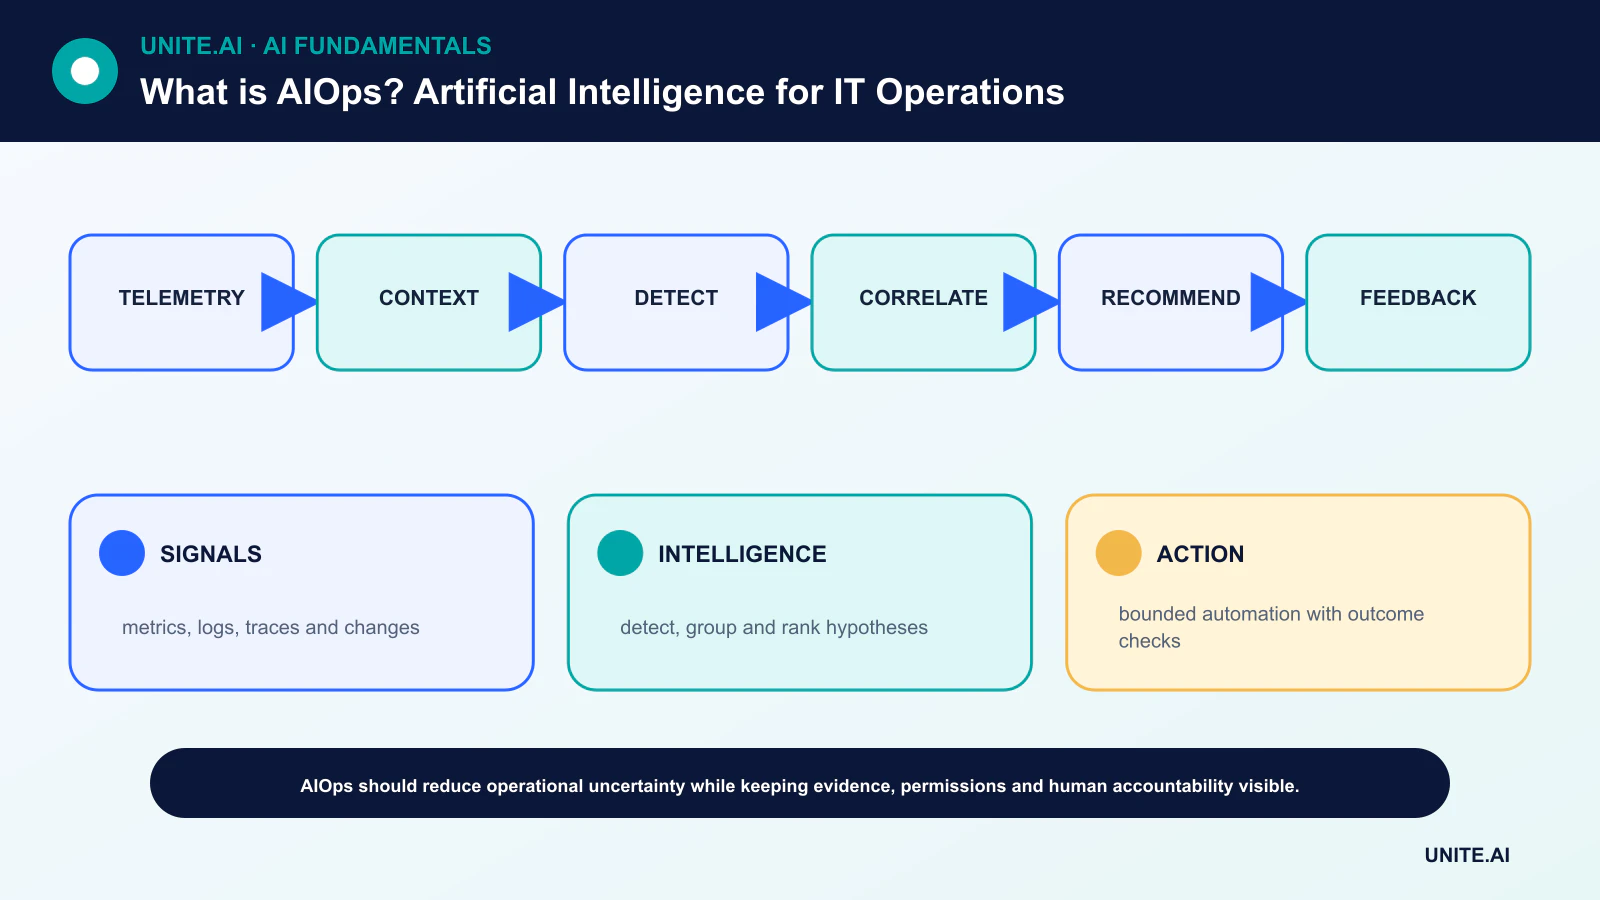
AIOps не является автономной заменой операций. Это слой внутри системы ITOps, и его ценность зависит от качества телеметрии, топологии сервисов, истории изменений, обратной связи от людей и безопасных границ автоматизации.
Ключевые выводы
- Нормализуйте события и добавляйте контекст сервиса перед применением сложных моделей.
- Обнаружение аномалий выявляет отклонения, но не обязательно сбои или коренные причины.
- Корреляция и ранжирование вероятных причин должны раскрывать доказательства и степень неопределённости.
- Автоматизированное исправление требует принципа наименьших привилегий, одобрений, канареек, отката и мониторинга результатов.
Создание операционного слоя данных
Платформы AIOps собирают метрики, журналы, трассировки, оповещения, заявки, топологию, развертывания и изменения конфигураций. Метки времени, идентификаторы и владение сервисом должны быть согласованы, чтобы система могла связывать сигналы, относящиеся к одному и тому же инциденту.
Отсутствие или несогласованный контекст приводит к ложным корреляциям. Сохранение данных, доступ и конфиденциальность также важны, поскольку журналы могут содержать учетные данные или персональную информацию. Применяйте те же правила управления, что и к другим системам производственных данных.
Обнаружение и снижение шума
Статические пороги работают для известных ограничений; статистические и методы машинного обучения могут моделировать сезонность или многовариантные паттерны. Дедупликация группирует повторяющиеся уведомления, а подавление удаляет оповещения, которые не подлежат действию согласно определённым правилам.
Аномалия — лишь отклонение от ожидаемого поведения. Плановые релизы, рекламные кампании и бизнес‑циклы могут быть необычными, но здоровыми. Оценивайте точность, полноту, задержку обнаружения и нагрузку оператора, а не количество удалённых оповещений.
Корреляция и вероятная причина
Корреляция событий связывает симптомы через граф зависимостей и временное окно. Модель вероятной причины может ранжировать компоненты или недавние изменения, которые могут объяснить инцидент. Это приоритизирует расследование; не устанавливает причинно-следственную связь.
Предоставляйте подтверждающие доказательства, альтернативные гипотезы и степень уверенности. Объяснимый ИИ особенно важен, когда оператор должен решить, изолировать сервис или откатить развертывание.
От рекомендаций к автоматизации
Руководство (runbook) может собирать диагностику, перезапускать безсостояние рабочее приложение или масштабировать мощность. Копилоты могут суммировать инциденты и извлекать процедуры. Агенты могут планировать вызовы инструментов, но разрешения в продакшене должны быть ограниченными, а действия проверяться относительно текущего состояния.
Начинайте с рекомендаций только для чтения. Продвигайте зрелые действия через симуляцию, человеческое одобрение, канарейки и автоматический откат. Записывайте входные данные, версию модели, авторизацию и результат каждого действия.
Оценка и операционная обратная связь
Воспроизводите исторические инциденты, не передавая их окончательные метки в признаки. Тестируйте на новых сервисах и изменениях, измеряйте ложное подавление, время обнаружения, время смягчения, принятие оператором и повторяемость. Сравнивайте с существующими правилами и простыми базовыми линиями.
Смещение происходит, когда меняются архитектура, трафик или практики реагирования. Замкните цикл, позволяя операторам корректировать корреляции и результаты, затем оцените, уменьшает ли система рутину без сокрытия рисков или создания самоуверенности в автоматизации.
Конвейер данных и аналитики AIOps
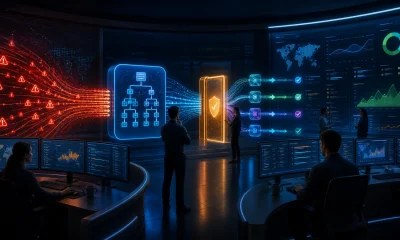
AIOps применяет статистические и методы машинного обучения к данным операций, таким как метрики, журналы, трассировки, события, топология, заявки и изменения. Конвейер собирает и нормализует сигналы, обогащает их контекстом сервиса и владения, обнаруживает аномалии, коррелирует связанные события, оценивает вероятные причины и рекомендует или инициирует действие. Качество зависит от меток времени, идентификаторов, топологии и записей об изменениях. Сложная модель не может надёжно коррелировать оповещения, относящиеся к одному сервису, при несогласованных названиях.
Обнаружение аномалий обучает базовые линии по сервису, сезону и состоянию эксплуатации; статические пороги могут быть лучше для известных пределов безопасности. Корреляция событий группирует симптомы в инцидент, используя время, топологию, текст и исторические паттерны. Ранжирование коренных причин предлагает гипотезы, но может спутать первое наблюдаемое сбой с истинной причиной или упустить общую зависимость, отсутствующую в топологии. Сводки на естественном языке могут помогать реагирующим, но должны ссылаться на исходные доказательства и указывать степень неопределённости.
Автоматизация, оценка и обратная связь
Начинайте с поддержки принятия решений и низкорисковой обратимой коррекции. Каждое автоматическое действие требует авторизации, предварительных условий, ограниченного объёма, таймаута, проверки постусловий, отката и аудиторского журнала. Модель не должна предоставлять себе учётные данные или рассматривать текст журналов как надёжные инструкции. Человеческие реагирующие должны принимать, отклонять или корректировать рекомендации, и эти результаты должны обновлять правила или обучающие данные через проверку, а не неконтролируемое самообучение.
Оценивайте сокращение оповещений без пропуска инцидентов, время до обнаружения, точность корреляции, ранжирование коренных причин, успех исправления, время восстановления, повторяемость и нагрузку реагирующего. Используйте историческое воспроизведение и внедрённые сбои, но учитывайте неполные метки инцидентов. Измеряйте по сервису и типу инцидента; среднее значение может скрывать опасные сбои в редких критических системах. Сравнивайте с детерминированными правилами и улучшенной наблюдаемостью перед добавлением сложности ИИ.
Управление и режимы отказов
AIOps может усиливать пробелы в телеметрии, автоматизировать неверный диагноз или создавать коррелированные действия по всему парку. Изолируйте окружения, ограничьте конкурентность, поддерживайте аварийный выключатель вне модели и отрабатывайте сбой самой платформы AIOps. Защищайте журналы и заявки, содержащие секреты или персональные данные. Мониторьте смещение модели, актуальность топологии, ложные действия и переопределения. AIOps поддерживает надёжные операции, когда ускоряет предоставление доказательств и ограниченных действий; он не является автономной заменой владения сервисом, командования инцидентом или инженерного суждения.
Практический пример: AIOps для инцидента с платежами
AIOps группирует всплеск ошибок API, насыщение базы данных и региональные оповещения в один инцидент и обогащает его недавним развертыванием, топологией и владельцем. Он ранжирует развертывание как вероятный фактор, но предоставляет сырую телеметрию и альтернативы. Детерминированная политика приостанавливает дальнейшее развертывание; человеческий командир инцидента одобряет переключение трафика после проверки, что ёмкость и согласованность данных безопасны.
Система измеряет точность группировки, время до обнаружения, точность ранжирования, принятие реагирующим, восстановление и ложные исправления в историческом воспроизведении и тренировочных днях. Все автоматические действия имеют ограничения, идемпотентность, проверки постусловий и откат. Журналы очищаются, и вредоносный текст не может стать командой. После инцидента подтверждённая причина и результаты действий обновляют проверенные правила и данные оценки. Платформа AIOps помогает в предоставлении доказательств и координации; она никогда не заменяет командование инцидентом или внешнюю авторизацию.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочее окружение, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, сдвиг распределения, отказ зависимостей, неправильное использование и группы или окружения, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный развертывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Операционная телеметрия должна раскрывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, человеческие переопределения и подтверждённые результаты без сбора ненужных конфиденциальных данных. Определите пороги оповещений и ответственного за реагирование, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте каждый раз, когда меняются источники данных, пользователи, модели, поставщики, политики, оборудование или цели. Поддерживаемая система также требует документированных процедур восстановления, обучения после инцидентов, удаления и хранения, а также чёткой точки, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Является ли AIOps тем же, что наблюдаемость?
Нет. Наблюдаемость предоставляет и исследует сигналы системы; AIOps использует аналитику и автоматизацию над этими сигналами. Каждая из них может существовать без другой.
Может ли AIOps автоматически определить коренную причину?
Он может ранжировать гипотезы и собирать доказательства, но утверждения о причинности требуют топологии, контекста изменений и валидации. Многие инциденты имеют взаимосвязанные причины.
Основные ссылки