
Основы ИИ
Что такое инженерия платформ? Платформы, опыт разработчиков и контрольные механизмы

 Добавьте Unite.AI в избранные источники в Google
Инженерия платформ — это практика создания и эксплуатации общих внутренних возможностей, помогающих командам разработки поставлять и запускать приложения через поддерживаемые самообслуживаемые рабочие процессы. Платформа рассматривается как продукт, пользователями которого являются разработчики и другие технические команды.
Платформа автоматически не является ни порталом, ни кластером Kubernetes, ни набором скриптов. Она становится полезной, когда снижает когнитивную нагрузку и время выполнения, одновременно повышая надёжность, безопасность, наблюдаемость и согласованность в организации.
Ключевые выводы
- Начинайте с исследований разработчиков и повторяющихся проблем, а не с заранее определённого набора инструментов.
- Предлагайте опциональные, поддерживаемые «золотые пути» с чёткими способами выхода для законных исключений.
- Открывайте возможности через API, шаблоны, автоматизацию и документацию; портал — лишь один из интерфейсов.
- Измеряйте результаты для пользователей и принятие продукта совместно с доставкой, надёжностью, безопасностью и стоимостью.
Платформа как внутренний продукт
Команда платформы определяет внутренних пользователей, их пути, проблемные точки и желаемые результаты. Она поддерживает дорожную карту, уровни обслуживания, документацию, поддержку и циклы обратной связи, как любая продуктовая команда. Принятие достигается за счёт полезности, а не навязывается именованием центральной команды.
Это расширяет сотрудничество DevOps. Команды приложений сохраняют владение своими сервисами, тогда как платформа предоставляет переиспользуемые возможности и политику.
Возможности, порталы и золотые пути
Возможности могут включать репозитории, среды, CI/CD, секреты, идентификацию, инфраструктуру, наблюдаемость, каталоги сервисов, затраты и интеграцию с инцидентами. Портал разработчика может их отображать, но оркестрация и эксплуатационные сервисы делают платформу реальной.
Золотой путь — это хорошо поддерживаемый способ выполнения распространённой задачи. Он должен включать безопасные значения по умолчанию и оставаться прозрачным. Командам нужен управляемый путь исключения, когда требования отличаются.
Архитектура и ограничительные механизмы
Используйте стабильные интерфейсы и декларативные API, чтобы платформа могла развиваться за их пределами. Разделяйте управляющую плоскость и рабочие нагрузки, ограничивайте полномочия, сохраняйте метаданные владения и делайте генерируемые изменения проверяемыми и обратимыми.
Интегрируйте проверки, политику и происхождение артефактов DevSecOps в рабочие процессы. Ограничительные механизмы должны обеспечивать быстрый отклик и практические меры исправления, а не необъяснённые отказы.
Измерение и развитие
Измеряйте время до первой деплоймента, время выполнения, восстановление после неудачных изменений, доступность платформы, нагрузку на поддержку, уровень принятия, удовлетворённость, состояние безопасности и затраты. Не используйте количество входов в портал как показатель улучшения доставки.
Оснастите платформу практиками IT‑операций и регулярно опрашивайте пользователей. Выводите из эксплуатации неиспользуемые пути, стандартизируйте там, где повторения дорогостоящи, и допускайте разнообразие, когда оно создаёт ценность продукта.
Внутренние платформы разработчиков и золотые пути
Внутренняя платформа разработчиков — это продукт, который предоставляет одобренную инфраструктуру и эксплуатационные возможности через интерфейсы самообслуживания. Она может объединять портал, каталог сервисов, шаблоны, API, инструменты командной строки, процессы деплоймента, секреты, среды и наблюдаемость. Платформа не заменяет облако или Kubernetes; она упорядочивает их в удобные возможности.
Золотой путь — это преднамеренный, поддерживаемый способ выполнения распространённой задачи, например создания сервиса с репозиторием, конвейером CI, средой выполнения, панелями мониторинга, оповещениями и метаданными владения. Он должен быть самым простым безопасным вариантом, позволяя при этом обоснованные исключения. Обязательный путь, не способный поддерживать реальные нагрузки, превращается в узкое место или обходится.
Команды платформ должны рассматривать разработчиков как клиентов, а возможности — как продукты. Интервью по выявлению потребностей, аналитика использования, данные поддержки, дорожные карты, документация и цели уровня обслуживания важны так же, как и автоматизация. Принятие служит доказательством полезности, но само по себе не доказывает, что доставка, надёжность, безопасность или опыт разработчиков улучшились.
Управляющие плоскости, интерфейсы и модель эксплуатации
Управляющая плоскость платформы согласует заявленное разработчиком намерение с базовыми ресурсами. Определение сервиса может запрашивать среду выполнения, базу данных, регион и уровень надёжности; контроллеры преобразуют это в конфигурацию облака, сети, политики и наблюдаемости. Стабильные абстракции должны скрывать случайную сложность, не пряча при этом операционное состояние, необходимое для отладки.
Интерфейсы могут включать веб‑порталы, API, конфигурацию на основе Git, CLI и переиспользуемые компоненты конвейера. Наилучший интерфейс зависит от частоты задач и рабочего процесса пользователя. Каждый интерфейс требует аутентификации, авторизации, валидации, истории аудита, объяснений ошибок и версионирования. Самообслуживание без управления жизненным циклом приводит к оставленным ресурсам и разрастанию конфигураций.
Команда платформы владеет общими возможностями и подготовленными путями, тогда как команды приложений сохраняют ответственность за поведение программного обеспечения и бизнес‑результаты. Команды безопасности, надёжности, финансов и инфраструктуры вносят политику и сервисы. Чётко определённые границы ответственности препятствуют превращению платформы в неконтролируемую очередь тикетов или в попытку централизовать каждое инженерное решение.
Измерение ценности и предотвращение провала платформы
Измеряйте время до первой продуктивной деплоймента, время создания среды, частоту деплойментов, процент неудачных изменений, время восстановления, когнитивную нагрузку, объём поддержки, надёжность и уровень внедрения средств безопасности. Разбивайте результаты по командам и типам нагрузок. Быстрый запуск шаблона имеет ограниченную ценность, если последующие изменения остаются медленными или инциденты труднее диагностировать.
Распространённые провалы включают построение без понимания пользователей, копирование стека крупной компании, раскрытие сырой инфраструктуры за порталом, принудительную преждевременную стандартизацию и оптимизацию под результаты команды платформы. Начните с одного болезненного повторяющегося пути, пропишите его шаги и ожидания, предоставьте лёгкий сквозной процесс и итеративно улучшайте его, опираясь на наблюдаемые результаты.
Платформы должны развиваться без дестабилизации всех сервисов. Используйте версионированные контракты, окна устаревания, автоматические миграции, тесты совместимости и чёткое распределение ответственности. Отслеживайте зависимости платформы, чтобы сбой управляющей плоскости не блокировал все деплойменты или не повреждал работающие нагрузки. Документируйте процедуры экстренного доступа и регулярно проверяйте восстановление после отказа платформы.
Практический пример: путь самообслуживания для нового API
Разработчик выбирает одобренный шаблон API и указывает название сервиса, владельца, классификацию данных, язык и уровень надёжности. Платформа создаёт репозиторий, политику зависимостей, конвейер CI, тестовую среду, конфигурацию деплоймента, запись в каталоге сервисов, панели мониторинга, оповещения и начальный набор инструкций. Политика проверяет имена, регионы, разрешения и сетевое раскрытие перед provisioning, при этом сгенерированные артефакты остаются проверяемыми и принадлежат команде.
Платформа предоставляет операции жизненного цикла — создание среды, деплой, масштабирование, ротацию секрета, просмотр логов, откат и вывод из эксплуатации — через стабильные API и портал. Рабочие нагрузки продолжают работать, если портал недоступен. Исключения используют документированную точку расширения с ограниченным сроком действия, а не незарегистрированные ручные изменения. Версионированные шаблоны и автоматические миграции предотвращают тихие поломки существующих сервисов при улучшении платформы.
Измеряйте время от создания репозитория до стабильного продакшн‑деплоймента, усилия разработчиков, спрос на поддержку, неудачные изменения, восстановление, соответствие политике и принятие по типу нагрузки. Проводите интервью с пользователями, которые бросают путь, и изучайте, где они ждут или обходят абстракцию. Команда платформы должна приоритизировать наибольшие повторяющиеся трения, публиковать надёжность и дорожную карту, а также выводить из эксплуатации неиспользуемые возможности. Отшлифованный каталог не является платформой, если командам всё ещё нужны тикеты для каждой значимой операции.
Принятие должно происходить поэтапно. Начните с добровольных команд и одного класса нагрузок, подтвердите работу после первого дня, затем мигрируйте с помощью инструментов и поддержки. Публикуйте цели сервисов платформы и статус зависимостей, а также разрабатывайте экстренный путь, который контролируем, но пригоден в случае сбоев. Модели chargeback или showback могут раскрывать стоимость ресурсов, однако продуктовым командам также нужны разумные значения по умолчанию, чтобы финансовое управление не превратилось в очередную ручную схему одобрения.
Практический чек‑лист внедрения
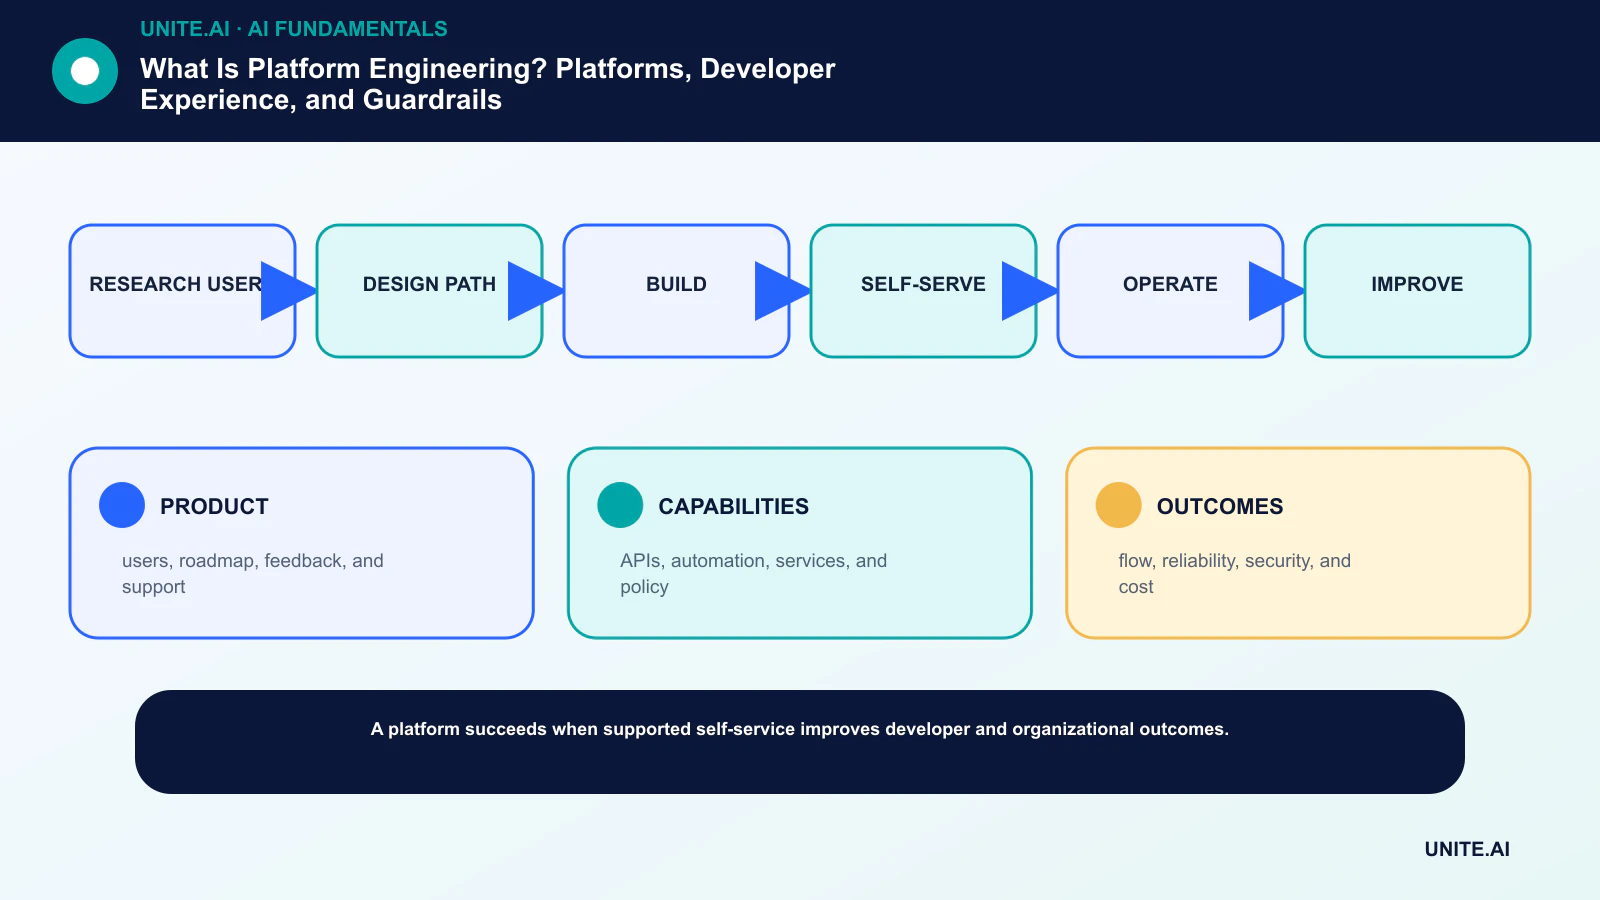
Преобразуйте концепцию в ограниченный, проверяемый рабочий процесс: исследование пользователей → проектирование пути → построение → самообслуживание → эксплуатация → улучшение. Назначьте ответственного владельца, задокументируйте данные и зависимости, установите простую базовую линию, определите критерии приёма и прекращения, протестируйте типичные отказы и задайте мониторинг, откат и ревью перед расширением охвата. Зафиксируйте версии и допущения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, обеспечивают безопасность и затронуты системой. Тестируйте обычные сценарии, граничные условия, отказы зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять релиз, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после получения реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- PRODUCT: пользователи, дорожная карта, обратная связь и поддержка.
- CAPABILITIES: API, автоматизация, сервисы и политика.
- OUTCOMES: поток, надёжность, безопасность и стоимость.
Часто задаваемые вопросы
Заменяет ли инженерия платформ DevOps?
Нет. Инженерия платформ — один из способов масштабировать принципы DevOps, предоставляя общие продукты и возможности самообслуживания. Сотрудничество и владение сервисами остаются ключевыми.
Является ли внутренний портал разработчиков самой платформой?
Обычно нет. Портал — это интерфейс. Платформа также включает API, автоматизацию, инфраструктуру, политики, сервисы, документацию, поддержку и эксплуатационную собственность.
Основные ссылки











