
Основы ИИ
Что такое автоматизация инцидентов? Рабочие процессы, ограничения и примеры применения

 Добавьте Unite.AI в избранные источники в Google
Автоматизация инцидентов использует программное обеспечение для обнаружения, обогащения, маршрутизации, координации и иногда устранения операционных или безопасностных инцидентов. Она связывает сигналы мониторинга с руководствами (runbooks), системой тикетов, коммуникациями, контролем доступа и действиями по восстановлению, позволяя реагирующим тратить меньше времени на копирование данных и больше — на принятие решений.
Автоматизация не означает устранения человеческой ответственности. Безопасная программа различает низко‑рисковые детерминированные шаги и действия, которые могут затронуть клиентов или продакшн, и применяет одобрения, ограниченные учётные данные, аудиторские журналы, тайм‑ауты и откаты в зависимости от воздействия.
Ключевые выводы
- Автоматизировать повторяющийся сбор доказательств до попытки автономного устранения.
- Использовать степень тяжести, уверенность, радиус воздействия и обратимость для выбора уровня одобрения.
- Относиться к каждому руководству как к версии кода продакшна с тестами и владельцем.
- Измерять обнаружение, подтверждение, восстановление, повторяемость и влияние на пользователей — а не только объём оповещений.
От сигнала к скоординированному реагированию
Рабочий процесс может удалять дублирующие оповещения, прикреплять последние развертывания и журналы, определять владельца сервиса, открывать запись инцидента, вызывать дежурную команду, создавать канал коммуникации и запускать хронологию. Эти шаги снижают когнитивную нагрузку без автоматической рискованной диагностики.
Корреляция должна сохранять доказательства. Если платформа слишком агрессивно группирует симптомы, это может скрыть одновременные инциденты. Свяжите автоматизацию с владением IT operations и сохраняйте исходные сигналы, которые могут понадобиться реагирующим.
Выбор действий по уровню риска
Запросы только для чтения, снимки и обратимые переключения трафика, как правило, проще автоматизировать, чем удаление данных, ротация широких учётных данных или изменение схемы продакшна. Для каждого действия определите предусловия, тайм‑аут выполнения, постусловия и откат.
Используйте сервисные идентификаторы с минимальными привилегиями и отделяйте авторизацию от движка рабочего процесса. Шаги с высоким воздействием должны требовать идентифицированного одобрителя. Если AIOps предлагает причину или исправление, реагирующим всё равно нужны подтверждающие доказательства и безопасный способ отклонить их.
Создание надёжных руководств (runbooks)
Руководство должно описывать входные данные, зависимости, владельца, область, поведение при сбоях и генерируемые доказательства. Протестируйте его в стенд‑окружении и в рамках игровых дней. Идемпотентные шаги ценны, поскольку их повтор не наносит дополнительного вреда.
Версионируйте и проверяйте автоматизацию так же, как другое программное обеспечение. Следите за истечением срока действия учётных данных, изменениями API, ограничениями скорости, частичным выполнением и скрытой связью между сервисами. Ручные процедуры остаются необходимыми, когда сама платформа автоматизации недоступна.
Обучение после восстановления
Автоматизация должна сохранять временную метку записей сигналов, решений, действий, одобрений и результатов. Бескровный обзор позволяет отделить способствующие условия системы от конечного триггера и превратить выводы в проверенные улучшения.
Полезные метрики включают среднее время до подтверждения и восстановления, процент безопасных автоматизированных шагов, уровень неудачных действий, повторные инциденты и влияние на клиентов. Связывайте выводы с планированием DevOps, а не оптимизируйте только количество закрытых тикетов.
Типы автоматизации инцидентов
Автоматизация событий нормализует и обогащает входящие сигналы. Автоматизация координации создаёт запись инцидента, вызывает владельцев, открывает каналы коммуникации и публикует обновления статуса. Диагностическая автоматизация выполняет запросы только для чтения или делает снимки. Автоматизация устранения меняет состояние системы, тогда как автоматизация восстановления проверяет здоровье сервиса и закрывает временные меры.
Эти категории не должны иметь один общий уровень доверия по умолчанию. Обогащение часто может выполняться автоматически; переключение продакшна может потребовать проверок уверенности и одобрителя; восстановление данных обычно требует командира инцидента и владельца приложения. Управление должно следовать потенциальному воздействию, а не тому, реализовано ли действие правилом или моделью машинного обучения.
Безопасностные инциденты добавляют требования по сохранению доказательств. Автоматизация должна избегать изменения скомпрометированного хоста до захвата волатильных данных, раскрытия чувствительных индикаторов в публичных каналах или карантина общей инфраструктуры без понимания радиуса воздействия. Операционные и судебно‑медицинские руководства могут пересекаться, но их порядок может различаться.
Проектирование рабочего процесса и контрольный слой
Моделируйте руководство как явные состояния с предусловиями и конечными результатами. Каждое действие должно сообщать о начале, успехе, неудаче, тайм‑ауте или пропуске, вместе с неизменяемым идентификатором выполнения. Центральный оркестратор может координировать шаги, но нижестоящие сервисы должны самостоятельно обеспечивать авторизацию и независимо проверять входные данные.
Используйте ограниченные, краткоживущие учётные данные и ограничьте сетевые пути от движка автоматизации. Разделяйте среды разработки, тестирования и продакшн. Секреты не должны появляться в чат‑транскриптах или журналах. Для действий с высоким воздействием требуйте одобрения двумя людьми или роль «break‑glass», использование которой создаёт мгновенный журнал проверки.
Проектируйте на случай частичных сбоев. Тикет может быть создан, пока вызов не удался; переключение трафика может завершиться успешно в одном регионе и тайм‑аутом в другом. Компенсирующие действия, задачи согласования и чёткое распределение ответственности предотвращают сообщение о успехе только потому, что процесс оркестрации завершён.
Примеры, тестирование и зрелость
Первый зрелый пример — истощение соединений с базой данных: собрать метрики пула, последние развертывания, медленные запросы и информацию о владельце; открыть инцидент; предложить обратимое масштабирование или действие по трафику; потребовать одобрения; затем проверить уровень ошибок и задержку. Та же схема подходит для истечения срока действия сертификата, перегрузки диска, неудачных задач или подозрительной активности учётных записей.
Тестируйте руководства с помощью модульных тестов, имитированных API, инцидентов в стенде, игровых дней и контролируемых учений в продакшне. Внедряйте устаревшие данные, отказ в разрешениях, медленные зависимости, дублирующие события и конфликтующие инциденты. Убедитесь, что повторные попытки безопасны и что реагирующие могут взять ручное управление, не сражаясь с автоматизацией.
Зрелость прогрессирует от уведомления к обогащению, к управляемым действиям, к ограниченному авто‑устранению. Продвижение должно зависеть от доказательств: стабильная диагностика, низкий уровень неудачных действий, проверенный откат и явная выгода для пользователя. Автономное закрытие должно быть редким, пока система не сможет доказать восстановление и сохранить достаточно доказательств для последующего обучения.
Практический пример: автоматизация инцидента в продакшн‑службе
Рассмотрим API платежей, у которого после развертывания растёт уровень ошибок. Мониторинг генерирует структурированное оповещение, содержащее сервис, окружение, регион, версию, бюджет ошибок и ссылку на руководство. Автоматизация обогащает его записью изменений, состоянием зависимостей, последними журналами и информацией о владельце, затем группирует дублирующие оповещения в один инцидент. Детерминированная политика может немедленно приостановить дальнейшее развертывание; откат должен требовать доказательств того, что новая версия является причиной и что откат безопасен.
Рабочий процесс назначает командира инцидента, открывает каналы коммуникации, фиксирует хронологию и предлагает диагностические шаги. Автоматизированное устранение начинается с низко‑рисковых обратимых действий, таких как переключение трафика на здоровый экземпляр. Каждое действие требует авторизации, ограничений конкуренции, тайм‑аута, проверенных постусловий и отката. Генеративные резюме могут помогать реагирующим, но исходные телеметрические данные и команды остаются видимыми, чтобы команда могла оспорить неверный вывод.
Измеряйте время обнаружения, подтверждения, смягчения и восстановления; объём оповещений; подавление дубликатов; успех устранения; повторяемость; и вред, вызванный автоматизацией. Проводите игровые дни для истёкших учётных данных, частичных регионов, вводящих в заблуждение оповещений и неудачных откатов. После восстановления сохраняйте фактическую хронологию, определяйте способствующие технические и организационные условия, обновляйте руководства и тесты, а также отслеживайте исправительные работы до завершения, а не рассматривайте быстрое смягчение как конец работы над надёжностью.
Практический чек‑лист внедрения
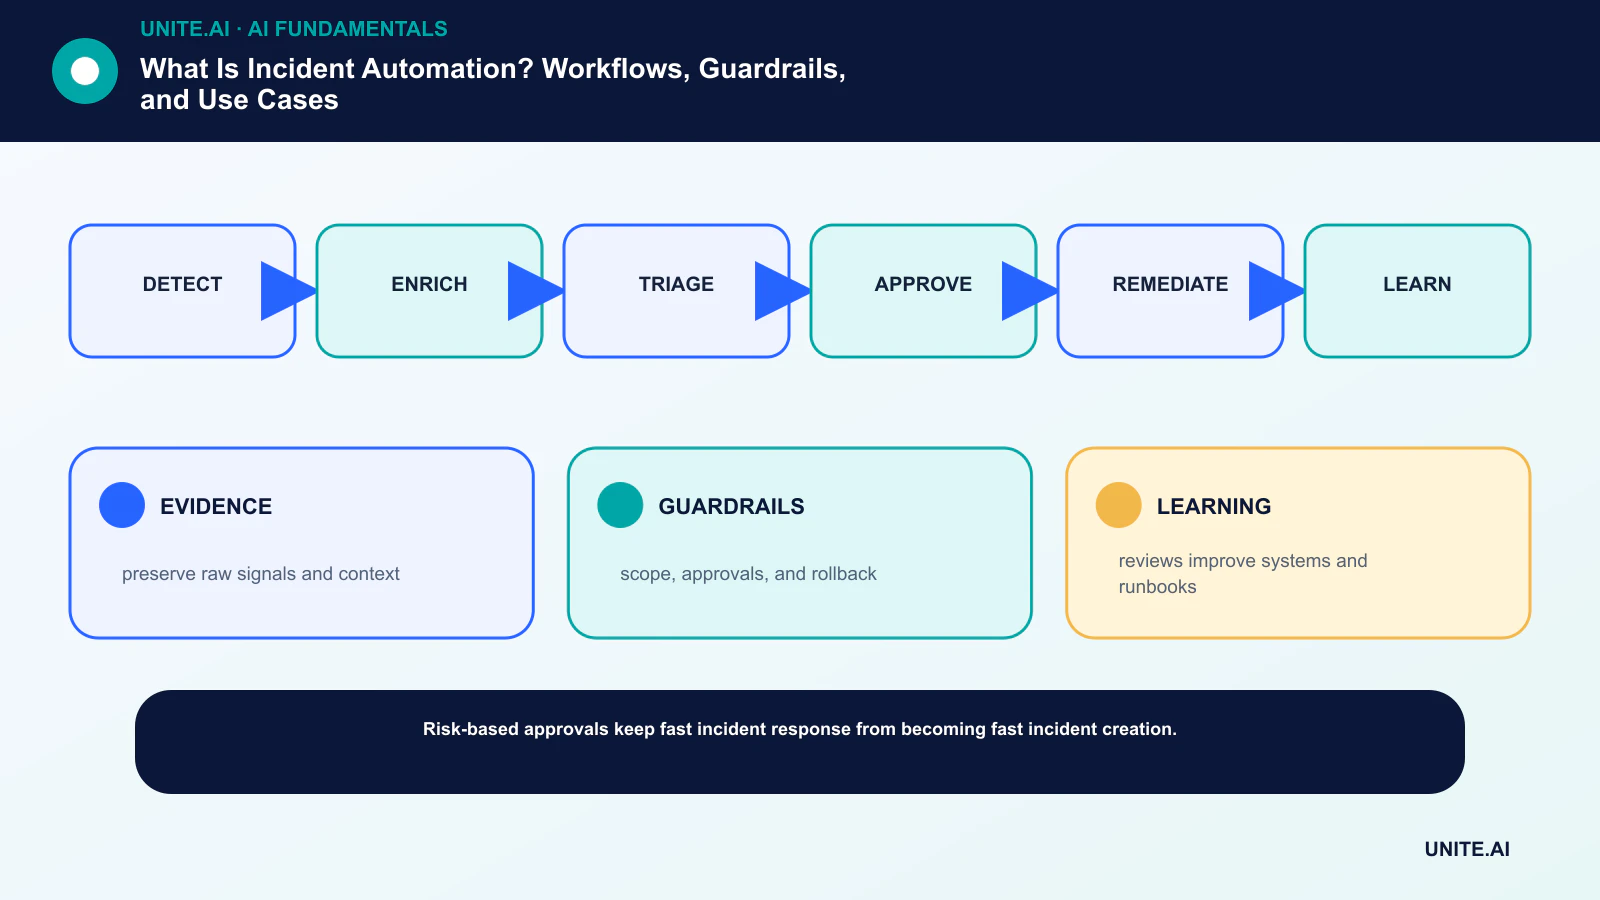
Преобразуйте концепцию в ограниченный, тестируемый рабочий процесс: обнаружить → обогатить → классифицировать → одобрить → устранить → обучить. Назначьте ответственного владельца, задокументируйте данные и зависимости, установите простую базовую линию, задайте критерии приёма и остановки, протестируйте типичные сбои и определите мониторинг, откат и обзор перед расширением области. Записывайте версии и предположения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают и затрагиваются системой. Тестируйте обычные сценарии, граничные условия, сбои зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять выпуск, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после получения реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- ДОКАЗАТЕЛЬСТВА: сохранять исходные сигналы и контекст.
- ОГРАНИЧЕНИЯ: область, одобрения и откат.
- ОБУЧЕНИЕ: обзоры улучшают системы и руководства.
Часто задаваемые вопросы
Является ли автоматизация инцидентов тем же, что AIOps?
Нет. AIOps применяет аналитику или машинное обучение к данным эксплуатации. Автоматизация инцидентов — более широкий слой выполнения и координации; она может использовать простые правила, выводы AIOps или и то, и другое.
Что следует автоматизировать в первую очередь?
Начните с часто повторяющихся, низко‑рисковых, хорошо понятных шагов, таких как обогащение, поиск владельца, сбор доказательств, обновления статуса и обратимая диагностика.
Основные ссылки











