
Основы ИИ
Что такое ИТ‑операции (ITOps)?

 Добавьте Unite.AI в избранные источники в Google
IT operations (ITOps) — это работа по поддержке технологических сервисов, от которых зависит организация. Она охватывает вычислительные ресурсы, сети, идентификацию, конечные устройства, облачные платформы, базы данных, хранилища, резервные копии и операционные процессы, обеспечивающие доступность, безопасность и поддерживаемость этих компонентов.
Современный ITOps не ограничивается центром сетевых операций, наблюдающим за панелями мониторинга. Команды всё чаще управляют программно‑определяемой инфраструктурой, сервисами платформ, автоматизацией и распределённой ответственностью, сохраняя при этом подотчётность за инциденты, ёмкость, непрерывность и уровни обслуживания.
Ключевые выводы
- ITOps управляет сервисами и их зависимостями в локальных, облачных и периферийных средах.
- Наблюдаемость, конфигурация и инвентарь предоставляют контекст, необходимый для интерпретации отказов.
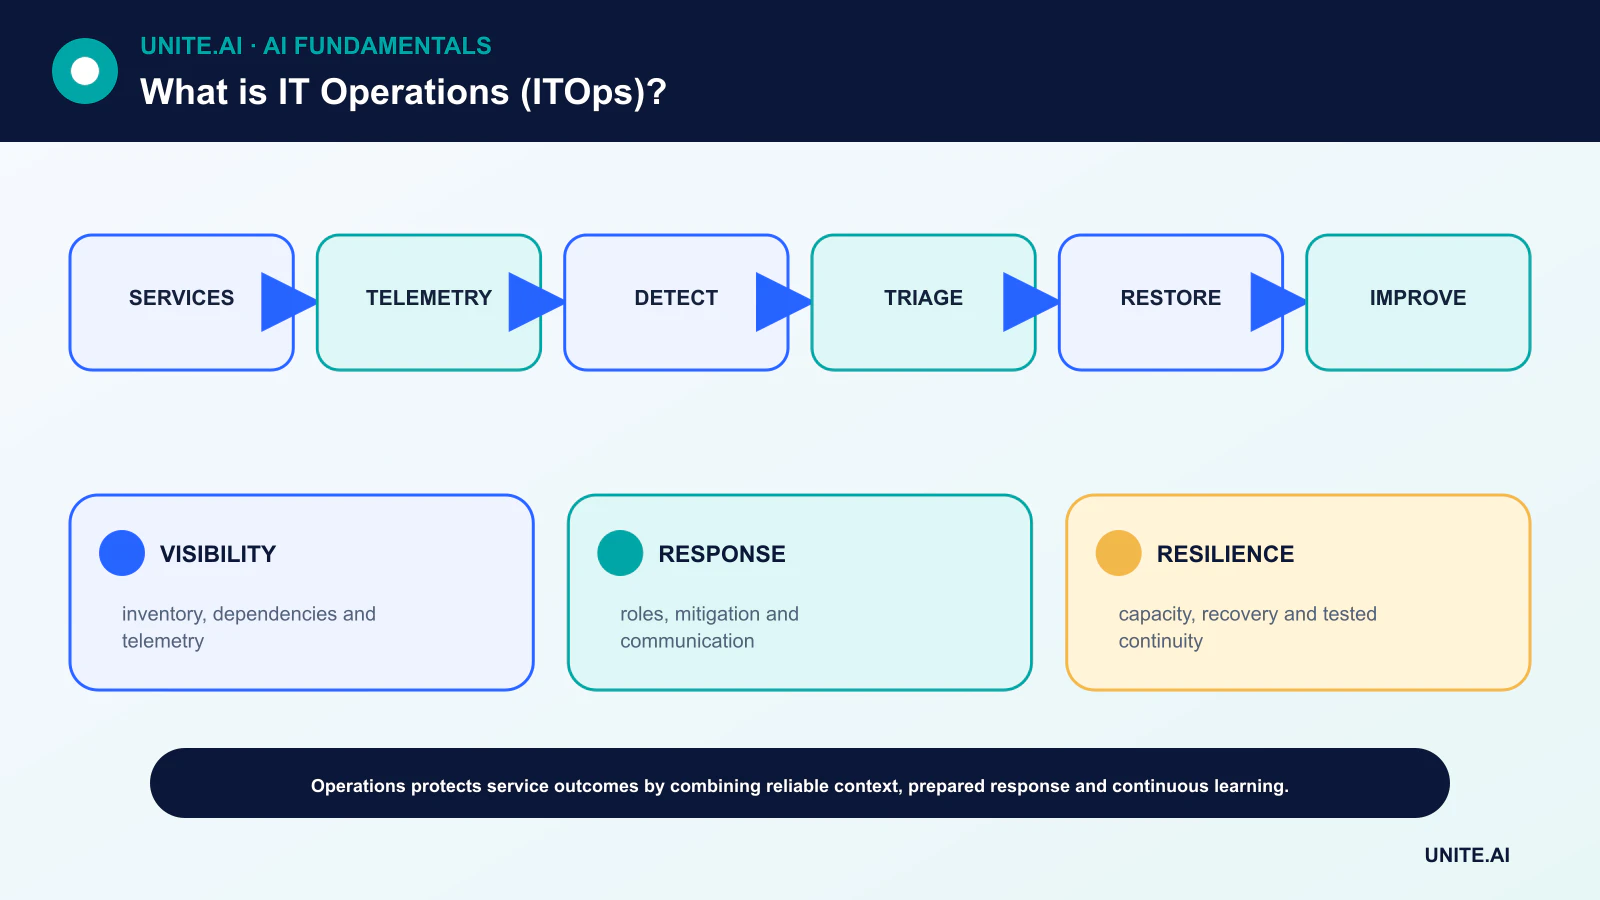
- Управление инцидентами восстанавливает сервис; управление проблемами решает повторяющиеся или системные причины.
- ITOps пересекается с ITSM, SRE, DevOps, SecOps и AIOps, но не идентичен ни одному из них.
Сервисы, активы и конфигурация
Эксплуатация начинается с понимания, какие сервисы существуют, кто их владеет, какие пользователи зависят от них и какая инфраструктура их поддерживает. Инвентарь активов фиксирует компоненты; управление конфигурацией фиксирует соответствующие взаимосвязи и контролируемое состояние.
Инвентарь, который никогда не сверяется, вводит в заблуждение. Автоматизируйте обнаружение там, где это полезно, определяйте авторитетные источники и фиксируйте степень уверенности или актуальности, вместо того чтобы притворяться, что карта всех зависимостей полна.
Наблюдаемость и цели сервиса
Метрики количественно описывают поведение, журналы фиксируют события, а трассировки отслеживают работу между сервисами. Синтетические проверки могут тестировать пользовательский путь. Полезная наблюдаемость начинается с вопросов и целей сервиса, после чего собирает необходимые сигналы для их ответа.
Оповещения должны выявлять условия, требующие своевременных действий. Пороговые значения без влияния на пользователя создают шум, а отсутствие контекста зависимостей замедляет диагностику. AIOps может помочь в корреляции, но требует надёжных телеметрических данных и обратной связи из эксплуатации.
Управление инцидентами, проблемами и изменениями
Управление инцидентами координирует обнаружение, сортировку, смягчение, коммуникацию и восстановление. Чёткие роли снижают путаницу в стрессовых ситуациях. Временное обходное решение может восстановить сервис, пока последующее расследование проблемы выявляет более глубокие причины.
Управление изменениями оценивает и фиксирует риски, не превращая каждое изменение в очередь. Стандартные, автоматизированные и низко‑рисковые изменения могут следовать предутверждённым путям; изменения с высоким воздействием требуют более убедительных доказательств, планирования и подготовки отката.
Ёмкость, устойчивость и непрерывность
Команды прогнозируют спрос на ресурсы, устраняют узкие места и тестируют поведение под нагрузкой. Резервные копии полезны только при проверке восстановления. Избыточность помогает лишь тогда, когда режимы отказа независимы и переключение действительно работает.
Бизнес‑непрерывность определяет приоритеты, время восстановления и допустимую потерю данных. Зависимости от идентификации, DNS, облачных управляющих плоскостей и поставщиков должны быть включены в учения, а не считаться доступными по умолчанию.
ITOps, ITSM, SRE и DevOps
Управление ИТ‑сервисами (ITSM) предоставляет процессы для согласования сервисов с потребностями организации. Инжиниринг надёжности сайта (SRE) применяет программную инженерию к эксплуатации и использует цели уровня сервиса и бюджеты ошибок. DevOps объединяет обратную связь разработки и эксплуатации.
SecOps сосредоточен на угрозах и реагировании, тогда как ITOps поддерживает более широкое состояние сервисов. Организационные схемы различаются; важным требованием является явное владение и совместные доказательства между этими дисциплинами.
Модель эксплуатации ITOps
Эксплуатация ИТ поддерживает технологические сервисы организации доступными, производительными, безопасными и восстанавливаемыми. Объём обычно включает конечные устройства, идентификацию, сети, серверы, облако, хранилища, инструменты совместной работы, базы данных, мониторинг, службу поддержки, резервные копии и сервисы поставщиков. Современный ITOps охватывает как собственную инфраструктуру, так и управляемые платформы, поэтому ответственность должна быть чёткой, даже если эксплуатация аутсорсится. Инвентарь конфигураций или сервисов связывает технические компоненты с владельцами, пользователями, зависимостями, классификацией данных и бизнес‑критичностью.
Управление сервисами организует инциденты, запросы, проблемы, изменения, активы, знания и уровни обслуживания. Управление инцидентами восстанавливает сервис; управление проблемами исследует повторяющиеся причины; внедрение изменений оценивает и координирует риски. Рассмотрение каждого изменения как медленного одобрения приводит к обходам, а неконтролируемая автоматизация создаёт неконтролируемые отказы. Стандартные низко‑рисковые изменения могут быть предварительно авторизованы и автоматизированы; изменения с высоким риском требуют доказательств, коммуникации, отката и планирования в зависимости от воздействия.
Надёжность, ёмкость и непрерывность
Мониторинг должен охватывать пользовательские сервисы и их зависимости, а не только количество устройств. Совместно с бизнес‑владельцами определяйте цели доступности, задержки, ёмкости, актуальности и поддержки. Оповещайте о симптомах, требующих действий, и о расходе бюджета ошибок; обогащайте события информацией о владельце и недавних изменениях. Модели планирования ёмкости учитывают спрос, насыщение, лицензии и время поставки. Эластичность облака уменьшает задержку в предоставлении ресурсов, но не устраняет квоты, региональные ограничения или контроль расходов.
Бизнес‑непрерывность требует проверенных резервных копий, восстановления, восстановления идентификации, альтернативных сетей, контактов с поставщиками и ручных процедур. Для каждого сервиса определяйте цели времени восстановления (RTO) и точки восстановления (RPO). Резервная копия не является доказательством восстановления, пока она не восстановлена и не проверена. Тренируйте сценарии вымогательского ПО, потери региона, истечения сертификатов, сбоев идентификации и отказов поставщиков. По возможности фиксируйте конфигурацию и инфраструктуру как код, чтобы восстановление было воспроизводимым.
Безопасность, автоматизация и метрики
Применяйте принцип наименьших привилегий, управление патчами и уязвимостями, контроль конечных устройств, сегментацию сети, журналирование и реагирование на инциденты. Автоматизируйте повторяющиеся задачи с идемпотентностью, ограничениями, одобрениями и аудитом. Измеряйте доступность сервисов, повторяемость инцидентов, выполнение запросов, неудачи изменений, восстановление, экспозицию патчей, ёмкость, стоимость и удовлетворённость пользователей — а не только закрытие тикетов. ITOps успешен, когда технологии предсказуемо поддерживают работу и способны восстанавливаться после отказов, а не когда инфраструктура выглядит занятаой или панели показывают лишь зелёные индикаторы.
Практический пример: восстановление сервиса совместной работы
Компания определяет цель времени восстановления в четыре часа и цель точки восстановления в один час для платформы совместной работы. Она фиксирует инвентарь идентификации, DNS, сети, данных, ключей, конфигураций, интеграций и зависимостей от поставщиков. В упражнении по восстановлению считается, что основной регион и учётная запись администратора недоступны. Операторы активируют независимо защищённую аварийную идентификацию, восстанавливают конфигурацию сервиса и данные в изолированном регионе и проверяют права доступа, сообщения, интеграции и клиентский доступ. Владельцы бизнеса проверяют восстановленный сервис с помощью реалистичных пользовательских сценариев, а не полагаются только на проверки состояния инфраструктуры.
Упражнение фиксирует фактическую потерю данных, затраченное время, ручные шаги, неудачные контакты и скрытые зависимости. Резервная копия, восстанавливающая файлы, но не ключи шифрования или политику идентификации, считается неполной. Корректирующие действия получают ответственных и сроки, а руководство (runbook) обновляется и повторно тестируется. Включаются шаблоны мониторинга и коммуникаций. Организация измеряет доказательства восстановления, а не лишь успешность задания резервного копирования, признавая, что надёжный ITOps должен восстанавливать сервис, необходимый пользователям, в реалистичных условиях отказа.
Доказательства реализации и готовность к эксплуатации
Решение о вводе в эксплуатацию требует большего, чем успешная демонстрация. Определите целевых пользователей, рабочую среду, входные и выходные данные, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базовую линию и версионированный набор оценок перед настройкой. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входные данные, смещение распределения, отказ зависимостей, неправильное использование и группы или среды, которые могут быть недостаточно обслужены. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Фиксируйте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственных за выпуск, исключения, изменения, откат и вывод из эксплуатации. Применяйте поэтапный развёртывание, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно введёнными сбоями. Операционная телеметрия должна показывать качество входных данных, поведение вывода, версию модели или правила, состояние зависимостей, вмешательство людей и подтверждённые результаты без сбора лишних конфиденциальных данных. Определите пороги оповещений и ответственного за реагирование, затем проверяйте реальные доказательства после развертывания, а не полагайтесь на сохранение офлайн‑производительности. Переоценивайте систему каждый раз, когда меняются источники данных, пользователи, модели, поставщики, политики, оборудование или цели. Поддерживаемая система также требует документированных процедур восстановления, обучения на инцидентах, удаления и хранения, а также чёткой точки, когда её следует отключить или заменить.
Часто задаваемые вопросы
Какова основная цель ITOps?
Обеспечить доставку и восстановление надёжных технологических сервисов в рамках согласованных ограничений по безопасности, производительности, непрерывности и стоимости.
Осуществляется ли управление облачной инфраструктурой полностью провайдером?
Нет. Провайдеры управляют частью базовой платформы, тогда как заказчики остаются ответственными за конфигурацию, идентификацию, данные, рабочие нагрузки, мониторинг и многие решения уровня сервиса.
Основные источники












