
Основы ИИ
Что такое управление эффективностью активов (APM)?

 Добавьте Unite.AI в избранные источники в Google
Управление эффективностью активов (APM) сочетает стратегию активов, обслуживание, мониторинг состояния, анализ надёжности и оперативные данные, чтобы повысить ценность, получаемую от физических активов. Оно обычно применяется к оборудованию, такому как турбины, насосы, транспортные средства, производственные линии и инфраструктура.
APM не является лишь панелью датчиков или моделью предиктивного обслуживания. Это процесс принятия решений, который уравновешивает эффективность, затраты, риск, безопасность и устойчивость на протяжении жизненного цикла актива, с чётким распределением ответственности за инспекции, работы, запчасти и капитальное планирование.
Ключевые выводы
- Начинайте с критичности и последствий отказов, а не с самого простого датчика для сбора.
- Сочетайте данные о состоянии с историей обслуживания, контекстом эксплуатации и инженерными знаниями.
- Используйте предиктивные сигналы для поддержки конкретного решения о работе и требования к времени выполнения.
- Измеряйте предотвращённый риск, доступность, качество обслуживания, стоимость жизненного цикла и ложные сигналы.
От стратегии актива к работе
Организации определяют цели, иерархию активов, критичность, стандарты производительности, режимы отказов и стратегии обслуживания. Система управления работами планирует инспекции и ремонты; аналитика APM помогает расставить приоритеты, когда и почему должна проводиться работа.
Одно и то же состояние может требовать разных действий для избыточного недорогого насоса и критически важной турбины. APM связывает технические доказательства с бизнес- и безопасностным контекстом, а не оптимизирует лишь один показатель предсказания.
Данные и цифровые представления
Полезные источники включают временные ряды датчиков, сигналы тревоги, обходы операторов, записи обслуживания, детали, условия окружающей среды, нагрузки и проектные ограничения. Идентификаторы активов и метки времени должны быть согласованы перед анализом. Отсутствующие, дрейфующие или заменённые датчики могут создавать ложные тенденции.
Цифровой двойник (digital twin) может сочетать инженерные модели и текущее состояние, но требует проверенных предположений и правил обновления. Неструктурированные (Unstructured) заметки техников могут добавить контекст, которого нет в телеметрии.
Состояние, предсказание и решение
Пороги обнаруживают известные ограничения; модели аномалий фиксируют отклонения; диагностические модели оценивают причины; прогностические модели оценивают оставшийся полезный срок службы. Каждая из них требует временного горизонта и уровня неопределённости, соответствующих решению по обслуживанию.
Модель, предсказывающая отказ за пять минут до его наступления, может быть точной, но практически бесполезной, если детали требуются неделя. Machine learning следует сравнивать с правилами и методами надёжности и тестировать в разных режимах эксплуатации.
Внедрение и измерения
Начните с критически важного класса активов, достоверного режима отказа, доступного времени на подготовку и ответственного, способного действовать. Интегрируйте рекомендации в планирование, рабочие задания и инвентарь; собирайте результаты, чтобы правило или модель можно было пересмотреть.
Отслеживайте доступность, незапланированные простои, стоимость обслуживания, соблюдение графика, ложные тревоги, пропущенные события, уровень риска для безопасности и стоимость жизненного цикла. Избегайте заявлений об избежанных отказах без контрфактического метода и документированных предположений.
Иерархия активов, поведение при отказе и критичность
Программа APM начинается с иерархии активов, связывающей площадки, системы, оборудование, сборки и обслуживаемые компоненты. Каждый уровень требует согласованных идентификаторов, ответственности, местоположения, спецификаций и взаимосвязей. Без этой основы потоки датчиков, рабочие задания, результаты инспекций и учёт затрат не могут надёжно описывать один и тот же физический актив.
Режимы отказов объясняют, как актив может перестать выполнять требуемую функцию, почему происходит отказ, какие доказательства появляются первыми и какие последствия следуют. Анализ видов и последствий отказов (FMEA), обслуживание, ориентированное на надёжность (RCM), и анализ первопричин превращают обслуживание из календарной задачи в дисциплину, основанную на риске. Анализ должен различать симптомы и причинные механизмы.
Критичность сочетает вероятность с последствиями для безопасности, окружающей среды, производства, качества, соответствия и стоимости. Избыточный насос, обслуживающий несущественный контур, не должен получать такой же бюджет мониторинга, как компрессор, являющийся единичной точкой отказа. Критичность меняется в зависимости от контекста эксплуатации, поэтому команды должны пересматривать ранжирование после изменений процессов, активов или спроса.
Мониторинг состояния, предсказание и решения по обслуживанию
Мониторинг состояния может использовать вибрацию, температуру, давление, ток, акустическое излучение, анализ смазки, визуальный осмотр и наблюдения операторов. Частота выборки должна соответствовать физике отказа. Высокочастотная вибрация подшипников и медленно дрейфующая коррозия требуют разных датчиков, хранения, признаков и логики оповещений. Калибровка и качество установки являются частью качества данных.
Прогностические модели могут обнаруживать аномалии, классифицировать известные неисправности, оценивать индикаторы состояния или предсказывать оставшийся полезный срок службы. Статистически необычный сигнал не является автоматически пригодным к действию отказом. Моделям необходим контекст состояния эксплуатации, уровень неопределённости, оценка времени подготовки и проверка на разных типах оборудования, сезонах, нагрузках и событиях обслуживания. Ложные тревоги подрывают доверие и требуют трудозатрат; пропущенные обнаружения могут привести к серьёзным потерям.
Вывод аналитики должен связываться с решением: инспектировать, смазывать, понижать нагрузку, планировать работу, заказывать деталь или останавливать оборудование. Пороги решений должны отражать последствия отказа, время подготовки вмешательства, мощность персонала, запасы и окна производства. Экономически оптимальный порог редко совпадает с порогом, максимизирующим общую метрику модели.
Интеграция APM, измерение ценности и управление
APM связывает технологию эксплуатации с корпоративными системами, такими как система компьютерного управления обслуживанием (CMMS), управление активами предприятия (EAM), исторические базы данных, инвентарь и планирование. Интеграция должна сохранять метки времени, единицы измерения, идентичность активов, статус работ и происхождение данных. Сегментация сети и контролируемые шлюзы необходимы, поскольку удобство диагностики не должно открывать путь в системы управления, критичные для безопасности.
Оцените ценность через избежанные простои, сокращение экстренных работ, стоимость обслуживания, доступность запасных частей, энергоэффективность, выход продукции, уровень риска для безопасности и срок службы актива. Избежанные отказы являются контрфактическими, поэтому используйте достоверные базовые линии, сопоставимые активы, документированные предположения и диапазоны чувствительности. Пилотный проект, выявляющий множество аномалий, но не меняющий решения по обслуживанию, не продемонстрировал бизнес-ценность.
Управление назначает ответственных за датчики, модели, правила тревог, библиотеки отказов и рабочие процессы. После каждого вмешательства проверяйте тревоги, фиксируйте, был ли диагноз верным, и передавайте подтверждённые результаты обратно в правила и модели. Операторы и обслуживающий персонал нуждаются в возможности оспаривать рекомендации; местные знания являются доказательством, а не сопротивлением автоматизации.
Практический пример: защита критически важного вращающегося актива
Для производственного компрессора команда картирует компоненты и режимы отказов, ранжирует последствия потери продукции и безопасности, а также связывает теги историка, вибрационные датчики, образцы смазки, инспекции и рабочие задания с единой идентификацией актива. Базовые данные должны охватывать запуск, стабильную нагрузку, снижение и сезонные условия. В противном случае модель может отмечать нормальные переходы в работе как неисправности или пропускать деградацию, видимую только при определённой нагрузке.
Аналитический слой обнаруживает изменения в спектре вибраций и температуре подшипника, оценивает неопределённость и отображает доказательства рядом с сопоставимыми историческими событиями. Постоянная тревога создаёт запрос на инспекцию, а не приводит к автоматическому отключению. Обслуживающий персонал фиксирует результаты, действия, заменённую деталь и подтверждённую причину. Эти результаты определяют, следует ли менять порог, модель отказа или установку датчика.
Оцените время предупреждения, подтверждённый уровень обнаружения, нагрузку от ложных тревог, избежанные простои, экстренные работы, готовность запасных частей и стоимость обслуживания относительно документированной базовой линии. Учтите стоимость датчиков, интеграции, анализа и изменённых рабочих процессов. Проверка кибербезопасности изолирует мониторинг от систем управления, а управление назначает ответственных за данные и модели. Цель — более безопасное экономическое решение по обслуживанию, а не максимальное количество телеметрии активов.
Практический чек‑лист внедрения
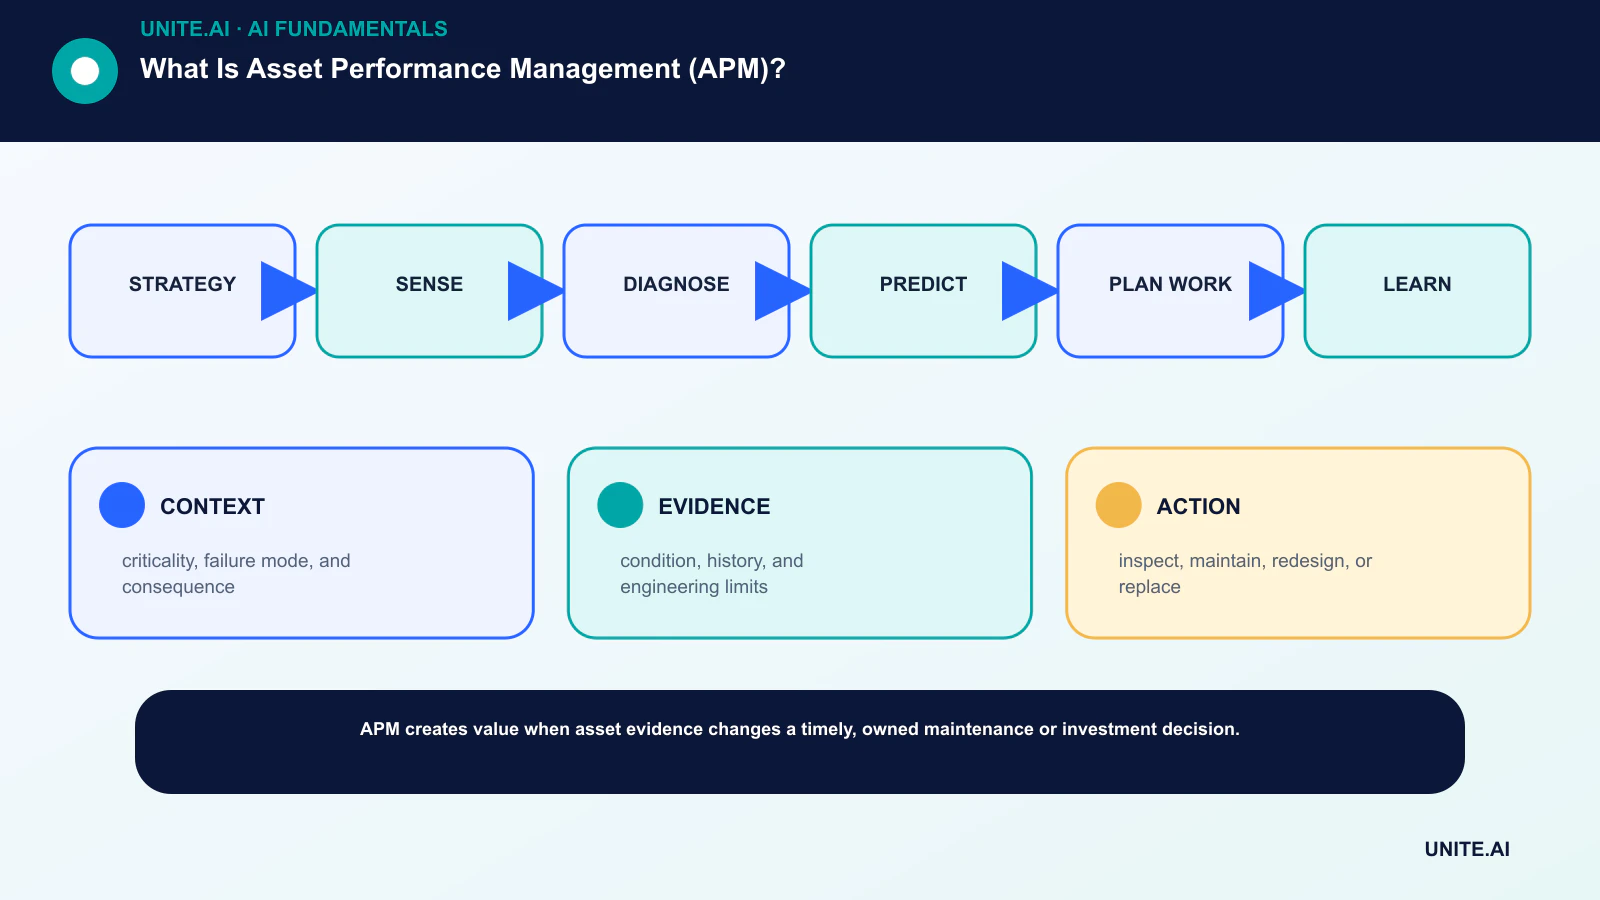
Преобразуйте концепцию в ограниченный, проверяемый рабочий процесс: стратегия → измерение → диагностика → предсказание → планирование работ → обучение. Назначьте ответственного, задокументируйте данные и зависимости, установите простую базовую линию, определите критерии принятия и прекращения, протестируйте репрезентативные отказы и определите мониторинг, откат и проверку перед расширением охвата. Записывайте версии и предположения, чтобы другая команда могла воспроизвести результат и понять, что изменилось.
Перед запуском проведите документированный обзор готовности с людьми, которые разрабатывают, эксплуатируют, защищают систему и на которых она влияет. Тестируйте обычные случаи, граничные условия, отказы зависимостей и неправильное использование; сохраняйте доказательства и нерешённые риски. Определите, кто может одобрять выпуск, менять порог, переопределять вывод или останавливать работу. Пересмотрите решение после поступления реальных данных, поскольку технически успешный пилот не гарантирует надёжную работу в более широком масштабе.
- КОНТЕКСТ: критичность, режим отказа и последствия.
- ДОКАЗАТЕЛЬСТВА: состояние, история и инженерные ограничения.
- ДЕЙСТВИЕ: инспектировать, обслуживать, переосмысливать или заменять.
Часто задаваемые вопросы
Чем APM отличается от CMMS?
CMMS в первую очередь управляет работами по обслуживанию, расписаниями и записями. APM добавляет стратегию активов, анализ надёжности и состояния, приоритизацию и решения по эффективности; системы часто интегрируются.
Требуется ли предиктивное обслуживание для APM?
Нет. Профилактические, основанные на состоянии, стратегии «работай до отказа», переосмысления и замены могут быть уместны. Предсказание — лишь один из инструментов в стратегии активов.
Основные ссылки












