
Основы ИИ
Что такое федеративное обучение?

 Добавьте Unite.AI в избранные источники в Google
Федеративное обучение обучает общую модель на множестве устройств или организаций, при этом оставляя исходные обучающие данные каждого участника локальными. Координатор распределяет параметры модели, клиенты вычисляют обновления на своих записях, а шаг агрегации объединяет эти обновления.
Хранение записей локально полезно, но это не то же самое, что конфиденциальность или безопасность. Обновления модели могут раскрывать информацию, скомпрометированные клиенты могут отравлять обучение, и координатор всё равно нуждается в аутентификации, защите транспортного канала, контроле доступа и определённой модели доверия.
Ключевые выводы
- Федеративное обучение переносит вычисления к распределённым данным; оно не перемещает исходный набор данных к единому центральному обучающему.
- Системы кросс‑устройства включают множество прерывисто доступных устройств, а кросс‑силосные системы включают меньше, но более стабильных организаций.
- Защищённая агрегация и дифференциальная конфиденциальность решают разные риски и могут комбинироваться.
- Неправильные (не IID) данные, ограниченная пропускная способность, ненадёжное участие и злонамеренные обновления являются ключевыми ограничениями дизайна.
Жизненный цикл федеративного усреднения
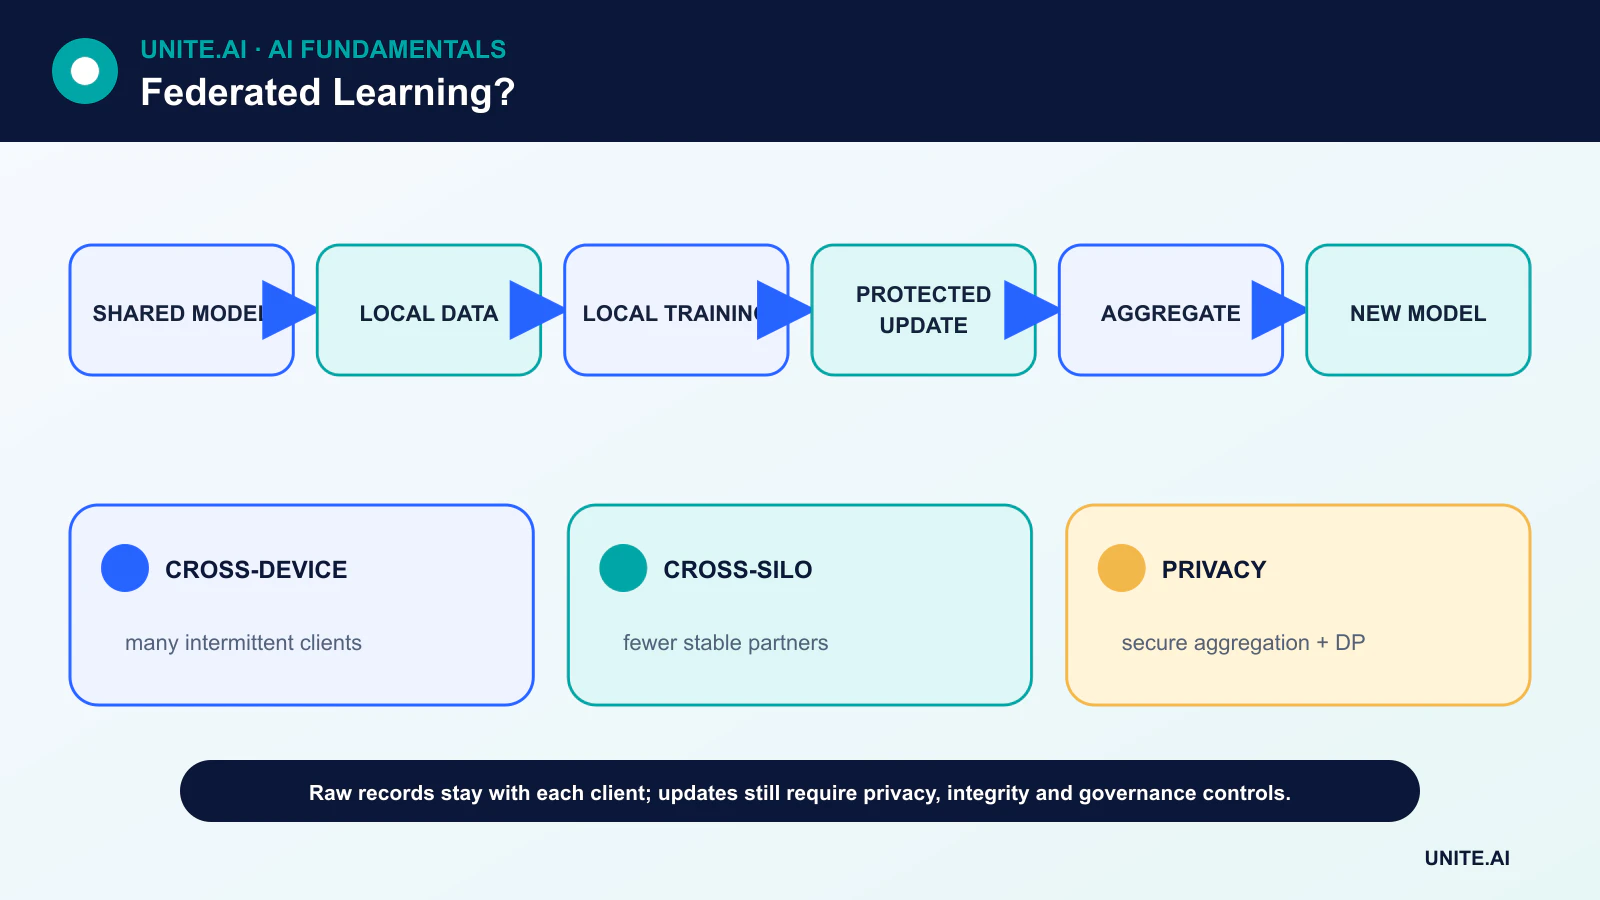
Типичный раунд начинается с того, что координатор выбирает подходящих клиентов и отправляет им текущую модель. Каждый клиент обучается локально в течение ограниченного количества шагов, создавая обновление параметров или градиентов. Координатор агрегирует подходящие обновления — часто с весами, основанными на локальном количестве примеров, — и публикует новую общую модель.
Только часть клиентов может участвовать в каждом раунде. Протокол должен выдерживать обрывы соединений, несоответствия версий и устройства, которые не могут обучаться, пока находятся в режиме зарядки, заняты или находятся в офлайн‑режиме. Связь может доминировать над вычислениями, поэтому сжатие обновлений и уменьшение количества раундов часто важнее, чем чистая скорость ускорителей.
Кросс‑устройства против кросс‑силосов
Федеративное обучение кросс‑устройства может включать телефоны, датчики или браузеры, принадлежащие множеству отдельных пользователей. Клиенты многочисленны, слабо доверены и доступны лишь периодически. Федеративное обучение кросс‑силос обычно соединяет небольшое количество больниц, банков или бизнес‑подразделений со стабильной инфраструктурой и договорными механизмами управления.
Эти два сценария требуют разных предположений о идентификации, аудите и отказах. Проект кросс‑силос может согласовать общую схему и процесс валидации; сервис кросс‑устройства может столкнуться с миллионами версий программного обеспечения и сильно неоднородными локальными наборами данных.
Защищённая агрегация, дифференциальная конфиденциальность и шифрование
Защищённая агрегация — это криптографический протокол, позволяющий серверу восстановить агрегат без чтения обновлений каждого клиента. Дифференциальная конфиденциальность ограничивает степень зависимости опубликованного результата от любой отдельной записи или участника, обрезая вклады и добавляя откалиброванный шум.
Ни один из механизмов не устраняет все риски. Защищённая агрегация не делает агрегат безвредным, а дифференциальная конфиденциальность вводит компромисс между точностью и конфиденциальностью, который необходимо учитывать с помощью явного бюджета конфиденциальности. Шифрование защищает данные в транзите или хранении; оно само по себе не препятствует выводу информации из модели.
Данные, не являющиеся IID, и качество модели
Данные клиентов редко являются независимыми и одинаково распределёнными. Модель клавиатуры видит словарный запас каждого человека; больницы обслуживают разные популяции; заводы используют различное оборудование. Эти различия могут замедлять сходимость и скрывать плохую производительность для небольших групп клиентов.
Оценка должна включать глобальные метрики, распределения по клиентам или когортам, калибровку и анализ сбоев. Центральный тестовый набор может быть удобен, но недостаточен. Это связывает федеративное обучение с машинным обучением и управлением структурированными и неструктурированными данными.
Угрозы и оперативные меры контроля
Злонамеренные клиенты могут отправлять отравленные обновления, сибил‑клиенты могут искажать агрегацию, а скомпрометированный сервер может распространять целевую модель. Защита включает аутентифицированную регистрацию, обнаружение аномалий, устойчивую агрегацию, валидацию обновлений, ограничения скорости и воспроизводимую аттестацию программного обеспечения, где это практично.
Федеративное обучение является частью более широкой программы кибербезопасности. Команды должны документировать, кто контролирует координатор, какие метаданные собираются, как участники могут выйти, как откатываются модели и что происходит, когда тесты конфиденциальности или качества не проходят.
Федеративная оптимизация и гетерогенность данных
Федеративное обучение отправляет модель или задачу обновления участвующим клиентам, обучает их локально и агрегирует обновления без централизации исходных примеров. В федеративном усреднении выбранные клиенты выполняют несколько локальных шагов оптимизации, а сервер вычисляет взвешенное среднее, обычно по количеству примеров. Количество коммуникационных раундов, локальные эпохи, отбор и скорости обучения балансируют пропускную способность и сходимость. Кросс‑устройства подразумевают множество ненадёжных телефонов или датчиков; кросс‑силосы — меньше организаций с более мощными вычислениями, идентификацией и управлением.
Данные клиентов обычно не являются независимыми и неоднородными: пользователи различаются по поведению, распределению меток, объёму и доступности. Локальное обучение может дрейфовать в несовместимых направлениях, делая простое среднее нестабильным или смещённым в пользу активных клиентов с высоким объёмом. Алгоритмы могут использовать проксимальные члены, адаптивную серверную оптимизацию, кластеризацию, персонализацию или контрольные вариации. Оценка должна включать глобальную и клиентскую производительность, «хвостовые» клиенты, частоту участия, сходимость, коммуникацию и энергопотребление. Хорошее среднее может скрывать, что небольшие или редкие группы клиентов получают менее качественную модель.
Конфиденциальность, безопасность и системная инженерия
Хранение данных локально само по себе не гарантирует конфиденциальность. Градиенты и обновления могут раскрывать принадлежность к набору или отдельные признаки, а окончательная модель может запоминать примеры. Защищённая агрегация скрывает отдельные обновления от сервера, а дифференциальная конфиденциальность ограничивает информационный вклад путём обрезки и добавления шума, но обе техники снижают полезность и усложняют эксплуатацию. Необходимо определить модель угроз, единицу конфиденциальности, бюджет и доверенные компоненты. Шифрование в транзите необходимо, но не предотвращает злонамеренного клиента, отравленное обновление, скомпрометированный координатор или атаку вывода.
Защита включает аутентифицированных клиентов, устойчивую агрегацию, проверки аномалий, ограничения обновлений, защищённые анклавы в некоторых проектах и валидацию на чистых данных. Сибил‑атаки могут создавать множество клиентов; «задние двери» могут выживать после усреднения; отбрасывание подозрительных обновлений может также исключать легитимное редкое поведение. Версионируйте клиентский код, поддерживайте прерванные раунды, предотвращайте повторные воспроизведения и проектируйте систему для отстающих и ограниченных устройств. Согласие, хранение, региональные правила и удаление всё равно применимы к локальным данным и полученным обновлениям.
Пример развертывания и управления
Мобильная клавиатура может обучать улучшения предсказания следующего слова локально, но развертывание должно использовать популяцию, отобранную по возможностям устройства и согласию, собирать обрезанные защищённые обновления и сравнивать их с замороженным базовым вариантом. Необходимо проверять языковую и диалектную производительность, влияние на батарею, использование данных и риск запоминания перед выпуском. Клиенты нуждаются в подписанных задачах обучения и обновлениях модели; серверу требуются аудируемые конфигурации раундов и возможность отката. Федеративное обучение — это архитектура распределённого обучения при ограничениях, а не замена репрезентативных данных, инженерии конфиденциальности или ответственности.
Практический пример: федеративное обучение в больницах
Больницы обучают общую модель качества изображений без объединения сканов. Общий протокол определяет метаданные устройств, метки, предобработку, критерии отбора клиентов, локальные эпохи, обрезку и защищённую агрегацию. Учреждения сохраняют данные пациентов и отправляют защищённые обновления, в то время как координатор оценивает каждый раунд на локальных отложенных наборах. Результаты сообщают о производительности на уровне учреждений и «хвостовых» клиентов, а не только о средневзвешенном объёме, поскольку небольшие больницы и типы устройств иначе могут быть проигнорированы.
Модель угроз охватывает злонамеренные обновления, утечку членства, скомпрометированных клиентов и доступ координатора. Дифференциальная конфиденциальность настраивается с документированным бюджетом и проверяется на полезность. Пакеты модели и задачи подписаны; учреждения могут отозвать участие, а обновления подлежат аудиту. Отравленный или нестабильный раунд не заменяет развернутую модель автоматически. Проект сохраняет локальные базовые линии и клиническую экспертизу, рассматривая федеративную архитектуру как один из элементов контроля конфиденциальности в рамках более широких обязательств по согласию, безопасности и управлению.
Доказательства внедрения и готовность к эксплуатации
Производственное решение требует большего, чем успешная демонстрация. Необходимо определить целевых пользователей, рабочую среду, входы, выходы, зависимости, владельца и последствия каждого важного сбоя. Установите воспроизводимую базу и версионированный набор оценок до настройки. Тестируйте обычные случаи, граничные условия, некорректные или отсутствующие входы, сдвиги распределения, отказ зависимостей, неправильное использование и группы или среды, которые наиболее вероятно останутся без обслуживания. Измеряйте качество задачи вместе с калибровкой или неопределённостью, задержкой, пропускной способностью, стоимостью ресурсов, доступностью, конфиденциальностью и безопасностью. Записывайте каждое преобразование и порог, чтобы независимый рецензент мог воспроизвести результат и отличить доказательства от привлекательного прототипа.
Перед запуском назначьте ответственного за выпуск, исключения, изменения, откат и вывод из эксплуатации. Используйте поэтапный выпуск, сохраняйте безопасный откат и проверяйте мониторинг с преднамеренно внедрёнными сбоями. Оперативная телеметрия должна показывать качество входов, поведение выходов, версию модели или правила, состояние зависимостей, человеческие вмешательства и подтверждённые результаты без сбора ненужных чувствительных данных. Определите пороги оповещений и ответственного за реакцию, затем после развертывания проверяйте реальные доказательства, а не полагайтесь на офлайн‑производительность. Переоценивайте каждый раз, когда меняются источники данных, пользователи, модели, поставщики, политики, оборудование или цели. Поддерживаемая система также нуждается в документированных процедурах восстановления, обучения на инцидентах, удаления и хранения, а также в чёткой точке, в которой её следует отключить или заменить.
Часто задаваемые вопросы
Гарантирует ли федеративное обучение, что частные данные не могут утечь?
Нет. Оно уменьшает перемещение сырых данных, но обновления и конечные модели всё равно могут раскрывать информацию. Конфиденциальность требует модели угроз и дополнительных технических и организационных мер.
Когда централизованное обучение проще?
Когда данные могут быть законно и безопасно централизованы, централизованное обучение часто легче отлаживать, воспроизводить и контролировать. Федеративное обучение оправдано, когда распределённость является реальным требованием, а не просто маркетинговой целью.
Основные ссылки












