
Kąt Andersona
Znaczący postęp w ludzkim sterowaniu AI wideo

 Dodaj Unite.AI do preferowanych źródeł w Google
Uwaga: Strona projektu zawiera 33 autoplaying filmy o wysokiej rozdzielczości, które łącznie mają rozmiar pół gigabajta, co destabilizowało mój system podczas ładowania. Z tego powodu nie będę bezpośrednio linkować do niej. Czytelnicy mogą znaleźć adres URL w abstrakcie lub PDF artykułu, jeśli zdecydują się na to.
Jednym z głównych celów badań nad syntezą wideo jest generowanie pełnego występu AI z jednego obrazu. W tym tygodniu nowy artykuł opublikowany przez Bytedance Intelligent Creation przedstawił, co może być najbardziej kompleksowym systemem tego rodzaju, w stanie produkować pełne i pół-ciało animacje, które łączą wyraziste szczegóły twarzy z dokładnymi dużymi ruchami, a także osiągają poprawioną spójność tożsamości – obszar, w którym nawet wiodące systemy komercyjne często zawodzą.
W poniższym przykładzie widzimy występ sterowany przez aktora (góra lewa) i pochodzący z jednego obrazu (góra prawa), który zapewnia niezwykle elastyczną i zwinną renderowaną, bez typowych problemów związanych z tworzeniem dużych ruchów lub “przewidywaniem” ukrytych obszarów (tj. części ubrania i kątów twarzy, które muszą być wywnioskowane lub wymyślone, ponieważ nie są widoczne na jedynym zdjęciu źródłowym):
ZAWARTOŚĆ DŹWIĘKOWA. Kliknij, aby odtworzyć. Występ powstaje z dwóch źródeł, w tym z synchronizacją ust, która zwykle jest zastrzeżona dla dedykowanych systemów pomocniczych. Jest to wersja zmniejszona z witryny źródłowej (patrz uwaga na początku artykułu – dotyczy wszystkich innych osadzonych filmów tutaj).
Mimo że widzimy pewne pozostałe wyzwania dotyczące trwałości tożsamości w każdym klipie, jest to pierwszy system, który widziałem, który ogólnie (choć nie zawsze) utrzymuje tożsamość przez dłuższy czas bez użycia LoRAs:
ZAWARTOŚĆ DŹWIĘKOWA. Kliknij, aby odtworzyć. Kolejne przykłady z projektu DreamActor.
Nowy system, zatytułowany DreamActor, wykorzystuje trójczęściowy hybrydowy system sterowania, który poświęca specjalną uwagę wyrazom twarzy, rotacji głowy i projektowi szkieletu, umożliwiając występy sterowane przez AI, w których ani twarz, ani ciało nie cierpią na rzecz drugiego – rzadka, a być może nieznana zdolność wśród podobnych systemów.
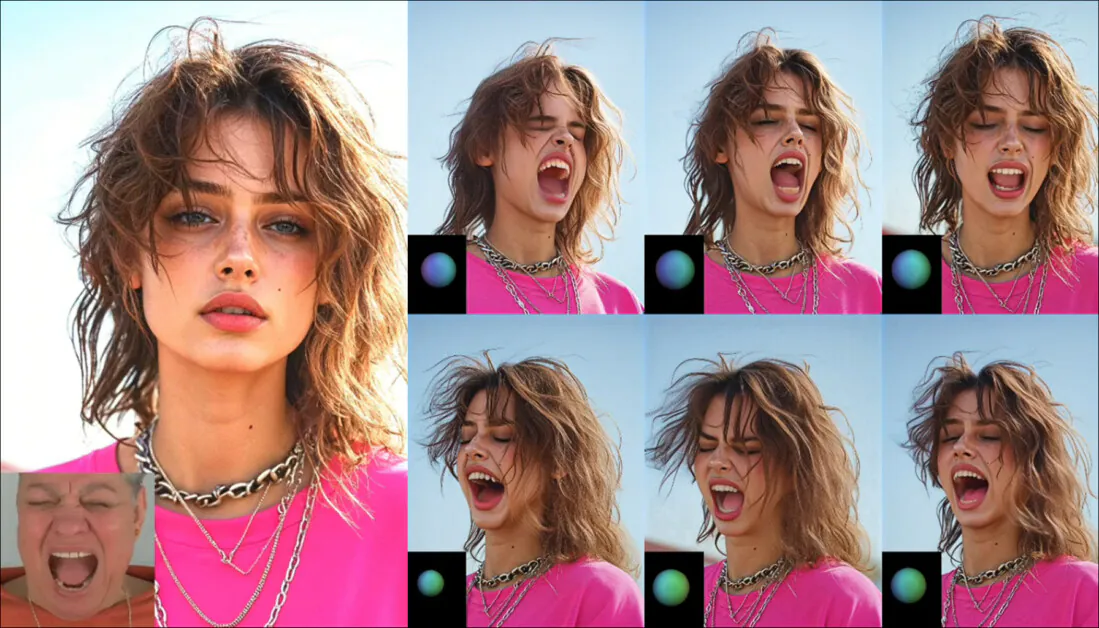
Poniżej widzimy jedną z tych cech, rotację głowy, w działaniu. Kolorowa kula w rogu każdej miniatury po prawej stronie wskazuje rodzaj wirtualnego gimbalu, który definiuje orientację głowy niezależnie od ruchu twarzy i wyrazu, który jest tutaj sterowany przez aktora (dolna lewa).
Kliknij, aby odtworzyć. Wizualizacja osi obrotu głowy awatara, podczas gdy wyraz jest zasilany przez oddzielny moduł i poinformowany o występie aktora (widoczny tutaj dolna lewa).
Jedną z najbardziej interesujących funkcjonalności projektu, która nie jest nawet właściwie uwzględniona w testach artykułu, jest jego zdolność do pochodzenia ruchu synchronizacji ust bezpośrednio z dźwięku – funkcjonalność, która działa niezwykle dobrze, nawet bez sterującego aktora-wideo.
Badacze podjęli wyzwanie wobec najlepszych systemów w tym zakresie, w tym bardzo chwalonego Runway Act-One i LivePortrait, i donoszą, że DreamActor był w stanie osiągnąć lepsze wyniki ilościowe.
Ponieważ badacze mogą ustalić własne kryteria, wyniki ilościowe nie są koniecznie empirycznym standardem; ale towarzyszące testy jakościowe wydają się potwierdzać wnioski autorów.
Niestety, ten system nie jest przeznaczony do wydania publicznego, a jedyną wartością, jaką społeczność może potencjalnie uzyskać z tego projektu, jest ewentualne odtworzenie metodologii opisanej w artykule (jak to zrobiono z równie zamkniętym Google Dreambooth w 2022 roku ).
Artykuł stwierdza*:
‘Animacja obrazu ludzkiego ma możliwe ryzyko społeczne, takie jak nadużywanie do tworzenia fałszywych filmów. Proponowana technologia mogłaby być wykorzystana do tworzenia fałszywych filmów z ludźmi, ale istniejące narzędzia wykrywania [Demamba, Dormant] mogą wykryć te fałszywe filmy.
‘Aby zmniejszyć te ryzyka, konieczne są wyraźne zasady etyczne i odpowiednie wytyczne dotyczące użytkowania. Będziemy ściśle ograniczać dostęp do naszych podstawowych modeli i kodów, aby zapobiec nadużyciom.’
Oczywiście, rozważania etyczne tego rodzaju są wygodne z punktu widzenia komercyjnego, ponieważ zapewniają uzasadnienie dla dostępu do modelu tylko przez API, który może być następnie komercjalizowany. ByteDance już raz zrobił to w 2025 roku, udostępniając bardzo chwalonego OmniHuman do dostępu za punkty na stronie Dreamina. Zatem, ponieważ DreamActor jest prawdopodobnie jeszcze silniejszym produktem, wydaje się to najbardziej prawdopodobny wynik. Co pozostaje do zobaczenia, to stopień, w jakim jego zasady, o ile są wyjaśnione w artykule, mogą pomóc społeczności open source.
Nowy artykuł pt. DreamActor-M1: Holistyczna, wyrazista i niezawodna animacja obrazu ludzkiego z hybrydowym sterowaniem, pochodzi od sześciu badaczy Bytedance.
Metoda
System DreamActor proponowany w artykule ma na celu wygenerowanie animacji ludzkiej z obrazu odniesienia i filmu sterującego, przy użyciu Diffusion Transformer (DiT) ramy dostosowanej do przestrzeni latentnej (wydaje się, że jest to jakiś rodzaj Stable Diffusion, chociaż artykuł cytuję tylko publikację z 2022 roku).
Zamiast polegać na zewnętrznych modułach do obsługi warunków odniesienia, autorzy łączą cechy wyglądu i ruchu bezpośrednio wewnątrz DiT, umożliwiając interakcję w przestrzeni i czasie za pomocą uwagi:

Schemat nowego systemu: DreamActor koduje pozę, ruch twarzy i wygląd w oddzielne latenty, łącząc je z hałasowanymi latencjami wideo wyprodukowanymi przez 3D VAE. Sygnały te są łączone wewnątrz Diffusion Transformer przy użyciu self- i cross-uwagi, z współdzielonymi wagami na gałęziach. Model jest nadzorowany przez porównywanie oczyszczonych danych wyjściowych z czystymi latencjami wideo. Źródło: https://arxiv.org/pdf/2504.01724
Aby to zrobić, model wykorzystuje wstępnie wytrenowany 3D variational autoencoder do zakodowania zarówno wejściowego filmu, jak i obrazu odniesienia. Te latenty są patchyfikowane, łączone i wprowadzane do DiT, który je przetwarza wspólnie.
Architektura ta odbiega od powszechnego praktyki dołączania sieci wtórnej do wstrzyknięcia odniesienia, co było podejściem dla wpływowego Animate Anyone i Animate Anyone 2 projektów.
Zamiast tego, DreamActor buduje fuzję w samym modelu, upraszczając projekt i poprawiając przepływ informacji między wskazówkami wyglądu i ruchu. Model jest następnie szkolony przy użyciu dopasowania przepływu zamiast standardowego celu dyfuzji (dopasowanie przepływu szkoli modele dyfuzji, bezpośrednio przewidując pola prędkości między danymi a hałasem, pomijając szacowanie wyniku).
Hybrydowe sterowanie ruchem
Metoda hybrydowego sterowania ruchem, która informuje renderowania neuronalne, łączy tokeny pozy z pochodzącymi z 3D szkieletów ciała i sfery głowy; jawne reprezentacje twarzy wyprowadzane przez wstępnie wytrenowany kodujący twarz; i tokeny wyglądu odniesienia pobrane z obrazu źródłowego.
Elementy te są zintegrowane wewnątrz Diffusion Transformer przy użyciu odrębnych mechanizmów uwagi, umożliwiając systemowi koordynowanie globalnego ruchu, wyrazu twarzy i tożsamości wizualnej w całym procesie generacji.
Dla pierwszego z nich, zamiast polegać na punktach orientacji twarzy, DreamActor wykorzystuje jawne reprezentacje twarzy do sterowania generacją wyrazu, co wydaje się umożliwiać bardziej precyzyjną kontrolę nad dynamiką twarzy, a także rozłącza tożsamość i pozę głowy od wyrazu.
Aby utworzyć te reprezentacje, potok najpierw wykrywa i obcina region twarzy w każdym klatce filmu sterującego, zmniejszając go do 224×224. Obcięte twarze są przetwarzane przez kodujący ruch twarzy wstępnie wytrenowany na PD-FGC, a następnie warunkowany przez warstwę MLP.

PD-FGC, zastosowany w DreamActor, generuje głowę mówcę z obrazu odniesienia z rozłącznym sterowaniem synchronizacji ust (z dźwięku), pozie głowy, ruchem oka i wyrazem (z oddzielnych filmów), umożliwiając precyzyjną, niezależną manipulację każdym. Źródło: https://arxiv.org/pdf/2211.14506
Wynikiem jest sekwencja tokenów ruchu twarzy, które są wstrzykiwane do Diffusion Transformer przez warstwę cross-uwagi.
Ten sam framework obsługuje również wariant sterowany dźwiękiem, w którym oddzielny kodujący jest szkolony, który mapuje dane wejściowe dźwięku bezpośrednio na tokeny ruchu twarzy. To umożliwia generowanie zsynchronizowanej animacji twarzy – w tym ruchów ust – bez filmu sterującego.
ZAWARTOŚĆ DŹWIĘKOWA. Kliknij, aby odtworzyć. Synchronizacja ust pochodząca wyłącznie z dźwięku, bez filmu sterującego. Jedynym wejściem postaci jest statyczne zdjęcie widoczne w prawym górnym rogu.
Drugie, aby kontrolować pozę głowy niezależnie od wyrazu twarzy, system wprowadza reprezentację sfery głowy (patrz film osadzony wcześniej w tym artykule), która rozłącza dynamikę twarzy od globalnego ruchu głowy, poprawiając precyzyjność i elastyczność podczas animacji.
Sfery głowy są generowane przez wyprowadzenie parametrów 3D twarzy – takich jak rotacja i położenie kamery – z filmu sterującego przy użyciu metody FaceVerse.

Schemat projektu FaceVerse. Źródło: https://www.liuyebin.com/faceverse/faceverse.html
Parametry te są wykorzystywane do renderowania kolorowej sfery projekcji na 2D płaszczyźnie obrazu, przestrzennie wyrównanej z głową sterującą. Rozmiar sfery odpowiada głowie odniesienia, a jej kolor odzwierciedla orientację głowy. Abstrakcja ta redukuje złożoność uczenia 3D ruchu głowy, pomagając zachować stylizowane lub przesadzone kształty głowy w postaciach z animacji.

Wizualizacja sfery kontrolnej wpływającej na orientację głowy.
Wreszcie, aby sterować pełnym ruchem ciała, system wykorzystuje 3D szkielety ciała z adaptacyjną normalizacją długości kości. Parametry ciała i rąk są szacowane przy użyciu 4DHumans i HaMeR, które działają na modelu SMPL-X.

SMPL-X stosuje siatkę parametryczną na całe ciało ludzkie na obrazie, wyrównując z oszacowaną pozą i wyrazem, umożliwiając manipulację pozą przy użyciu siatki jako przewodnika objętościowego. Źródło: https://arxiv.org/pdf/1904.05866
Z tych danych wyjściowych wybiera się kluczowe stawy, projekty w 2D i łączy w mapy szkieletowe oparte na liniach. W przeciwieństwie do metod takich jak Champ, które renderują pełne siatki ciała, to podejście unika narzucania predefiniowanych priorytetów kształtu, a poprzez poleganie wyłącznie na strukturze szkieletu, model jest zachęcany do wnioskowania o kształt i wygląd ciała bezpośrednio z obrazów odniesienia, redukując uprzedzenia wobec określonych typów ciała i poprawiając uogólnienie na różnych pozach i budowach.
Podczas szkolenia, 3D szkielety ciała są łączone z sferami głowy i przekazywane przez kodujący pozę, który wyprowadza cechy, które są następnie łączone z hałasowanymi latencjami wideo, aby wyprodukować tokeny hałasu wykorzystywane przez Diffusion Transformer.
W czasie inferencji, system uwzględnia różnice szkieletowe między podmiotami, normalizując długości kości. Wstępnie wytrenowany model SeedEdit przekształca oba obrazy odniesienia i sterujące w standardową konfigurację kanoniczną. RTMPose jest następnie wykorzystywany do wyprowadzenia proporcji szkieletu, które są wykorzystywane do dostosowania szkieletu sterującego do anatomii podmiotu odniesienia.

Przegląd potoku inferencji. Pseudo-odniesienia mogą być generowane, aby wzbogacić wskazówki wyglądu, podczas gdy hybrydowe sygnały sterujące – jawne ruch twarzy i jawne poza z sfer głowy i szkieletu ciała – są wyprowadzane z filmu sterującego. Następnie są one wprowadzane do modelu DiT, aby wyprodukować animowany wynik, z ruchem twarzy rozłączonym od pozy ciała, umożliwiając użycie dźwięku jako sterującego.
Sterowanie wyglądem
Aby poprawić wierność wyglądu, szczególnie w obszarach zakrytych lub rzadko widocznych, system uzupełnia główny obraz odniesienia pseudo-odniesieniami pobranymi z wejściowego filmu.
Kliknij, aby odtworzyć. System przewiduje potrzebę dokładnego i spójnego renderowania obszarów zakrytych. Jest to jeden z najbliższych przykładów, jakich widziałem, w projekcie tego rodzaju, do podejścia bitmapowego w tradycyjnych technikach CGI.
Te dodatkowe klatki są wybrane dla różnorodności pozy przy użyciu RTMPose i filtrowane przy użyciu podobieństwa CLIP, aby upewnić się, że pozostają spójne z tożsamością podmiotu.
Wszystkie ramki odniesienia (główne i pseudo) są zakodowane przez ten sam kodujący wizualny i łączone za pomocą mechanizmu uwagi, umożliwiając modelowi dostęp do uzupełniających wskazówek wyglądu. To ustawienie poprawia pokrycie szczegółów, takich jak widoki profilowe lub tekstury kończyn. Pseudo-odniesienia są zawsze używane podczas szkolenia i opcjonalnie podczas inferencji.
Szkolenie
DreamActor został wytrenowany w trzech etapach, aby stopniowo wprowadzać złożoność i poprawiać stabilność.
W pierwszym etapie, tylko 3D szkielety ciała i 3D sfery głowy były używane jako sygnały sterujące, wykluczając reprezentacje twarzy. To pozwoliło na adaptację modelu generacji wideo do animacji ludzkiej bez zalewania go drobnymi kontrolami.
W drugim etapie, jawne reprezentacje twarzy zostały dodane, ale wszystkie inne parametry zamrożone. Tylko kodujący ruch twarzy i warstwy uwagi twarzy były szkolone w tym momencie, umożliwiając modelowi naukę szczegółów wyrazu w izolacji.
W końcowym etapie, wszystkie parametry były odblokowane do wspólnej optymalizacji na wygląd, pozę i dynamikę twarzy.
Dane i testy
Do fazy testowej model jest inicjowany z wstępnie wytrenowanego punktu kontrolnego DiT i szkolony w trzech etapach: 20 000 kroków dla każdego z pierwszych dwóch etapów i 30 000 kroków dla trzeciego.
Aby poprawić uogólnienie na różne długości i rozdzielczości, klipy wideo były losowo wybrane z długościami między 25 a 121 klatkami. Następnie zostały one zmniejszone do 960x640px, zachowując proporcje.
Szkolenie zostało przeprowadzone na ośmiu (chińskich) procesorach NVIDIA H20, każdy z 96GB pamięci VRAM, przy użyciu optymalizatora AdamW z (tolerancją) wysokim współczynnikiem uczenia 5e−6.
Podczas inferencji, każdy segment wideo zawierał 73 klatki. Aby utrzymać spójność między segmentami, ostateczny latent z jednego segmentu był ponownie wykorzystywany jako początkowy latent dla następnego, który kontekstualizuje zadanie jako sekwencyjną generację obrazu na wideo.
Bezklasowe sterowanie zostało zastosowane z wagą 2,5 zarówno dla obrazów odniesienia, jak i sygnałów sterujących.
Autorzy zbudowali zestaw danych szkoleniowych (bez podanych źródeł w artykule) składający się z 500 godzin wideo z różnych dziedzin, zawierających przypadki (między innymi) tańca, sportu, filmu i publicznych wystąpień. Zestaw danych został zaprojektowany, aby uchwycić szeroki zakres ruchu i wyrazu ludzkiego, z równym rozkładem między pełnymi i pół-ciałem ujęciami.
Aby poprawić jakość syntezy twarzy, Nersemble został uwzględniony w procesie przygotowania danych.

Przykłady z zestawu danych Nersemble, wykorzystanego do wzbogacenia danych dla DreamActor. Źródło: https://www.youtube.com/watch?v=a-OAWqBzldU
Do oceny, badacze wykorzystali swój zestaw danych również jako benchmark, aby ocenić uogólnienie na różne scenariusze.
Wyniki modelu zostały zmierzone przy użyciu standardowych miar z poprzednich prac: Fréchet Inception Distance (FID); Structural Similarity Index (SSIM); Learned Perceptual Image Patch Similarity (LPIPS); oraz Peak Signal-to-Noise Ratio (PSNR) do jakości na poziomie klatki. Fréchet Video Distance (FVD) został wykorzystany do oceny spójności czasowej i ogólnej wierności wideo.
Badacze przeprowadzili eksperymenty na zadaniach animacji ciała i portretu, wszystkie zatrudniające jeden (cel) obraz odniesienia.
Dla animacji ciała, DreamActor-M1 został porównany z Animate Anyone; Champ; MimicMotion; oraz DisPose.

Porównania ilościowe z rywalizującymi ramami.
Chociaż PDF zawiera statyczny obraz jako porównanie wizualne, jeden z filmów z witryny projektu może bardziej wyraźnie podkreślić różnice:
ZAWARTOŚĆ DŹWIĘKOWA. Kliknij, aby odtworzyć. Porównanie wizualne między ramami rywalizującymi. Film sterujący jest widoczny w lewym górnym rogu, a wniosek autorów, że DreamActor produkuje najlepsze wyniki, wydaje się uzasadniony.
Dla testów animacji portretu, model został oceniony przeciwko LivePortrait; X-Portrait; SkyReels-A1; oraz Act-One.

Porównania ilościowe dla animacji portretu.
Badacze zauważają, że ich metoda wygrywa w testach ilościowych i twierdzą, że jest również lepsza jakościowo.
ZAWARTOŚĆ DŹWIĘKOWA. Kliknij, aby odtworzyć. Przykłady porównań animacji portretu.
Można argumentować, że trzeci i ostatni z klipów pokazanych w powyższym filmie wykazuje mniej przekonywującą synchronizację ust w porównaniu z kilkoma rywalizującymi ramami, chociaż ogólna jakość jest niezwykle wysoka.
Wnioski
Przewidując potrzebę tekstur, które są sugerowane, ale nie są obecne w jedynym obrazie docelowym, Bytedance rozwiązał jeden z największych wyzwań stojących przed generacją wideo opartą na dyfuzji – spójne i trwałe tekstury. Następnym logicznym krokiem po udoskonaleniu takiego podejścia byłoby stworzenie atlasu odniesienia z wygenerowanego klipu, który mógłby być zastosowany do następnych, różnych generacji, aby utrzymać wygląd bez LoRAs.
Chociaż takie podejście byłoby w zasadzie zewnętrznym odniesieniem, nie różni się to od mapowania tekstur w tradycyjnych technikach CGI, a jakość realizmu i prawdopodobieństwa jest znacznie wyższa niż ta, którą mogą osiągnąć te starsze metody.
Powiedzmy, że najbardziej imponującym aspektem DreamActor jest połączony trójczęściowy system sterowania, który w inteligentny sposób łączy tradycyjną przepaść między syntezą ludzką skupioną na twarzy a syntezą ciała.
pozostaje tylko pytanie, czy niektóre z tych podstawowych zasad mogą być wykorzystane w bardziej dostępnych ofertach; jak na razie DreamActor wydaje się przeznaczony do zostania kolejną usługą syntetyzującą, surowo ograniczoną przez ograniczenia użytkowania i niepraktyczność prowadzenia obszernych eksperymentów z komercyjną architekturą.
* Moja замена hiperłączy na autorów; cytaty w tekście
† Jak wspomniano wcześniej, nie jest jasne, jaki smak Stable Diffusion został użyty w tym projekcie.
Pierwotnie opublikowane w piątek, 4 kwietnia 2025


