Grunnleggende AI
Hvordan fungerer tekstklassifisering?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Tekstklassifisering tilordner én eller flere etiketter til et dokument, en melding eller et tekstutdrag. Eksempler inkluderer spam‑deteksjon, intensjons‑ruting, sentimentanalyse, emnetagger, moderering og prioritering av support‑billetter.
En produksjonsklassifikator er mer enn bare en modell. Den avhenger av en presis etikett‑taksonomi, representative annotasjoner, lekkasjesikre delinger, en kalibrert beslutningsregel og overvåkning av endringer i språk og klassespredning.
Viktige punkter
- Definer etiketter og tvetydige tilfeller før du velger en arkitektur.
- Enkle bag‑of‑words‑baselines er fortsatt verdifulle; forhåndstrente kodere tilfører kontekst og overføringslæring.
- Nøyaktighet kan skjule dårlig ytelse på minoritetsklasser, så bruk klassebevisste mål og feil‑analyse.
- Sannsynlighets‑kalibrering, avståelse og menneskelig gjennomgang gjør poengsummer til tryggere beslutninger.
Definer taksonomien og annotasjonsretningslinjene
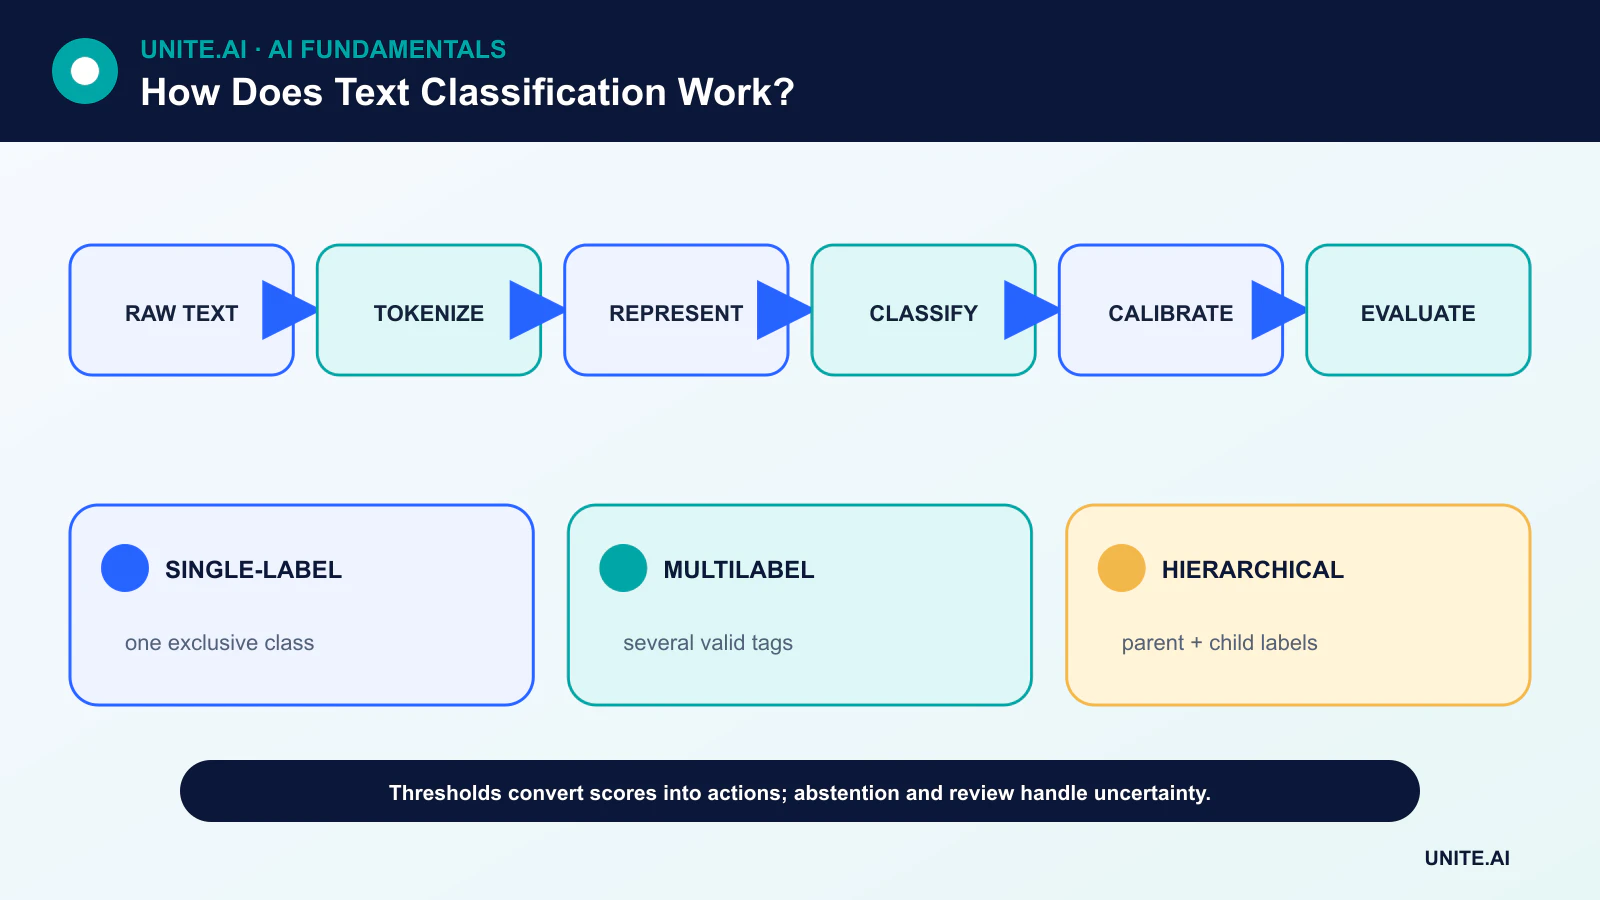
En oppgave med én etikett velger én gjensidig eksklusiv klasse. En fler‑etikett‑oppgave kan tilordne flere uavhengige merker. Hierarkiske taksonomier inneholder over‑ og under‑etiketter. Dette er ulike læringsproblemer og krever forskjellige utdata og mål.
Annotatorer trenger definisjoner, positive og negative eksempler, regler for manglende kontekst og en eskaleringsvei. Enighet‑statistikk kan avdekke en uklar oppgave, men uenighet kan også representere ekte tvetydighet som systemet bør bevare.
Representasjon av tekst
Tradisjonelle rørledninger bruker token‑telling, n‑gram og TF‑IDF med lineære klassifikatorer eller støttevektormaskiner. De trener raskt, viser hvilke termer som er viktige og gir et sterkt utgangspunkt.
Neurale systemer kartlegger token til innebygde vektorer. Forhåndstrente transformer‑kodere bruker oppmerksomhet for å produsere kontekstuelle representasjoner og kan fin‑justeres med merkede eksempler. Prompt‑baserte eller zero‑shot‑klassifikatorer kan redusere behovet for innledende merking, men deres etikett‑formulering, modellversjon og kalibrering må evalueres på det aktuelle domenet.
Trening uten lekkasje
Datasettet deles inn i trenings‑, validerings‑ og endelig testdata. Nær‑duplikat‑dokumenter, meldinger fra samme samtale eller maler fra samme kilde bør holdes i én deling. For tidsavhengig bruk gir en kronologisk deling et bedre bilde av produksjonsmiljøet.
Klasseskjevhet kan håndteres ved vekt‑justering, re‑sampling, terskelvalg eller ekstra data. Syntetiske eksempler bør ikke erstatte gjennomgang av ekte feil i minoritetsklasser og kan introdusere artefakter som modellen lærer for lett.
Mål og kalibrerte beslutninger
En forvirringsmatrise viser hvilke etiketter som forveksles. Presisjon måler hvor mange predikerte positive som er korrekte; tilbakekalling måler hvor mange sanne positive som blir funnet. Makro‑gjennomsnitt vekter klasser likt, mens mikro‑gjennomsnitt vekter individuelle eksempler.
En rå softmax‑score er ikke automatisk en pålitelig sannsynlighet. Kalibrering sammenligner tillit med observert korrekthet. Team kan sette klasse‑spesifikke terskler, avstå når tilliten er lav og rute sensitive tilfeller til en gjennomleser.
Distribusjon, flerspråklig bruk og driftsavvik
Tekst endrer seg med produkter, hendelser, slang og ondsinnet atferd. Overvåkning bør spore inndata‑språk, lengde, out‑of‑vocabulary‑mønstre, klassesatser, tillit og forsinkede resultater. Gjen‑trening krever versjonert data og en regresjonspakke med viktige eksempler.
Flerspråklig ytelse må testes per språk og dialekt. Å oversette alt til ett språk kan endre sentiment eller entiteter; en flerspråklig enkoder kan fortsatt prestere ujevnt fordi dens forhåndstrening og etiketter ikke er like representativt for alle språk.
Representasjoner og klassifikator‑familier
Tekstklassifisering kartlegger et dokument, en setning eller en token‑sekvens til én eller flere etiketter. Definer om etiketter er gjensidig eksklusive, fler‑etikett, hierarkiske, ordnede eller åpne. Tradisjonelle rørledninger tokeniserer tekst, bygger bag‑of‑words eller TF–IDF‑funksjoner, og trener logistisk regresjon, Naïve Bayes eller en lineær SVM. Neurale systemer lærer innebygde vektorer med konvolusjon, rekursjon eller transformere. Prompt‑baserte språkmodeller kan klassifisere uten oppgave‑spesifikk trening, men output‑begrensninger, kostnad, driftsavvik og bevis krever fortsatt evaluering mot enklere baselines.
Forbehandling avhenger av representasjonen. Nedtrekking til små bokstaver eller fjerning av tegnsetting kan ødelegge signaler for navn, sentiment, kode eller språk; stemming kan slå sammen ulike betydninger. Transformer‑tokenizere opererer på sub‑ord og har lengdebegrensninger, så trunkeringsstrategi er viktig. Lange dokumenter kan kreve oppdeling og aggregasjon. Bevar råtekst og transformasjonsversjon, og del etter forfatter, samtale, kilde eller tid for å hindre nær‑duplikater og tilbakevendende maler fra å kryss‑trene.
Etiketter, mål og feil‑analyse
En annotasjonsveiledning bør definere omfang, eksempler, tvetydige tilfeller og en ukjent‑eller‑avstå‑alternativ. Mål enighet og avgjør uenighet i stedet for å skjule den med flertalls‑stemmegivning. For ubalanserte klasser er nøyaktighet utilstrekkelig; rapporter presisjon, tilbakekalling, F1, forvirring, kalibrering og terskel‑spesifikk arbeidsbelastning per klasse. Fler‑etikett‑oppgaver trenger mikro, makro og etikett‑nivå mål. Evaluer språk, dialekter, domener, meldingslengde og tid. En tilfeldig deling kan overdrive kvalitet når vokabular eller maler drifter.
Feil‑analyse bør skille representasjons‑svikt, utilstrekkelig kontekst, etikett‑tvetydighet, sjeldent vokabular, negasjon, sarkasme og falske signaler. Bruk kontrafaktiske tester som endrer navn, dialekt‑markører eller irrelevant metadata mens meningen bevares. Undersøk feil med høy tillit og avviste tilfeller. En modell kan lære at en kundekanal eller signatur predikerer en etikett i stedet for å tolke innholdet. Fjern lekkasje og revider data før du kun øker modellkapasiteten.
Produksjonsdesign
Tjen en fast tokeniserer og modell med skjema‑validering, lengdebegrensninger, batch‑behandling og en fallback for språk som ikke støttes eller lav tillit. Overvåk inndata‑fordeling, etikett‑rater, kalibrering, latens og gjennomgåtte resultater. Beskytt tekst fordi den kan inneholde personlig, konfidensiell eller ondsinnet instruksjon. For automatisert moderering, berettigelse eller ruting, tilby klage‑mulighet og mål ulik behandling. Versjoner etiketter og terskler i samsvar med forretningspolitikk. Tekstklassifisering er pålitelig kun innenfor sitt definerte etikett‑system og datafordeling; flytende modellforklaringer beviser ikke at en klassifisering er korrekt.
Arbeidseksempel: klassifisere innkommende support‑forespørsler
Et supportteam definerer gjensidig eksklusive rutings‑etiketter samt flagg for hastesaker, flerspråklighet og ukjente. Annotatorer merker de‑identifiserte meldinger med veiledning for blandede problemstillinger og måler enighet. En TF–IDF‑logistisk baseline, fin‑justert enkoder og prompt‑modell bruker samme tids‑baserte testsett. Evalueringsrapporten viser klasse‑presisjon og tilbakekalling, falske negativer for hastesaker, kalibrering, skjema‑gyldighet, latens og kostnad, med nær‑duplikat‑maler gruppert for å unngå lekkasje.
Den distribuerte klassifikatoren validerer språk og lengde, avstår ved svak evidens, og lar agenter korrigere ruter. Prompt og meldinger behandles som upålitelige; verktøy‑tilgang er fraværende. Overvåkning sporer etikett‑frekvens, tillit, korreksjoner, responstid og fremvoksende temaer. En policy‑ eller produktendring oppdaterer taksonomien og gjen‑trening‑data gjennom gjennomgang. Systemet forbedrer kø‑plassering, men det infererer aldri kundens følelser eller rettigheter utover de validerte etikettene.
Implementasjonsbevis og operasjonell beredskap
En produksjonsbeslutning krever mer enn en vellykket demonstrasjon. Definer de tiltenkte brukerne, driftsmiljøet, inndata, utdata, avhengigheter, eier og konsekvensene av hver viktig feil. Etabler en reproduserbar baseline og et versjonert evalueringssett før justering. Test vanlige tilfeller, grensetilstander, feil‑ eller manglende inndata, distribusjons‑skifte, avhengighets‑nedbrudd, misbruk og de grupper eller miljøer som mest sannsynlig blir underbetjent. Mål oppgavekvalitet sammen med kalibrering eller usikkerhet, latens, gjennomstrømning, ressurskostnad, tilgjengelighet, personvern og sikkerhet. Registrer hver transformasjon og terskel slik at en uavhengig gjennomleser kan reprodusere resultatet og skille bevis fra en attraktiv prototype.
Før lansering, tildel myndighet for utgivelse, unntak, endringer, tilbakeføring og pensjonering. Bruk en trinnvis utrulling, bevar en sikker fallback, og verifiser overvåkning med bevisst injiserte feil. Operasjonell telemetri bør avdekke inndata‑kvalitet, utdata‑atferd, modell‑ eller regelversjon, avhengighets‑helse, menneskelige overstyringer og bekreftede resultater uten å samle unødvendige sensitive data. Definer varslings‑terskler og en respons‑eier, og gjennomgå virkelige bevis etter utrulling i stedet for å anta at offline‑ytelse vil vedvare. Revurder når datakilder, brukere, modeller, leverandører, policyer, maskinvare eller mål endres. Et vedlikeholdt system trenger også dokumenterte gjenopprettings‑, hendelses‑lærings‑, slettings‑ og lagringsprosedyrer, samt et tydelig tidspunkt for når det skal deaktiveres eller erstattes.
Ofte stilte spørsmål
Er sentimentanalyse en tekstklassifiserings‑oppgave?
Vanligvis ja, men sentiment kan være fler‑etikett, aspekt‑basert eller kontinuerlig i stedet for én enkelt positiv/neutral/negativ etikett.
Når bør en tekstklassifikator avstå?
Når tilliten er lav, teksten er utenfor omfang, nødvendig kontekst mangler eller kostnaden ved en feil automatisk handling overstiger kostnaden ved gjennomgang.
Primære referanser