
Grunnleggende AI
Hva er samtalebasert talegjenkjenning (CSR)?

 Legg til Unite.AI blant dine foretrukne kilder på Google
Samtalebasert talegjenkjenning (CSR) utvider automatisk talegjenkjenning utover isolert transkripsjon ved å bruke dialogkontekst, signaler for turbytte, talerinformasjon og lav‑latens behandling. Målet er å støtte en direkte interaksjon der ord, timing, avbrytelser og tidligere turer alle er viktige.
CSR er en fremvoksende produkt‑ og forskningsbetegnelse, ikke en enkelt standardisert modellklasse. Et robust system kombinerer strømmende ASR med endepunktsdeteksjon, håndtering av talere, kontekstuell språkmodellering, dialogtilstand og en respons‑policy, og evaluerer deretter opplevelsen fra ende til ende.
Viktige punkter
- Strømmende gjenkjenning gir midlertidige hypoteser og reviderer dem etter hvert som mer lyd kommer inn.
- Endepunktsdeteksjon og tur‑forutsigelse er uavhengige av transkripsjonsnøyaktighet.
- Samtalehistorikk og hotwords kan forbedre gjenkjenning, men kan også videreføre tidligere feil.
- Evaluer latens, avbrytelser, talere, aksenter, støy, personvern og oppgavefullføring – ikke kun ordfeilrate.
Fra ASR til levende dialog
Tradisjonell ASR oversetter lyd til tekst. Et samtalesystem må avgjøre når det skal lytte, når en tur er fullført, om talen er rettet mot systemet, og hvordan det skal gjenopprette seg når transkripsjonen eller responsen er feil.
Strømmende modeller behandler rammer inkrementelt og produserer delvise transkripsjoner. Lav latens forbedrer responsiviteten, men for tidlig forpliktelse kan øke revisjoner eller feil. Applikasjonen trenger en policy for stabil versus midlertidig tekst.
Turbytte, overlapping og talere
Varigheten av stillhet alene er et svakt endepunktsignal. Lexikalisk fullføring, prosodi, timing, blikk og dialogtilstand kan hjelpe med å forutsi om en person holder eller gir fra seg taleretten. Barge‑in gjør at en bruker kan avbryte syntetisert tale uten å miste kontekst.
Overlappende stemmer og diarisation er fortsatt utfordrende. Systemer bør bevare usikkerhet om taleren, unngå å tilskrive en uttalelse til feil person, og tilby en korrigeringsvei – spesielt for journaler som brukes i helsevesen, finans eller juridisk arbeid.
Kontekstuell gjenkjenning
Tidligere turer kan avklare navn og referanser; hotword‑lister kan påvirke gjenkjenning mot domenespesifikke termer. Tale‑språk‑modeller kan kode lyd‑ og tekstkontekst i en felles prompt‑ eller oppmerksomhetsramme.
Kontekst kan også forsterke en feilaktig tidligere transkripsjon eller lekke informasjon mellom økter. Begrens historikken til det aktuelle formålet, skil på pålitelig metadata fra brukerens tale, og bruk transformer‑kontekst med eksplisitte lagrings‑ og tilgangsregler.
Evaluering og ansvarlig utrulling
Rapporter strømmende ordfeilrate, latens for første token og fullføring, revisjonsrate, endepunktsfeil, barge‑in‑suksess, taler‑attribusjon og oppgavefullføring. Test med ekte mikrofoner, støy, aksenter, kode‑bytte, funksjonsnedsettelser og følelsesladet tale.
Taledata kan identifisere eller avsløre sensitiv informasjon. Bruk samtykke, dataminimering, kryptering, lagringsbegrensninger og menneskelig gjennomgang. Koble genererte svar til chatbot‑sikkerhetskontroller, fordi nøyaktig transkripsjon ikke gjør et svar korrekt eller autorisert.
Fra akustisk input til samtalestatus
Et samtalebasert talesystem fanger opp lyd, anvender signalbehandling, oppdager tale, gjenkjenner ord eller semantiske enheter, identifiserer talere ved behov, og oppdaterer dialogtilstanden. Strømmende systemer produserer delvise hypoteser før en ytring er avsluttet. Disse hypotesene kan endres, så nedstrøms komponenter må skille mellom foreløpige og endelige resultater.
Talekontroll og endepunktsdeteksjon avgjør når tale starter og når brukeren er ferdig. Faste stillhetsterskler svikter med trege talere, bakgrunnsstøy og tenkepausere. Turbyttemodeller kan bruke ord, prosodi, blikk og dialogkontekst, men de må balansere rask respons mot å avbryte taleren.
Diarisation svarer på hvem som snakket når; taler‑gjenkjenning estimerer identitet; kilde‑separasjon isolerer overlappende stemmer. Dette er ulike oppgaver med ulike risikoer. I møter, helsevesen og kundeservice kan det å tilskrive de riktige ordene til riktig person være like viktig som transkripsjonens ordfeilrate.
Kontekst, overlapping, følelser og gjenoppretting av interaksjon
Samtalekontekst løser pronomen, ellipser, korrigeringer, domenetermer og referanser til tidligere turer. Et system kan kombinere akustisk bevis med dialoghistorikk og hentet kunnskap, men tidligere kontekst kan også påvirke gjenkjenning mot en feilaktig forventning. Bevar lydbevis og selvtillit slik at kontekst ikke stille overskriver usikkerhet.
Naturlig dialog inkluderer tilbakekanaler, avbrytelser, falske starter, latter, kode‑bytte og samtidig tale. En responsiv agent trenger barge‑in‑håndtering: stoppe eller dempe sin utdata, fange brukerens nye tale, avgjøre om avbrytelsen endrer intensjon, og gjenopprette uten å duplisere eller miste en handling.
Prosodi og paralingvistiske signaler kan indikere vektlegging eller usikkerhet, men å trekke slutninger om følelser, helse eller intensjon fra stemmen er feilutsatt og kulturavhengig. Bruk slike estimater med forsiktighet, opplys om dem der det er hensiktsmessig, og ta ikke viktige beslutninger basert på en uvalidert følelsesetikett.
Evaluering, personvern og produksjonsdesign
Ordfeilrate er fortsatt nyttig, men samtale‑evaluering bør også måle taler‑attribusjon, entitetsnøyaktighet, semantisk oppgavesuksess, stabilitet i delvise hypoteser, endepunktslatens, avbrytingssuksess, gjenoppretting og bruker‑korrigeringsrate. Segmenter etter aksent, språk, enhet, støy, overlapping, talestil og nettverksforhold.
Strømmende arkitektur krever avgrensede buffere, tilbakeslag, gjenoppretting av tilkobling, sekvensnumre og eksplisitt fullføring. Hold modell‑ og dialog‑latensbudsjetter adskilt, spor hver fase, og test på forringede nettverk. Når et system utløser handlinger, bekreft intensjon med høy påvirkning og gjør gjenforsøk idempotente slik at gjentatt lyd eller gjenopprettede tilkoblinger ikke dupliserer transaksjoner.
Tale inneholder identitet, innhold, miljø‑ og tilskuere‑informasjon. Minimér lagring, krypter transport og lagring, kontroller tilgang, definer sletting, og skil mellom lyd og avledede transkripsjoner og innbeddinger. Gi synlige opptaksindikatorer og alternativer når samtykke mangler. En lokal modell kan redusere overføring, men krever fortsatt tillatelse og livssyklus‑kontroller.
Arbeidseksempel: en stemmeassistent som håndterer avbrudd og korrigering
En innringer sier: «Book tirsdag – nei, onsdag ettermiddag», mens assistenten begynner å svare etter «tirsdag». Strømmende gjenkjenning gir endrende delvise transkripsjoner, endepunktsdeteksjon oppdager fortsatt tale, og barge‑in stopper utdata. Dialogtilstanden markerer den tidligere datoen som erstattet i stedet for å opprette to forespørsler. Entitetsbekreftelse fokuserer på den korrigerte datoen og tiden, mens systemet beholder selvtillit og bevis for den endelige tolkningen.
Arkitekturen skiller lydopptak, taledeteksjon, strømmende gjenkjenning, taler‑håndtering, dialog‑policy, verktøyutførelse og syntese. Sekvensnumre og fullføring hindrer sene delvise resultater fra å overskrive den endelige transkripsjonen. Bestillingsverktøyet aksepterer en strukturert forespørsel, sjekker autorisasjon og tilgjengelighet, og bruker en idempotensnøkkel. En påfølgende bestilling blir lest opp og bekreftet før utførelse; en gjenoppretting kan ikke stille gjenta den.
Testing kombinerer ord‑ og entitetsnøyaktighet med endepunktslatens, avbrytingssuksess, korrigeringshåndtering, taler‑attribusjon, oppgavefullføring og duplikat‑handlingsrate. Scenarier dekker støy, overlapping, aksenter, kode‑bytte, langsom tale, hjelpemidler, svake nettverk og syntetiske angrep. Lydlagring minimeres og opplyses, tilskuerdata håndteres eksplisitt, og brukere kan bytte til tekst eller en menneskelig operatør. Samtalekunst måles etter sikker gjenoppretting og resultat, ikke kun transkripsjonsnøyaktighet.
Praktisk implementeringssjekkliste
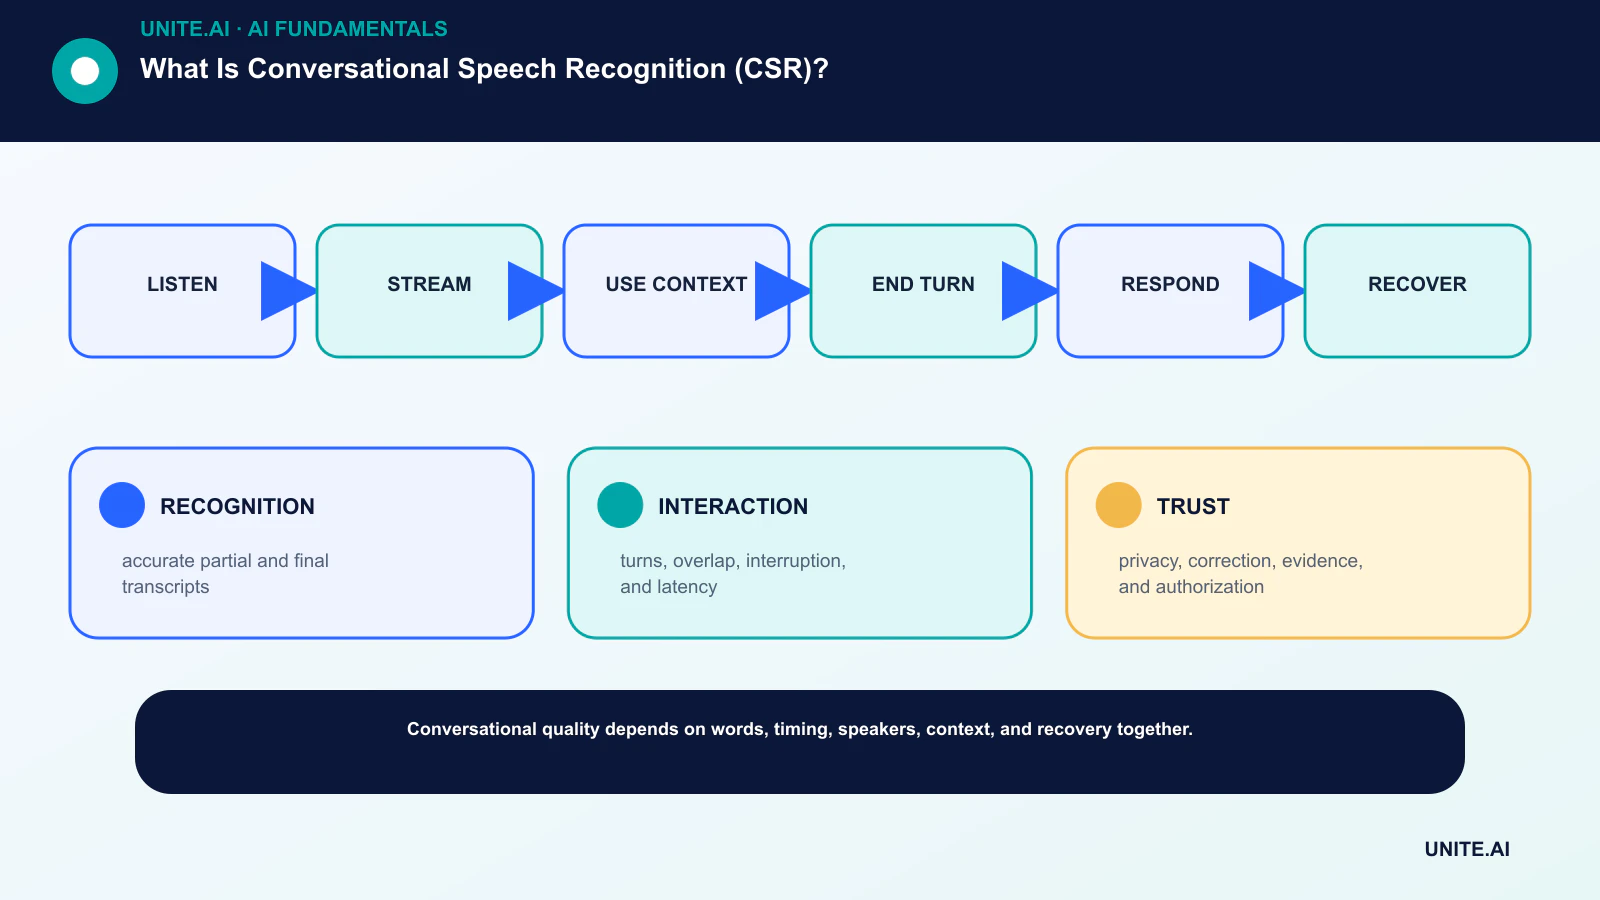
Gjør konseptet til en avgrenset, testbar arbeidsflyt: lytt → strøm → bruk kontekst → avslutt tur → svar → gjenopprett. Utpek en ansvarlig eier, dokumenter data og avhengigheter, etabler en enkel basislinje, sett aksept‑ og stoppkriterier, test representative feil, og definer overvåking, tilbakeføring og gjennomgang før omfanget utvides. Registrer versjoner og forutsetninger slik at et annet team kan gjenskape resultatet og forstå hva som har endret seg.
Før lansering, gjennomfør en dokumentert beredskapsgjennomgang med de som bygger, drifter, sikrer og påvirkes av systemet. Test normale tilfeller, grensetilstander, avhengighetsfeil og misbruk; bevar bevis og uløste risikoer. Definer hvem som kan godkjenne utgivelse, endre en terskel, overstyre en utdata eller stoppe driften. Revurder beslutningen etter at virkelige data kommer inn, fordi en teknisk vellykket pilot ikke garanterer pålitelig ytelse i større skala.
- GJENKJENNING: nøyaktige delvise og endelige transkripsjoner.
- INTERAKSJON: turer, overlapping, avbrytelse og latens.
- TILLIT: personvern, korrigering, bevis og autorisasjon.
Ofte stilte spørsmål
Er CSR forskjellig fra ASR?
ASR er tale‑til‑tekst‑komponenten. CSR bruker ASR i tillegg til dialogkontekst, timing, taler‑ og endepunkthåndtering, samt interaksjonspolicyer for direkte samtale.
Garanterer en lavere ordfeilrate en bedre stemmeassistent?
Nei. Et system kan transkribere nøyaktig, men likevel avbryte brukere, svare sakte, tilskrive talere feil, eller utføre feil handling. End‑to‑end‑interaksjonsmålinger er nødvendige.
Primære referanser












