AI:n perusteet
Mikä on koneoppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Koneoppiminen (ML) on tekoälyn haara, jossa järjestelmä oppii malleja datasta, jotta se voi tehdä ennusteita, luokitteluja, suosituksia tai päätöksiä ilman, että kehittäjä kirjoittaa erillisen säännön jokaiselle mahdolliselle tapaukselle. Tuloksena ei ole kone, joka “ajattelee” kuin ihminen. Se on tilastollinen malli, joka kartoittaa syötteet hyödyllisiin tuloksiin ja voidaan arvioida datalla, jota se ei nähnyt koulutuksen aikana.
Koneoppiminen kuuluu laajempaan tekoälyn kenttään, kun taas syväoppiminen on koneoppimismenetelmien perhe, joka perustuu monikerroksisiin neuroverkkoihin. Tämä ero on merkityksellinen: kaikki tekoälyjärjestelmät eivät käytä ML:ää, eikä jokainen ML-ongelma vaadi neuroverkkoa.
Keskeiset havainnot
- ML oppii suhteen esimerkeistä sen sijaan, että luottaisi pelkästään käsin kirjoitettuihin sääntöihin.
- Hyödyllisen mallin täytyy yleistää uuteen dataan, eikä pelkästään muistaa koulutusdataa.
- Ohjattu, ohjaamaton, puoliksi ohjattu, itseohjattu ja vahvistusoppiminen ratkaisevat erilaisia ongelmia.
- Datan laatu, arviointisuunnittelu ja seuranta ovat yhtä tärkeitä kuin algoritmi.
Miten koneoppiminen toimii
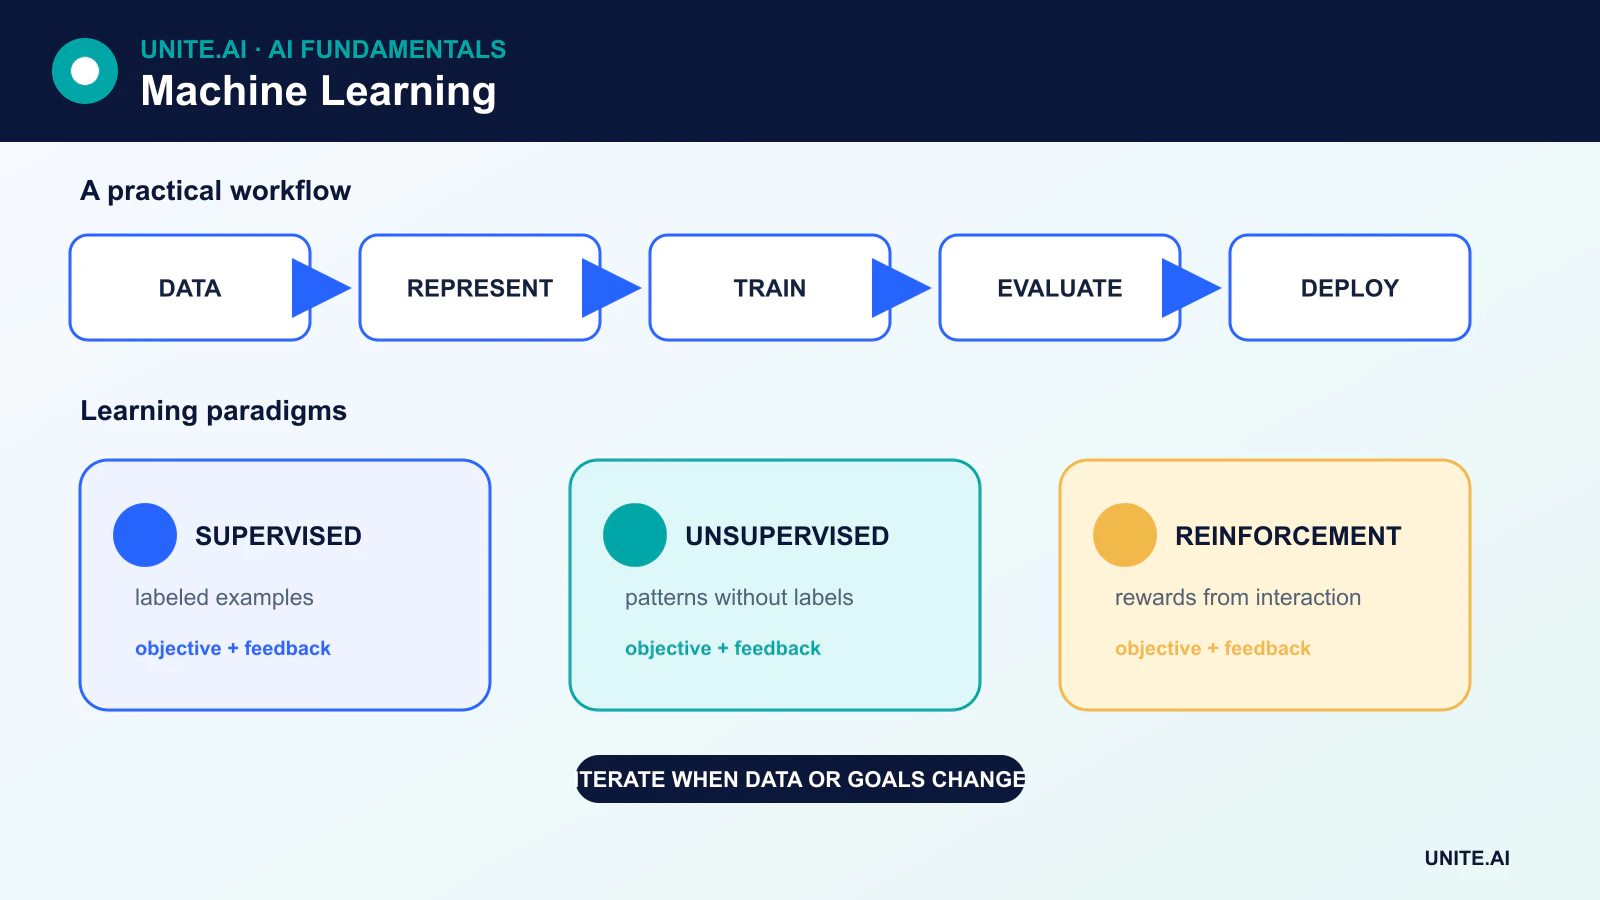
Useimmat ML-projektit voidaan ymmärtää kuuden vaiheen sarjana:
- Määrittele tehtävä. Päätä, mitä järjestelmän tulisi ennustaa tai löytää ja mitä menestys tarkoittaa todellisessa sovelluksessa.
- Kerää ja valmistele data. Puhdista tietueet, käsittele puuttuvat arvot, luo hyödyllisiä piirteitä ja dokumentoi, mistä data on peräisin.
- Jaa data. Koulutusjoukkoa käytetään mallin sovittamiseen, validointijoukko auttaa valitsemaan asetuksia, ja testijoukko antaa lopullisen arvion käsittelemättömälle datalle.
- Kouluta malli. Algoritmi säätää mallin parametreja vähentääkseen häviöfunktiota tai täyttääkseen toisen oppimisen tavoitteen.
- Arvioi yleistymistä. Mittareiden on heijastettava tehtävää, luokkatasapainoa, virhekustannuksia ja väestöä, jossa malli toimii.
- Ota käyttöön ja seuraa. Todellinen data voi muuttua, joten tiimit tarkkailevat poikkeamia, suorituskyvyn heikkenemistä, vinoutumia ja operatiivisia vikoja.
Mallille syötettyjä muuttujia kutsutaan yleisesti piirteiksi. Ohjatussa oppimisessa haluttu vastaus on nimeltään merkintä tai tavoite. Mallin oppimat parametrit koodaavat suhteen piirteiden ja ulostulon välillä; ne eivät ole erillinen sääntöjen tietokanta.
Koneoppimisen pääparadigmat
Ohjattu oppiminen
Ohjatussa oppimisessa (ohjattu oppiminen) esimerkit sisältävät sekä syötteet että tunnetut tavoitteet. Luokittelumalli ennustaa kategorioita, kuten onko tapahtuma petollinen. Regressiomalli ennustaa jatkuvan arvon, kuten odotetun energiankulutuksen.
Yleisiä ohjattuja algoritmeja ovat päätöspuut, tukivektorikoneet, K-lähimmän naapurin, lineaarinen ja logistinen regressio, gradienttitehostetut puut, ja neuroverkot. Luokittelukynnys, kuten 0.5, on päätös, joka tehdään mallin tuottaman pisteytyksen tai todennäköisyyden jälkeen; se ei ole logistisen regression muuttumaton ominaisuus.
Ohjaamaton oppiminen
Ohjaamaton oppiminen toimii datalla, jossa ei ole tavoitemerkintöjä. Tavoitteena voi olla löytää klustereita, havaita poikkeavia havaintoja, arvioida jakaumaa tai luoda alempidimensionaalinen esitys. Klusteri on ryhmä, jonka ehdottaa samankaltaisuussääntö; se ei automaattisesti ole merkityksellinen todellinen luokka.
Esimerkkejä ovat K-means-klusterointi, pääkomponenttianalyysi, tiheysestimaatti ja jotkut autoenkooderit. Autoenkooderi oppii rekonstruoimaan syötteensä pakatun esityksen kautta. Se ei automaattisesti luo todellisia merkintöjä.
Puoli-ohjattu ja itseohjattu oppiminen
Puoli-ohjattu oppiminen yhdistää pienen merkityn datasetin suurempaan merkkaamattomaan datasettiin. Itseohjattu oppiminen luo koulutussignaalin datasta itsestään — esimerkiksi ennustamalla maskattuja sanoja tai sovittamalla kaksi muokattua näkymää samasta kuvasta. Itseohjaus on keskeinen monissa nykyaikaisissa transformer– ja perustamismalliputkissa, koska se voi hyödyntää suuria kokoelmia tekstiä, kuvia, ääntä tai videota ilman, että henkilö merkitsee jokaisen esimerkin.
Vahvistusoppiminen
Vahvistusoppimisessa (reinforcement learning) agentti tekee toimintoja ympäristössä ja saa palkintoja tai kustannuksia. Tavoitteena on oppia politiikka, joka maksimoi odotetun kumulatiivisen palkinnon. Tämä eroaa ohjatussa oppimisessa, koska oikeaa toimintoa ei anneta jokaiselle tilalle, ja toiminto voi vaikuttaa siihen, millaista dataa agentti kohtaa seuraavaksi.
Koulutus, validointi ja yleistyminen
Malli, joka suoriutuu hyvin koulutusesimerkeistään, voi silti epäonnistua uudessa datassa. Tämä epäonnistuminen tunnetaan nimellä ylisovittaminen. Tiimit vähentävät sitä sopivan mallikapasiteetin, regularisoinnin, ristiinvalidoinnin, datan augmentoinnin, vuotojen estämisen ja aidosti riippumattoman testijoukon avulla.
Yhdellekään ML-tehtävälle ei ole yhtä mittaria. Luokittelussa saatetaan tarvita tarkkuutta, palautetta, F1-pistettä, kalibrointia tai kustannuspainotettua mittaria raakan tarkkuuden sijaan. Regressiossa voidaan käyttää keskimääräistä absoluuttista virhettä, neliöjuurivirhettä tai toimialakohtaista häviötä. Klusteroinnissa tarvitaan erilaisia sisäisiä tai ulkoisesti validoituja arvioita. Mittarin tulisi heijastaa, mitä virhe käyttäjälle tai organisaatiolle merkitsee.
Koneoppimisen algoritmit ovat työkaluja, eivät takuita
Algoritmi sisältää oletuksia. Lineaariset mallit olettavat tietynlaisen suhteen. K-lähimmän naapurin olettaa, että valittu etäisyys edustaa merkittävää samankaltaisuutta. Naive Bayes olettaa, että piirteet ovat ehdollisesti riippumattomia luokasta riippuen. Päätöspuut jakavat piirteiden avaruuden opittujen jakosääntöjen avulla; niiden lehdet sisältävät ennusteita, jotka perustuvat koulutushavaintojen ryhmiin, eivät välttämättä yksittäisiin havaintoihin.
Mallin valinta riippuu siis datan koosta, piirteiden tyypeistä, viivevaatimuksista, tulkittavuustarpeista ja virheiden kustannuksista. Yksinkertaisempi malli voi ylittää suuremman mallin, kun data on rajallista tai operatiiviset rajoitteet suosivat nopeutta ja läpinäkyvyyttä.
Missä koneoppimista käytetään
ML tukee hakurankingia, suosituksia, ennustamista, poikkeavuuksien havaitsemista, käännöstä, puheentunnistusta, tietokonenäköä, ennakoivaa kunnossapitoa, petosten havaitsemista ja tieteellistä analyysiä. Samat tekniikat voivat myös vahvistaa historiallista vinoutta, paljastaa arkaluonteista tietoa tai käyttäytyä ennakoimattomasti jakauman muutoksessa. Vastuullinen käyttöönotto edellyttää dokumentaatiota, tarvittaessa ihmisen valvontaa, turvallisuustestausta ja jatkuvaa seurantaa.
Ongelman määrittelystä kelvolliseen koneoppimiseksperimenttiin
Koneoppimisprojekti tulisi aloittaa päätöksellä ja mitattavalla tuloksella, ei algoritmilla. Määrittele ennusteen yksikkö, tavoite, havainnointiaika, päätösaika, käytettävissä olevat piirteet ja jokaisen virheen kustannus. Esimerkiksi churn-mallissa tapahtumien käyttäminen, jotka on kirjattu peruutuksen jälkeen, vuotaa vastauksen. Perusta yksinkertainen sääntö tai tilastollinen peruslinja, ja jaa data ajan, asiakkaan, sijainnin tai muun käyttöönottoa vastaavan rajan mukaan. Satunnaiset rivijakautumiset voivat sijoittaa lähes identtisiä havaintoja koulutus- ja testijoukkoihin ja tuottaa harhaanjohtavan pistemäärän.
Piirteiden suunnittelu muuntaa raakatiedot mallin käyttämiksi esityksiksi, mutta jokainen piirre tarvitsee alkuperän ja saatavuustakuun. Sovita normalisointi, sanasto, imputointi ja dimensioiden vähennys vain koulutusdataan, ja sen jälkeen sovella opittua muunnosta validointi- ja testidataan. Ristiinvalidointi arvioi vaihtelua näytteiden välillä; lopullinen käsittelemätön testijoukko tukee julkaisupäätöstä. Valitse mittarit seurauksista: tarkkuus ja palautus epätasaisiin luokitusvirheisiin, kalibrointi, kun todennäköisyydet ohjaavat toimintaa, sekä kustannus- tai hyötypainotetut mittarit, kun virheillä on erilaisia operatiivisia vaikutuksia.
Käyttöönotto, seuranta ja vastuullinen toiminta
Tuotantotason inferenssi toistaa koko koulutusaikaisen muunnoksen ja palauttaa ennusteen viiveen, läpimenoajan ja saatavuusrajoitusten puitteissa. Pakkaa esikäsittely mallin kanssa, validoi syöteskeemat, versioi artefaktit ja vertaa tuloksia offline- ja palveluversioiden välillä. Valitse kynnys käyttökapasiteetin ja virhekompromissin perusteella sen sijaan, että oletettaisiin 0.5. Ota käyttöön varjotestauksen, rajoitetun kohortin tai kokeilun, jossa on turvavälin mittarit. Säilytä deterministinen varajärjestelmä ja palautuspolku riippuvuuden vian tai sietämättömän käyttäytymisen varalta.
Seuraa syötteen laatua, piirteiden poikkeamaa, ennusteiden jakaumaa, kalibrointia, alaryhmien tuloksia, viivettä, kustannuksia ja vahvistettuja merkintöjä, kun ne lopulta saapuvat. Poikkeama on signaali tutkittavaksi, ei automaattinen todiste siitä, että uudelleenkoulutus auttaisi. Uudelleenkoulutus vaatii tarkastettua dataa, toistettavia testejä, hyväksynnän ja vertailun nykyiseen parhaaseen. Dokumentoi suunnitellut ja virheelliset käyttötavat, datan oikeudet, yksityisyys, turvallisuus, ihmisen ohitus ja valitus, kun ihmiset vaikuttavat. Koneoppiminen on ylläpidetty päätöksentekojärjestelmä; mallitiedosto on vain yksi vaihdettava komponentti.
Käytännön esimerkki: laitteiston vian ennustaminen
Valmistaja määrittelee yhden ennusteen per kone‑päivä: onko vahvistettu vika tapahtuvaa seitsemän päivän sisällä käyttäen vain sen päivän alussa saatavilla olevaa telemetriaa. Data jaetaan koneen ja ajan mukaan, verrataan ikä‑ ja kynnysperusteisiin sääntöihin, sovitetaan esikäsittely koulutusdataan ja arvioidaan tapahtuman palautusta, vääriä hälytyksiä, varoitusajan etua, kalibrointia ja kunnossapitokapasiteettia. Anturin vaihtaminen ja suunnitellut sulkemiset mallinnetaan käyttöympäristönä sen sijaan, että ne käsiteltäisiin tavallisina havaintoina.
Malli ajetaan aluksi varjotilassa. Hälytykset näyttävät vaikuttavan telemetrian ja epävarmuuden, mutta ylläpitäjät päättävät, tarkastellaanko. Havainnot ja vahvistetut syyt muuttuvat hallittaviksi merkinnöiksi; työmääräyksen puuttumista ei oleteta merkkaavan vian puuttumista. Vaiheittainen käyttöönotto käyttää hälytysrajoja ja manuaalista varajärjestelmää, samalla kun seuranta tarkkailee anturin kuntoa, syötteen poikkeamaa, tarkistettua tarkkuutta, käyttökatkoa ja tarpeetonta kunnossapitoa. Uudelleenkoulutus tapahtuu vain sen jälkeen, kun data- ja kynnystarkastus osoittavat todennäköisen parannuksen nykyiseen käyttöönotettuun järjestelmään.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määrittele suunnitellut käyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän vian seuraukset. Perusta toistettava peruslinja ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakauman siirtyminen, riippuvuuden katkos, väärinkäyttö sekä ryhmät tai ympäristöt, joille todennäköisesti tarjotaan riittämättömästi. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnys, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua määritä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palautukseen ja elinkaaren päättämiseen. Käytä vaiheittaista käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista seuranta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, ulostulon käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määrittele hälytysrajat ja vastuu, ja tarkastele todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, käytännöt, laitteisto tai tavoitteet muuttuvat. Ylläpidetty järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamis- ja säilytyskäytännöt sekä selkeän pisteen, jossa se tulisi poistaa käytöstä tai korvata.
Ensisijaiset lähteet