AI:n perusteet
Ohjattu vs Ohjaamaton oppiminen

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
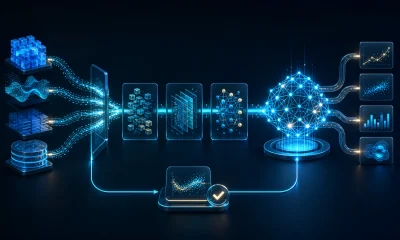
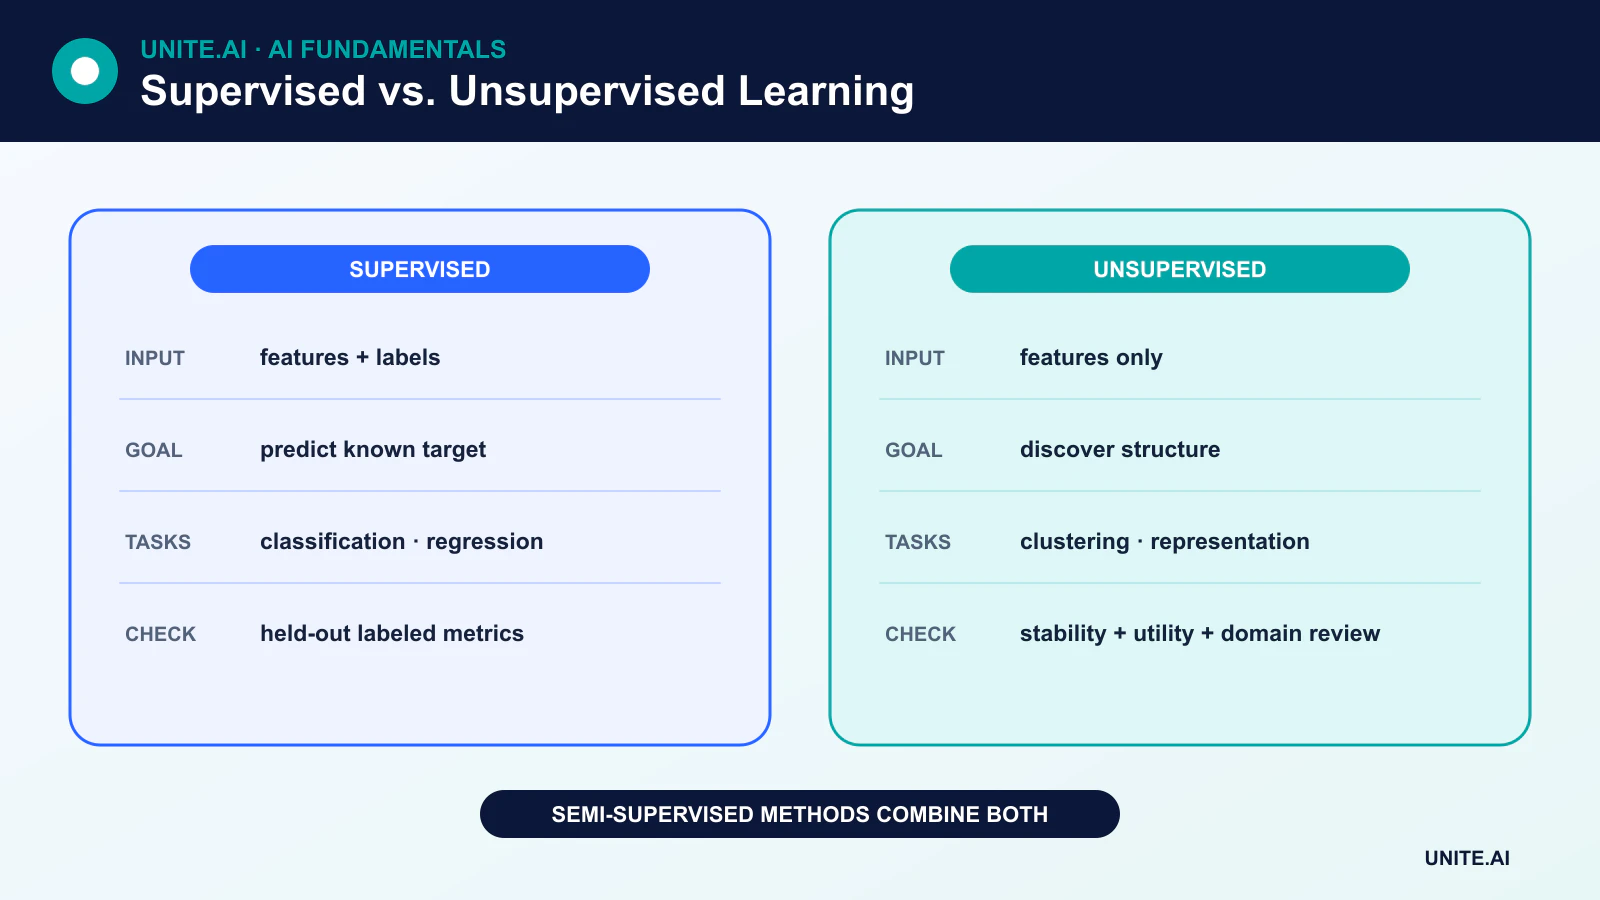
Ohjattu oppiminen oppii esimerkeistä, jotka on yhdistetty tavoitevastauksiin. Ohjaamaton oppiminen etsii rakenteita datasta ilman tavoitelappuja. Ero ei ole siinä, kumpi lähestymistapa on älykkäämpi tai tarkempi; vaan siinä, millaista oppimissignaalia on saatavilla ja mitä kysymystä järjestelmä on suunniteltu vastaamaan.
Nämä ovat kaksi keskeistä paradigmaa koneoppimisessa, mutta nykyaikaiset järjestelmät hyödyntävät myös puoliksi ohjattua, itseohjattua ja vahvistusoppimista.
Keskeiset havainnot
- Ohjattu oppiminen ennustaa tunnettua tavoitetta; ohjaamaton oppiminen löytää kuvioita tai esityksiä.
- Luokittelu ja regressio ovat ohjattuja tehtäviä; ryhmittely, tiheysestimaatio ja monet ulottuvuudenvähennysmenetelmät ovat ohjaamattomia.
- Ohjaamattomat tulokset eivät automaattisesti ole todellisia luokkia, ja niiden arviointi voi olla vaikeampaa.
- Laskentakustannus ja tarkkuus riippuvat algoritmista, datasta, tehtävästä ja arvioinnista – eivät pelkästään paradigmosta.
Kuinka ohjattu oppiminen toimii
Ohjatussa aineistossa on piirteet X ja tavoite y. Koulutus säätää mallia niin, että sen ennusteet lähestyvät tavoitteita. Arviointi käyttää erillisiä merkattuja esimerkkejä arvioidakseen, kuinka hyvin malli yleistyy.
Luokittelu
Luokittelu ennustaa kategorian: roskaposti tai ei roskaposti, yksi asiakirjan aihe useista, tai yksi tai useampi kohde kuvassa. Relevantteja mittareita ovat tarkkuus (precision), palautus (recall), F1, kalibrointi ja kustannusherkät mittarit. Tarkkuus voi olla harhaanjohtavaa, jos yksi luokka on harvinainen; sekaannusmatriisi paljastaa, mitkä luokat sekoittuvat.
Regressio
Regressio ennustaa jatkuvan arvon, kuten kysynnän, keston tai lämpötilan. Lineaarinen regressio voi käyttää yhtä tai useita piirteitä; se ei rajoitu kahden muuttujan välisen suhteen piirtämiseen. Regressiomittareita ovat keskimääräinen absoluuttinen virhe, neliöjuurinen keskineliövirhe ja tehtäväkohtaiset kustannukset.
Yleisiä ohjattuja algoritmeja
Ohjattuihin menetelmiin kuuluvat lineaariset ja logistiset mallit, päätöspuut, satunnaismetsät, gradienttivahvistus, tukivektorikoneet, K-lähimmän naapurin ja neuroverkot.
Logistinen regressio tuottaa pisteen tai todennäköisyyden, joka voidaan muuntaa luokaksi valitun kynnyksen avulla. Päätöspuun lehti sisältää ennusteen piirreavaruuden alueen perusteella, ei välttämättä yhtä koulutusesimerkkiä. KNN ennustaa lähialueen merkattujen koulutusesimerkkien perusteella ja vaatii edelleen kunnollisen koulutus/validointi/testi-suunnitelman.
Kuinka ohjaamaton oppiminen toimii
Ohjaamaton oppiminen saa piirteet ilman tavoitekenttää. Sen tavoite määritellään epäsuorasti – esimerkiksi minimoida etäisyys klustereiden sisällä, rekonstruoida syöte, arvioida datan tiheys tai säilyttää mahdollisimman paljon varianssia vähemmässä määrässä ulottuvuuksia.
Ryhmittely
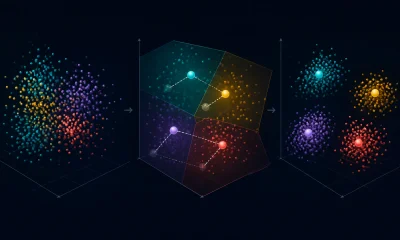
K-means sijoittaa pisteet valittuun määrään klustereita ja päivittää klusterikeskipisteet vähentääkseen klusterin sisäistä neliöetäisyyttä. Algoritmi löytää geometrisia ryhmiä tietyn etäisyys- ja piirreesityksen perusteella. Nämä ryhmät eivät automaattisesti vastaa merkityksellisiä asiakastyyppejä, diagnooseja tai muita alakohtaisia tunnisteita.
Ulottuvuudenvähennys
Ulottuvuudenvähennys esittää dataa käyttäen vähemmän muuttujia. Pääkomponenttianalyysi löytää ortogonaaliset suunnat, jotka säilyttävät mahdollisimman paljon varianssia lineaarisen projektion alla. Muut menetelmät säilyttävät erilaisia rakenteen käsitteitä ja voivat tuottaa hyvin erilaisia visualisointeja.
Poikkeavuus- ja tiheysestimaatio
Ohjaamattomat menetelmät voivat arvioida, missä data on tiheää, ja merkitä epätavallisia havaintoja. Poikkeavuuspisteet eivät todista petosta, vikaa tai haitallista käyttäytymistä; ne tunnistavat poikkeaman valitun esityksen ja mallin perusteella.
Miten ohjaamatonta oppimista arvioidaan
Ei ole olemassa yleistä käsitettä ohjaamattomasta “tarkkuudesta”. Käyttäjä voi käyttää sisäisiä mittareita, kuten siluettipistettä, vertailla vakautta eri otoksissa, testata hyödyllisyyttä myöhemmässä tehtävässä tai kysyä alansa asiantuntijoilta, onko löydetty rakenne merkityksellinen. Jos arviointiin on olemassa totuustiedot, ulkoisia klusterointimittareita voidaan käyttää ilman, että koulutusprosessi muuttuu ohjatuksi oppimiseksi.
Kahden väittämän vertailun yli
Puoliksi ohjattu oppiminen
Puoliksi ohjattu oppiminen yhdistää pienen merkattujen esimerkkien joukon suurempaan merkkaamattomaan joukkoon. Esimerkkeinä ovat pseudo-merkintä, johdonmukaisuussäännöstö ja graafipohjaiset menetelmät. Merkkaamattoman datan on silti oltava riittävän lähellä kohdejakaumaa ollakseen hyödyllinen.
Itseohjattu oppiminen
Itseohjattu oppiminen johdattaa tavoitteet suoraan syötteestä, esimerkiksi ennustamalla maskattuja merkkejä tai sovittamalla muunnettuja näkymiä. Se on perusta nykyaikaisille kieli-, näkö- ja multimodaalisille malleille, mukaan lukien transformerit.
Vahvistusoppiminen
Vahvistusoppiminen optimoi päätöksiä vuorovaikutuksen tuottamien palkkioiden avulla. Se eroaa sekä merkityistä ennusteista että staattisesta kuvioiden löytämisestä.
Oikean lähestymistavan valinta
Aloita järjestelmän tuottamasta päätöksestä tai oivalluksesta. Jos luotettavat tavoitteet ovat olemassa ja tavoitteena on ennustaminen, ohjattu oppiminen on luonnollinen valinta. Jos tavoite on tutkiminen, esitys tai ryhmittely, ohjaamaton menetelmä voi sopia. Kun merkinnät ovat harvassa, itseohjattu tai puoliksi ohjattu esikoulutus, jota seuraa ohjattu arviointi, voi olla tehokkaampi.
Jokaisessa tapauksessa datavuoto, vinoutunut otanta, heikot välittäjät ja jakauman siirtymä voivat hallita algoritmin valintaa. Teknisesti oikea malli, joka on koulutettu väärällä tavoitteella, voi silti epäonnistua.
Oppimissignaalit, tavoitteet ja edustavat menetelmät
Ohjattu oppiminen käyttää esimerkkejä, jotka on yhdistetty tavoitelappuihin tai arvoihin, ja optimoi ennusteen virheen. Luokittelu, regressio, sijoittelu ja strukturoitu ennustus eroavat tuloksessa ja häviössä. Ohjaamaton oppiminen etsii rakennetta ilman tavoitelappuja klusteroinnin, tiheysestimaation, ulottuvuudenvähennyksen, esityksen oppimisen tai generatiivisen mallintamisen avulla. Itseohjattu oppiminen luo ennustustavoitteet datasta itse, kun taas puoliksi ohjattu oppiminen yhdistää pienen merkattujen esimerkkien joukon suurempaan merkkaamattomaan dataan. Nämä kategoriat kuvaavat oppimissignaalia; sama neuroarkkitehtuuri voidaan kouluttaa useiden paradigmajen alla.
Laput tekevät tavoitteesta eksplisiittisen, mutta ne tuovat mukanaan merkintäkustannuksia, kohinaa, politiikkaoletuksia ja aikaviivettä. Merkkaamaton data on helpompi kerätä, mutta se ei kerro algoritmille, mikä löydetty rakenne on hyödyllinen. Klusteri voi heijastaa valaistusta, asiakirjan pituutta tai hankintalähdettä sen sijaan, että se olisi merkityksellinen luokka. Määritä arviointi itsenäisesti: ohjatut mallit käyttävät erillisiä merkattuja tuloksia, kun taas ohjaamattomat mallit tarvitsevat vakautta, rekonstruointia, todennäköisyyttä, hakua, myöhempää hyödyllisyyttä tai asiantuntijavalidaatiota. Pelkkä visuaalinen erottelu ei ole todiste kelvollisesta rakenteesta.
Paradigman valinta ja yleisten virheiden ehkäiseminen
Käytä ohjattua oppimista, kun on olemassa vakaa tavoite ja edustavat laput. Käytä ohjaamatonta tutkimista tiivistämään, havaitsemaan uutuuksia, pakkaamaan tai luomaan hypoteeseja, mutta käsittele tuloksia tilapäisinä. Itseohjattu esikoulutus on arvokasta, kun raakadataa on runsaasti ja myöhemmät tehtävät jakavat esityksiä. Puoliksi ohjatut menetelmät auttavat vain, kun oletukset merkkaamattomasta datasta ja luokkarakenteesta pitävät paikkansa. Vertaa yksinkertaisiin perusvertailuihin ja ota huomioon koko keräys-, merkintä-, tarkastus-, laskenta- ja virhekustannus sen sijaan, että oletat merkkaamattoman automaattisesti olevan halpa.
Estä vuoto erottelemalla liittyvät entiteetit ennen labelien, augmentaation tai pseudo-labelien muodostamista. Seuraa luokkatasapainoa, merkintäyhteensopivuutta, klusterin vakautta, romahtamista ja siirtymää. Pseudo-labelit voivat vahvistaa varhaisia virheitä; klusterointi voi koodata herkkiä ominaisuuksia; esikoulutettu esitys voi siirtää lähdevinoumia. Ihmisen tarkastuksen tulisi keskittyä reunatapauksiin ja seurauksiin. Tuotannossa dokumentoi, miten oppimissignaali luotiin ja milloin se vanhenee. Paradigma määrää, missä valvonta tulee järjestelmään, ei sitä, ovatko ihmisen valinnat ja arvot läsnä.
Käytännön esimerkki: tukiaiheiden löytäminen ja merkkaaminen
Yritys käyttää aluksi ohjaamattomia upotuksia ja klusterointia tutkiakseen teemoja anonymisoiduissa tukiviesteissä. Analyytikot tarkastelevat edustavia ja reunatapauksia ja huomaavat, että jotkut klusterit heijastavat viestin pituutta ja kanavaa eikä ongelmia. He kehittävät ohjatun taksonomian tuntemattomalla luokalla, merkintäohjeistuksella ja mitatulla sopivuudella. Luokittelijaa arvioidaan myöhemmillä aikaväleillä, kielillä ja tuotteilla verrattuna avainsana- ja lähimmän naapurin perusvertailuihin.
Merkkaamattomat uudet viestit tukevat poikkeamien havaitsemista, mutta eivät automaattisesti uudelleenkouluta luokittelijaa. Tarkastajat merkkaavat valittuja epävarmoja ja nousevia tapauksia aktiivisen oppimisen avulla, laadun tarkistuksilla ja suljetulla arviointijoukolla. Seuranta seuraa aiheiden yleisyyttä, luottamusta, erimielisyyttä ja ohjaustuloksia. Kun uusi tuote lanseerataan, taksonomia ja alavirtatiimien kapasiteetti päivitetään samanaikaisesti. Työnkulku käyttää ohjaamattomia menetelmiä hypoteesien luomiseen ja ohjattua todistusaineistoa operatiiviseen ohjaukseen.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän epäonnistumisen seuraukset. Perusta toistettavissa oleva peruslinja ja versionoitua arviointijoukkoa ennen hienosäätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakauman siirtymä, riippuvuuksien katkokset, väärinkäyttö sekä ryhmät tai ympäristöt, joille palvelu todennäköisesti puuttuu. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnys, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta nimeä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista seuranta tahallisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määritä hälytyskynnykset ja vastuu, tarkastele sitten todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn säilyvän. Arvioi uudelleen aina, kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Ensisijaiset lähteet