AI:n perusteet
Mitä tukivektorikoneet ovat?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
A tukivektorikone (SVM) on ohjattu oppimismenetelmä, joka löytää päätösrajan, jonka marginaali on mahdollisimman laaja luokkien välillä. Tämän rajan määrittävät koulutusesimerkit ovat tukivektorit.
SVM:t voivat suorittaa lineaarista tai epälineaarista luokittelua, regressiota ja uutuustunnistusta. Ne ovat erityisen hyödyllisiä pienistä‑keskisuurista tietoaineistoista, joissa on informatiivisia piirteitä, mukaan lukien korkean ulottuvuuden harvat data, mutta niiden koulutuskustannus voi käydä epäkäytännölliseksi erittäin suurilla tietoaineistoilla.
Keskeiset havainnot
- SVM maksimoi pienimmän marginaalin rajan ja lähimpien koulutuspisteiden välillä.
- Tukivektorit ovat datapisteitä, eivät lisähyperpintoja.
- Parametri C tasapainottaa marginaalin leveyden rangaistusten kanssa, jotka aiheutuvat rikkomuksista.
- Kernelit laskevat samankaltaisuuden implisiittisessä piirreavaruudessa ilman, että jokainen muunnettu piirre täytyy materialisoida erikseen.
Maksimi‑marginaalinen ajatus
Lineaariselle binääriluokittelijalle päätösraja on hyperpinta:
w · x + b = 0
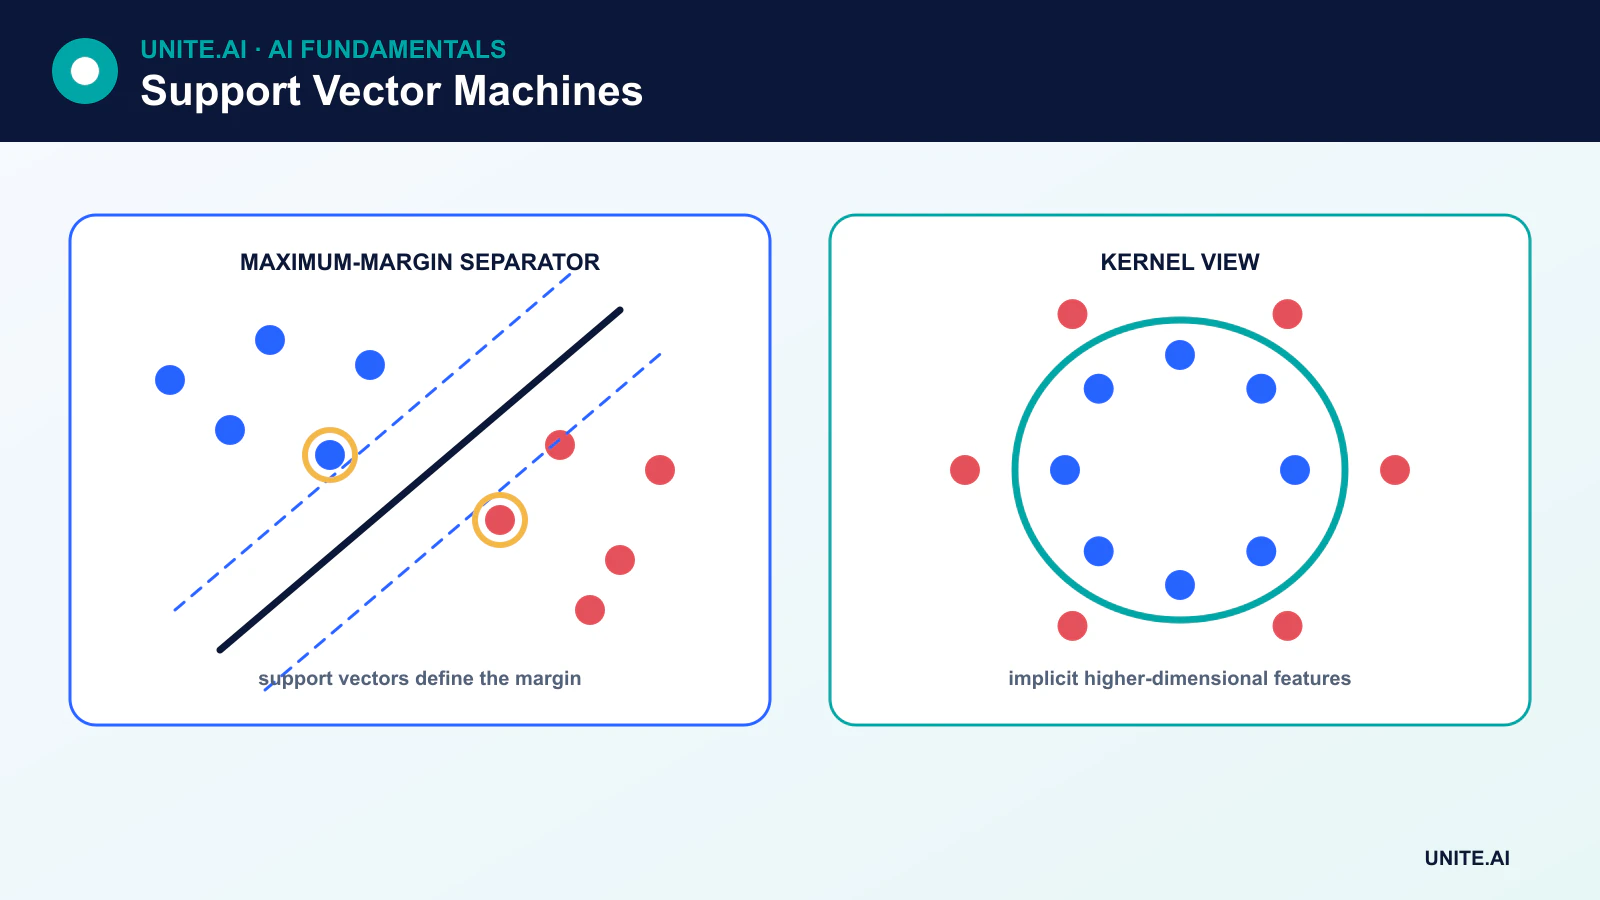
Vektori w määrittää suunnan ja b siirtymän. Useita hyperpintoja voi erottaa koulutusluokat. SVM valitsee sen, joka maksimoi etäisyyden lähimpiin esimerkkeihin kummallakin puolella. Nämä lähimmät esimerkit ovat tukivektoreita ja niillä on suurin vaikutus sovitettuun rajaan.
Tavoitteena ei ole maksimoida etäisyyttä rajasta jokaiselle pisteelle erikseen. Se maksimoi pienimmän marginaalin täyttäen tai rankaiseen luokkarajoitteet.
Kovat ja pehmeät marginaalit
Kova‑marginaalinen SVM vaatii täydellisen lineaarisen erottelun ja on herkkä poikkeaville havainnoille. Todelliset tietoaineistot tarvitsevat yleensä pehmeän marginaalin, joka lisää joustomuuttujia havainnoille marginaalin sisällä tai väärällä puolella rajoja.
Hyperparametri C hallitsee näiden rikkomusten rangaistusta:
- Suurempi C rankaisee rikkomuksia voimakkaammin ja tuottaa usein kapeamman marginaalin, joka seuraa koulutusesimerkkejä tarkemmin.
- Pienempi C sallii enemmän rikkomuksia laajemman, säännöllistetymmän marginaalin kustannuksella.
Tukivektoreiden määrä on datan ja ratkaisun tulos; C:n kasvattaminen ei takaa tiettyä tukivektorien lukumäärää.
Kernelin temppu
Joitakin luokkia ei voida erottaa suoralla hyperpinnalla alkuperäisessä piirreavaruudessa. Kernel laskee sisätulon, joka vastaa toista piirreavaruutta. Tämä mahdollistaa SVM:n sovittaa epälineaarisen rajan ilman, että jokainen muunnettu koordinaatti täytyy laskea erikseen.
Yleisiä kernellejä ovat:
- Lineaarinen: tehokas korkean ulottuvuuden harvoille piirteille, kuten teksti.
- Polynominen: mallintaa vuorovaikutuksia valittuun asteeseen asti.
- Radiaalinen perusfunktio (RBF): luo joustavia paikallisia rajoja etäisyyden perusteella.
- Sigmoid: muistuttaa neuroaktiivisuutta, mutta ei ole yleisesti oletusvalinta.
RBF‑SVM:ssä gamma hallitsee, kuinka paikallisesti kukin koulutusesimerkki vaikuttaa rajaan. Suuri gamma voi luoda erittäin yksityiskohtaisia alueita ja ylisovittaa; pieni gamma tuottaa tasaisemman vaikutuksen.
Moniluokkaluokittelu
Klassinen SVM‑tavoite on binäärinen. Kirjastot laajentavat sitä strategioilla, kuten yksi‑vs‑kaikki, jossa koulutetaan yksi luokitin per luokka, tai yksi‑vs‑yksi, jossa koulutetaan luokittimet luokkaparien välillä ja yhdistetään niiden päätökset. Moniluokka‑SVM:t eivät vain piirrä yhtä vähemmän viivaa kuin luokkien määrä.
Tukivektoriregressio ja yhden luokan SVM
Tukivektoriregressio (SVR) sovittaa funktion ohittaen epsilon‑leveän putken sisäiset virheet ja rankaisten suurempia poikkeamia. Yhden luokan SVM arvioi rajan tyypillisen datan ympärille ja voi tukea uutuustunnistusta. Epätavallinen piste ei ole automaattisesti petos tai vika; se on epätavallinen sovitetun esityksen perusteella.
Käytännön vaatimukset
SVM:t riippuvat etäisyyksistä ja sisätuloksista, joten numeeriset piirteet täytyy yleensä skaalata. C, kernel, gamma ja luokkapainot tulee valita validoinnin avulla. Todennäköisyysarviot eivät ole marginaalin sisäänrakennettuja ja usein vaativat kalibrointia, mikä lisää kustannuksia ja tulisi arvioida erikseen.
Kernel‑SVM:n koulutus voi skaalata neliö‑ tai kuutio‑aikavaativuudessa näytteiden määrän mukaan, riippuen datasta ja toteutuksesta. Lineaariset SVM‑variantit tai stokastiset lineaariset mallit soveltuvat paremmin erittäin suuriin tietoaineistoihin. Raakakuville, äänelle tai kielelle syväoppimisen oppimat esitykset voivat olla tehokkaampia, vaikka SVM voi edelleen luokitella kiinteän upotuksen.
SVM:n vahvuudet ja rajoitukset
SVM:t voivat toimia hyvin monien piirteiden kanssa, tarjoavat selkeän säännöstellyn tavoitteen ja riippuvat enimmäkseen tukivektoreista ennustamisvaiheessa. Rajoituksiin kuuluvat herkkyys skaalaamiselle ja hyperparametreille, mahdollisesti kalliit koulutukset, heikentynyt tulkittavuus epälineaaristen kernelien alla sekä todennäköisyyden kalibrointivaatimukset.
Marginaalit, kernelit ja optimointitavoite
Tukivektorikone pyrkii erottavaan hyperpintaan, jossa on suuri marginaali luokkien välillä. Vain marginaalin sisällä tai sen päällä olevat tukivektorit määrittävät rajan. Pehmeä‑marginaalinen SVM lisää joustoa päällekkäisyyksille ja väärin merkityille pisteille; parametri C vaihtaa laajemman marginaalin ja koulutusrikkomusten välillä. Syötteet tulisi yleensä skaalata, koska etäisyydet ja pistetulokset ohjaavat ratkaisua. Luokkapainot tai uudelleennäytteistys auttavat, kun virhekustannukset ja yleisyys eivät ole tasapainossa, mutta kynnysarvot ja todennäköisyydet vaativat edelleen itsenäistä validointia.
Kernelin temppu arvioi samankaltaisuuden ikään kuin syötteet olisi kartoittanut korkeampidimensionaaliseen piirreavaruuteen. Lineaariset, polynomiset, radiaalisen perusfunktion ja erikoiskernelit koodaavat erilaisia oletuksia. RBF‑kernelissä gamma hallitsee, kuinka paikallisesti kukin piste vaikuttaa rajaan: suuri gamma voi luoda monimutkaisia alueita ja ylisovittaa, kun taas pieni gamma voi alisovittaa. Kernelimatriisit kasvavat neliöisesti näytemäärän myötä, mikä tekee epälineaarisista SVM:istä kalliita suurilla tietoaineistoilla. Lineaariset ratkaisut tai likimääräiset piirrekartat ovat usein suositeltavampia mittakaavassa.
Moniluokkakäyttö, kalibrointi ja operatiiviset rajoitukset
Binäärit SVM:t laajennetaan moniluokiksi yhden‑vs‑kaikki, yhden‑vs‑yksi tai rakenteellisten mallien avulla. Hyperparametrit täytyy virittää ristiinvalidoinnin sisällä, ryhmitellyillä tai aikapohjaisilla jaoilla tarvittaessa. Arvioi luokko‑kohtaiset tarkkuus ja palautus, marginaalijakaumat, kalibrointi ja suorituskyky siirtymän aikana. Raakat päätöspisteet eivät ole todennäköisyyksiä; Platt‑skaalaus tai isotonaalinen kalibrointi käyttää erillistä dataa ja voi heikentyä, jos yleisyys muuttuu. Vertaa logistiseen regressioon, puihin ja nykyaikaisiin esityspohjaisiin menetelmiin, kun esikäsittely ja viritys ovat tasapainossa.
Palvelu edellyttää tarkkaa skaalaajaa, piirteiden järjestystä, kernel‑parametreja, tukivektoreita ja luokkakartoitusta. Kernel‑SVM:n ennustekustannus kasvaa tukivektoreiden määrän myötä, joten mittaa latenssia ja muistinkäyttöä realistisilla erillä. Syötteet, jotka ovat kaukana koulutuksen tukivektoreista, voivat silti saada varmoja luokkia; lisää poikkeavuustarkastuksia tai kieltäytymispolitiikka tarvittaessa. Tarkastele virheitä herkissä välillisinä ja tietoaineiston artefakteina. SVM:t pysyvät vahvoina keskikokoisissa, korkean ulottuvuuden ongelmissa, mutta maksimaalinen geometrinen marginaali ei ole todiste syy‑seuraussuhteesta tai turvallisuudesta.
Käytännön esimerkki: SVM harvinaiseen asiakirjojen reititykseen
Oikeudellinen operaatio‑tiimi luokittelee lyhyet hakemukset reitityskategorioihin käyttäen TF–IDF‑piirteitä ja lineaarista SVM:ää. Se jakaa aineiston asian ja ajan mukaan estääkseen mallipohjien vuotamisen, skaalaa luokkapainot tarkastettujen virhekustannusten perusteella ja virittää C:n sisäkkäisessä validoinnissa. Lineaarista mallia verrataan logistiseen regressioon ja transformer‑malliin. Luokko‑kohtainen tarkkuus, palautus, kalibrointi ja tarkastajan työmäärä ovat tärkeämpiä kuin kokonais‑tarkkuus.
Päätöspisteet kalibroidaan erillisellä datalla, ja matalan marginaalin tai tukemattoman kielen asiakirjat ohjataan manuaaliseen käsittelyyn. Palvelu‑artefakti sisältää tokenisoijan, sanaston, painotuksen, mallin, kalibroinnin ja luokkamerkinnän. Valvonta seuraa uusia termejä, kategorioiden yleisyyttä, marginaaleja ja korjattuja reittejä. Asiakirjat ja tukivektorit suojataan, koska tekstipiirteet voivat paljastaa luottamuksellista tietoa. Epälineaarinen kernel hylätään, jos sen pieni laadun parannus ei oikeuta latenssia, muistinkäyttöä ja tulkittavuuskustannuksia.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän virheen seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen viritystä. Testaa tavallisia tapauksia, reunatilanteita, virheellisiä tai puuttuvia syötteitä, jakauman siirtymää, riippuvuuksien katkeamista, väärinkäyttöä sekä ryhmiä tai ympäristöjä, joihin palvelu todennäköisesti jää vajaaksi. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, latenssin, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistolle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tarkoituksellisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määritä hälytyskynnysarvot ja vastuutahot, ja tarkastele todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletettaisiin offline‑suorituskyvyn säilyvän. Arvioi uudelleen aina kun tietolähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulisi poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Suorittavatko SVM:t vain luokittelua?
Ei. Tukivektoriregressio ennustaa jatkuvia kohteita, kun taas yhden luokan SVM voi arvioida uutuusrajan. Jokaisella variantilla on eri tavoite ja hyperparametrien joukko.
Milloin lineaarinen SVM on vahva valinta?
Lineaariset SVM:t ovat usein tehokkaita korkean ulottuvuuden harvoille piirteille, mukaan lukien perinteiset tekstiesitykset, joissa kernel lisäisi kustannuksia ilman selkeää hyötyä.
Ensisijaiset viitteet