AI:n perusteet
Mikä on dimensioiden vähentäminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
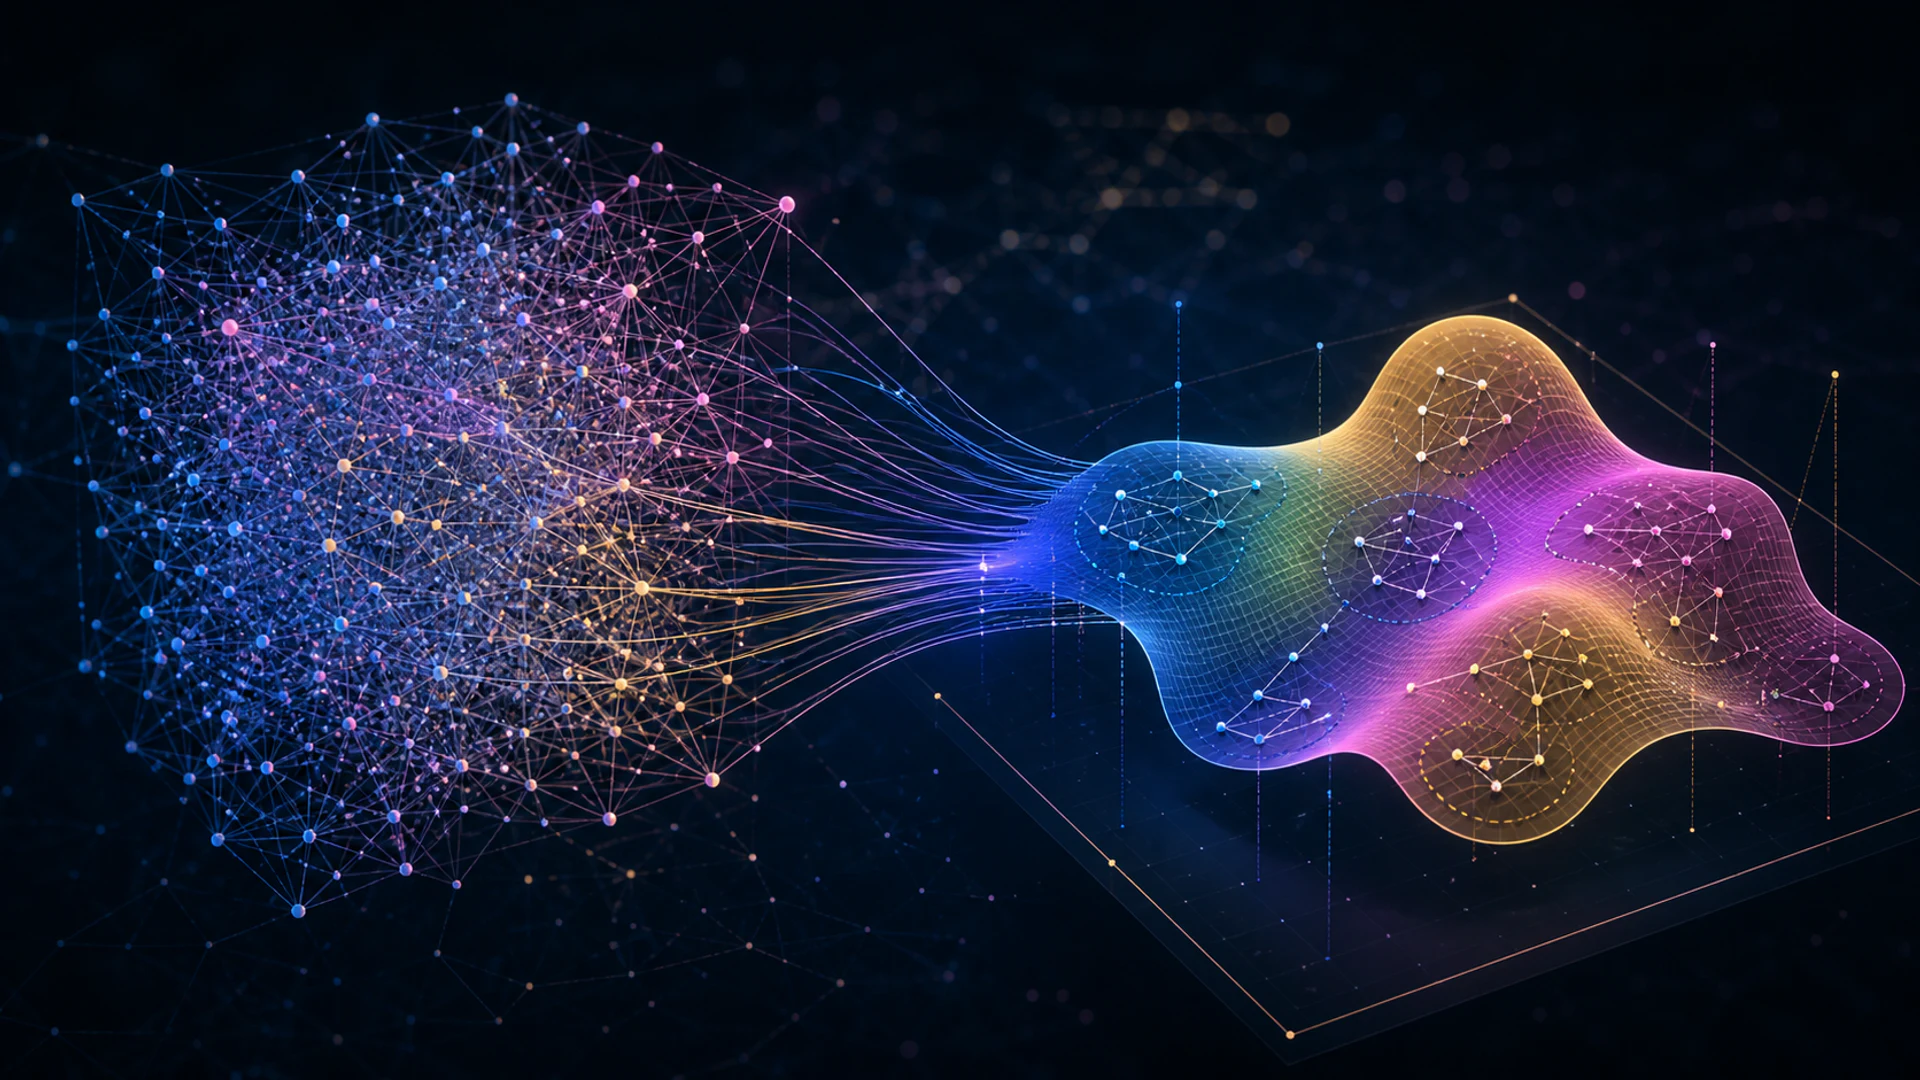
Dimensioiden vähentäminen esittää dataa vähemmän muuttujilla säilyttäen tehtävälle hyödyllisen tiedon. Se voi vähentää tallennustilaa ja kohinaa, parantaa visualisointia, lieventää redundantteja ominaisuuksia ja tehdä myöhemmät mallit helpommin koulutettaviksi.
Yksikään menetelmä ei säilytä kaikkia suhteita. Hyödyllinen vähennys alkaa määrittelemällä, mitä tulisi säilyttää: varianssi, luokkien erotus, paikalliset naapurustot, globaalinen geometria, rekonstruoinnin laatu tai tulkittavuus.
Tärkeimmät havainnot
- Ominaisuuksien valinta säilyttää alkuperäiset muuttujat; ominaisuuksien poiminta luo uudet matalamman dimensioiden koordinaatit.
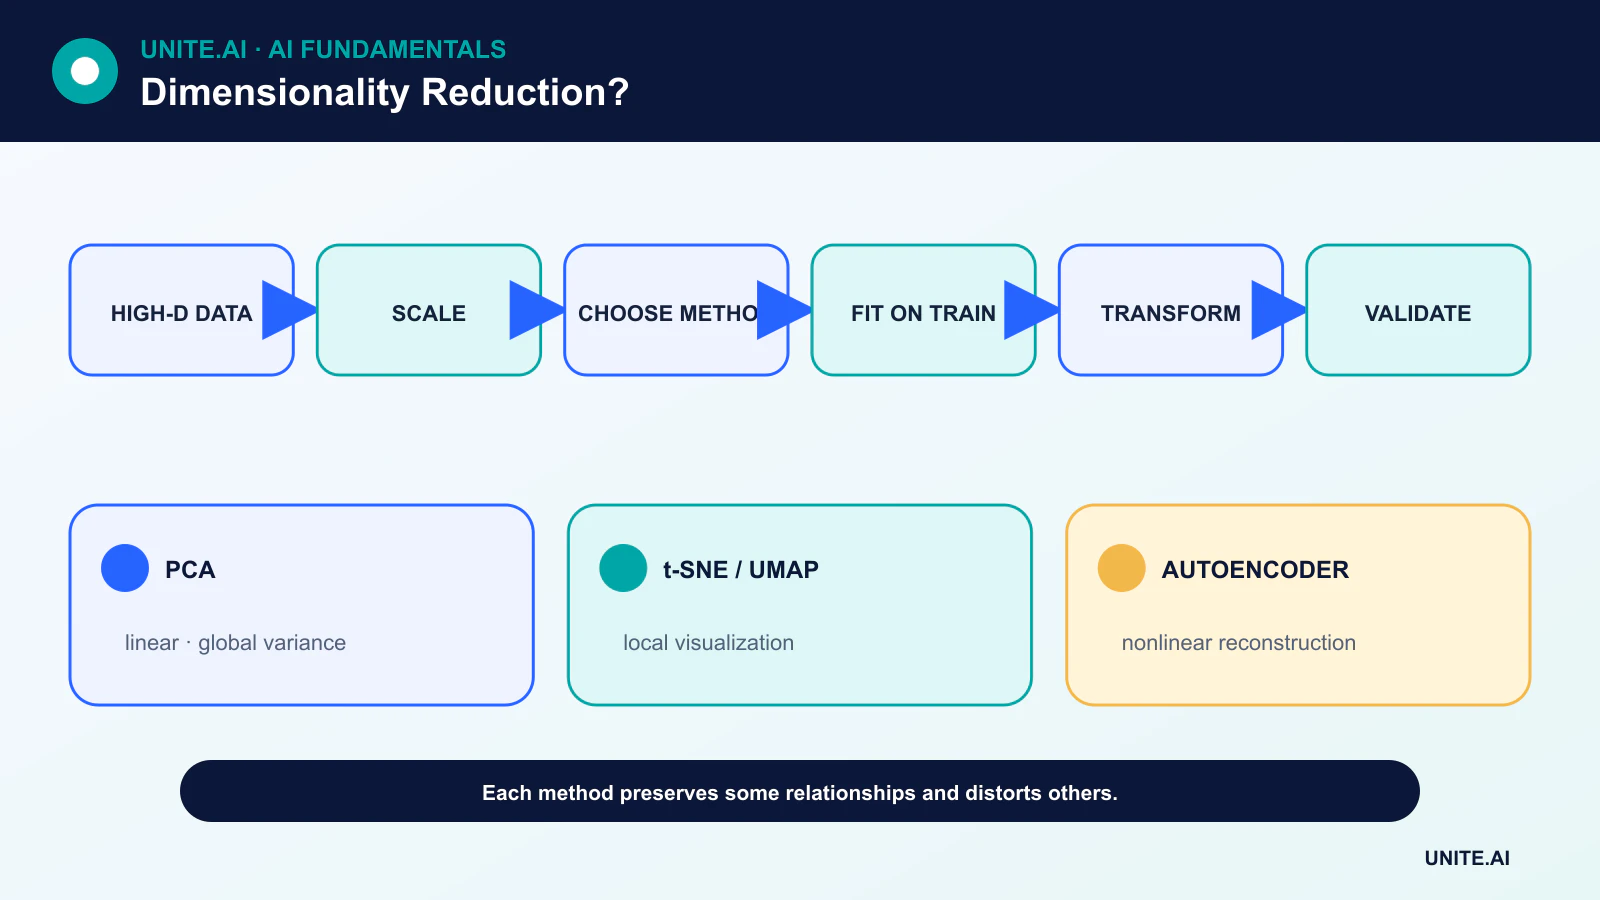
- PCA on lineaarinen ja varianssiin suuntautunut; t‑SNE ja UMAP korostavat naapurustorakennetta visualisointia varten.
- Visualisointiembeddaukset voivat vääristää etäisyyksiä, klusterikokoja ja globaalin erottelun.
- Sovita vähennys vain koulutusdataan ja sen jälkeen käytä opittua muunnosta validointi- ja testidataan.
Ominaisuuksien valinta vs. projekti
Ominaisuuksien valinta poistaa muuttujia käyttäen toimialakohtaisia sääntöjä, puuttuvuutta, redundanssia, ennustavia testejä tai regularisaatiota. Se säilyttää alkuperäiset merkitykset, mikä voi auttaa hallintaa ja selittämistä.
Projektiomenetelmät yhdistävät muuttujat uusiin koordinaatteihin. Ne voivat tallentaa hajautetun rakenteen, mutta voivat tehdä jokaisesta koordinaatista vaikeammin tulkittavan. Autoenkooderi oppii epälineaarisen projektiomuunnoksen rekonstruoinnin kautta.
PCA ja SVD
Pääkomponenttianalyysi (PCA) tunnistaa ortogonaaliset suunnat, joiden varianssi vähenee datan keskittämisen jälkeen. Singular value -hajotelma (SVD) tarjoaa yhteisen numeerisen reitin. Skaalaus on tärkeä: korkean varianssin mittayksikkö voi hallita komponentteja.
PCA on deterministinen lukuun ottamatta merkkiä ja toistuvia ominaisarvoja, tukee otoksen ulkopuolista muunnosta ja tarjoaa selitetyn varianssin yhteenvedot. Korkea varianssi ei aina ole tehtävään liittyvä, eikä lineaariset komponentit pysty avauttamaan kaikkia kaarevia mannifoldeja.
t‑SNE ja UMAP
t‑SNE muodostaa todennäköisyysjakaumat naapureista ja optimoi matalamman dimensioiden kartan, joka korostaa paikallista samankaltaisuutta. UMAP rakentaa painotetun naapurustograafin ja optimoi matalamman dimensioiden esityksen, jossa on samankaltaisia paikallisen rakenteen tavoitteita.
Molemmat ovat voimakkaita tutkimustyökaluja, mutta ne ovat herkkiä esikäsittelylle, etäisyysmetriikalle ja hyperparametreille. Tyhjä tila, klusterialue ja klustereiden välinen etäisyys 2‑D‑kuviossa eivät saa automaattisesti saada todellista tulkintaa.
Ohjattuja menetelmiä ja tehtävästä tietoisia esityksiä
Lineaarinen diskriminanttianalyysi (LDA) käyttää luokkamerkkejä erottelun etsimiseen, mikä tekee siitä erilaisen kuin valvomaton PCA. Neuroverkkojen esitysten oppiminen voi optimoida ennustusta tai kontrastiivisia tavoitteita rekonstruoinnin sijaan.
Jos merkinnät ohjaavat vähennystä, kaikki sovittaminen ja säätö on pidettävä koulutusprosessin sisällä. Muuten testijoukon tieto voi vuotaa mallin valintaan ja luoda optimistisen tuloksen.
Menetelmän valinta ja validointi
Aloita esikäsittelyllä ja yksinkertaisella vertailutasolla. Pakkausta varten mittaa rekonstruointi tai myöhempien mallien suorituskyky eri dimensioissa. Visualisointia varten testaa vakaus eri siemenarvoilla ja hyperparametreilla sekä vertaa naapuruston säilymistä toimialatietoon.
Tuotannossa kysy, pystyykö menetelmä muuntamaan uusia tietueita, miten se käsittelee puuttuvia arvoja, muuttuko se uudelleenkoulutuksen yhteydessä ja tarvitsevatko käyttäjät alkuperäisten ominaisuuksien selityksiä. Yläsovittaminen voi tapahtua vähennysvaiheessa aivan kuten lopullisessa mallissa.
Lineaariset ja epälineaariset vähennysmenetelmät
Dimensioiden vähentäminen kartoittaa korkean dimensioiden datan vähemmän koordinaatteihin säilyttäen valitun rakenteen. Pääkomponenttianalyysi (PCA) löytää ortogonaaliset suunnat, joilla on suurin varianssi keskittämisen jälkeen; skaalaus on tarpeen, kun yksiköiden tulisi vaikuttaa vertailukelpoisesti. Singular value -hajotelma (SVD) laskee siihen liittyvän matalan rankin rakenteen ja tukee harva-matriiseja. Lineaarinen diskriminanttianalyysi käyttää merkintöjä luokkia erottavien suuntien löytämiseen. Nämä menetelmät tarjoavat eksplisiittiset muunnokset, mutta varianssi tai luokkien erotus eivät välttämättä säilytä myöhempään tehtävään tarvittavaa tietoa.
Manifold‑menetelmät kuten t‑SNE ja UMAP muodostavat naapurustoja ja optimoivat matalamman dimensioiden asettelun. Ne ovat tehokkaita tutkimiseen, mutta vääristävät globaalin etäisyyden, tiheyden, klusterikoon ja joskus erottelun. Tulokset riippuvat esikäsittelystä, metriikasta, naapureista tai perplexity‑arvosta, alustusmenetelmästä ja siemenarvosta. Houkutteleva klusteri kahdessa ulottuvuudessa voi syntyä ilman erillisiä ryhmiä. Käytä useita asetuksia, värjää vain metadataa, jota ei ole käytetty sovittamiseen, ja validoi havaittu rakenne alkuperäisessä tilassa tai itsenäisten merkintöjen avulla.
Ominaisuuksien valinta, upotukset ja arviointi
Ominaisuuksien valinta säilyttää alkuperäiset muuttujat suodattimien, wrapperien tai mallipohjaisen tärkeyden avulla; esitysten oppiminen luo uusia latentteja ominaisuuksia autoenkoodereilla tai ohjatuilla malleilla. Satunnaisprojektio säilyttää etäisyydet likimääräisesti tietyin ehdoin ja tarjoaa tehokkaita peruslinjoja. Valitse menetelmä pakkaamisen, visualisoinnin, kohinan vähentämisen, nopeuden, tallennustilan tai mallin suorituskyvyn perusteella. Sovita vähentäjä vain koulutusdataan ja sen jälkeen muunna validointi- ja testijoukot. Ohjattu vähennys on upotettava ristiinvalidointiin, jotta vältetään merkintävahinko.
Arvioi selitettyä varianssia tai rekonstruointia lineaarisessa pakkaamisessa, luotettavuutta ja naapuruston säilymistä visualisoinnissa sekä myöhempää tarkkuutta, kalibrointia, latenssia ja kestävyyttä ennustamisessa. Mittaa vakaus eri näytteissä ja siemenarvoissa. Tarkista, onko harvinaisia luokkia tai herkkiä ryhmiä yhdistetty ja onko käänteinen muunnos mahdollinen. Vähennetyt koordinaatit voivat edelleen sisältää yksityistä tietoa; kaksidimensionaalinen kuva ei ole anonymisointi. Dokumentoi muunnos, skaalaaja, ominaisuuksien järjestys ja rajoitukset.
Tuotantokäyttö
Palvelu vaatii tarkan sovitetun muunnoksen ja syötemallin. Seuraa puuttuvia ominaisuuksia, vaihteluvälin siirtymää, komponenttien pistemäärän jakautumista, rekonstruointivirhettä ja myöhempiä tuloksia. Jos uusia luokkia tai sensoreita ilmenee, kouluta uudelleen ja versioi koko putki sen sijaan, että lisättäisiin sarakkeita hiljaisesti. Vähennys voi parantaa laskentaa ja poistaa kohinaa mallista, mutta se voi myös poistaa heikkoja signaaleja, jotka ovat tärkeitä harvinaisiin tapahtumiin. Kohtele sitä opittuna mittausvaiheena, jonka säilytetty ja menetetty tieto on testattava päätöksen perusteella.
Käytännön esimerkki: asiakaskäyttäytymisen ominaisuuksien vähentäminen
Analyytikko standardisoi 200 käyttäytymismittaria ja sovittaa PCA:n vain koulutusasiakkaisiin. Ristiinvalidointi valitsee komponenttien määrän myöhemmän asiakaspoistuman suorituskyvyn ja vakauden perusteella, ei kahdenulotteisen hajontakuvan perusteella. Latauksia tarkastellaan hallitsevien lähteiden ja puuttuvuuden varalta. PCA, ominaisuuksien valinta, satunnaisprojektio ja vähentämätön regularisoitu malli vertailaan kalibroinnin, latenssin ja harvinaisten asiakassegmenttien tulosten osalta. Toistuvat näytteet testaavat myös, pysyvätkö johtavat komponentit ja myöhemmät johtopäätökset vakaina.
Käyttöönotettu putki lukitsee ominaisuuksien järjestyksen, skaalaajan ja komponentit ja hylkää puuttuvat skeemaversiot. Seuranta seuraa komponenttien jakautumista, rekonstruointivirhettä ja myöhempiä tuloksia. Visualisointia, jossa on ilmeisiä klustereita, käytetään kysymysten luomiseen, ei asiakaspersoonien määrittämiseen. Koska latentit komponentit edelleen koodaavat käyttäytymistä, pääsy ja säilytys pysyvät hallittuna. Jos lähdemäärittelyt muuttuvat, koko muunnos ja malli rakennetaan ja validoidaan uudelleen sen sijaan, että projisoitaisiin yhteensopimattomia tietoja vanhoihin komponentteihin.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja kunkin tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakautumisen siirtymä, riippuvuuden katkos, väärinkäyttö sekä ryhmät tai ympäristöt, joille palvelu todennäköisesti puuttuu. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, latenssin, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua nimeä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palauttamiseen ja elinkaaren lopettamiseen. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja tarkista seuranta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määritä hälytyskynnysarvot ja vastaavan omistaja, tarkastele sitten todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletettaisiin offline-suorituskyvyn jatkuvan. Arvioi uudelleen aina kun tietolähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautuksen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Parantaako dimensioiden vähentäminen aina mallia?
Ei. Se voi poistaa ennustavaa tietoa tai monimutkaistaa tulkintaa. Vertaa ilman vähennystä tehtyä perusmallia pidätettyyn dataan.
Todistavatko erilliset t‑SNE‑klusterit, että todellisia luokkia on olemassa?
Ei. Kartta on optimoitu visualisointi naapurusuhteista, ja se voi luoda näennäisen erottelun. Vahvista klusterit itsenäisellä evidenssillä.
Ensisijaiset lähteet