AI:n perusteet
Mikä on ylisovittaminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Ylisovittaminen tapahtuu, kun malli kaappaa kaavat tai kohinan, jotka toimivat poikkeuksellisen hyvin sen harjoitusdatassa, mutta eivät yleisty uusiin esimerkkeihin. Ylisovitettu malli saattaa saavuttaa erittäin alhaisen harjoitusvirheen, kun taas validointi‑ tai todellisessa maailmassa saavutettu suorituskyky on merkittävästi heikompi.
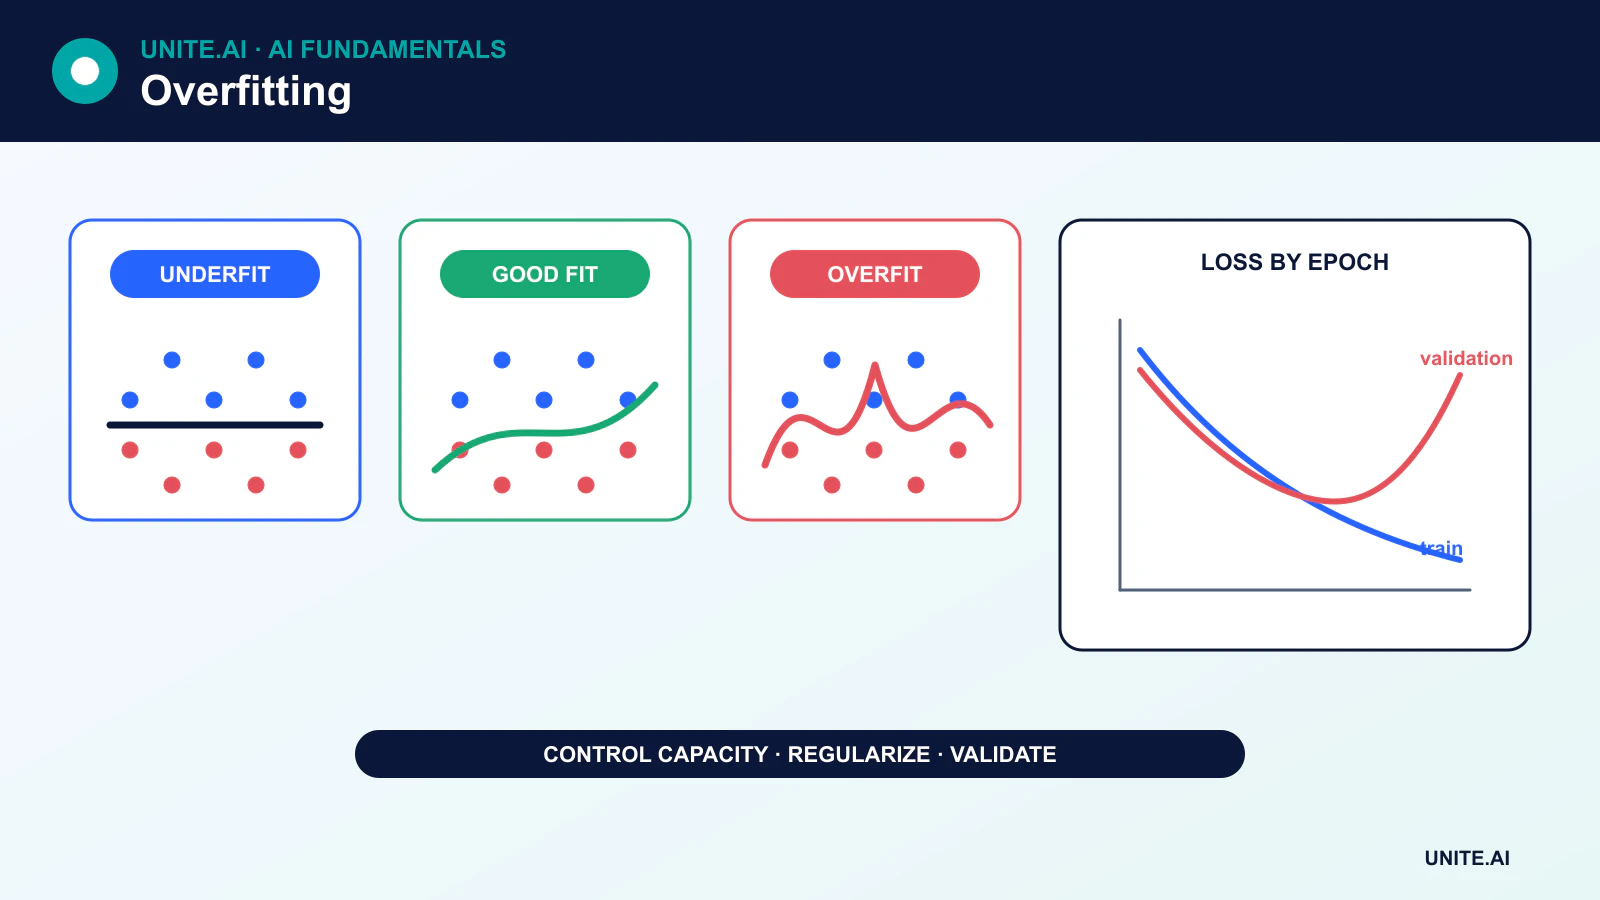
Vastaongelma on alikovittaminen: malli tai harjoitusprosessi ei pysty kaappaamaan riittävästi signaalia edes harjoitusdatassa. Hyvä mallintaminen tasapainottaa sovittamista ja yleistettävyyttä sen sijaan, että pyrittäisiin täydelliseen harjoitusosuuteen.
Keskeiset opit
- Pelkkä harjoitusluonne ei voi diagnosoida yleistettävyyttä.
- Aikainen pysäytys tulisi perustua validointikäyttäytymiseen, eikä tehdä toistuvia päätöksiä lopullisessa testidatassa.
- Lisää dataa voi auttaa, mutta lisää ominaisuuksia tai kapasiteettia voi myös pahentaa ylisovittamista.
- Säännöllistämällä, augmentaatiolla, ristiinvalidoinnilla, vuotojen ehkäisemisellä ja asianmukaisella arvioinnilla voidaan käsitellä erilaisia syitä.
Sovitus, alisovittaminen ja ylisovittaminen
Malli alisovittuu, kun sen oletukset ovat liian rajoittavia, ominaisuudet puuttuvat tärkeästä signaalista, optimointi on puutteellista tai harjoitus on riittämätöntä. Merkityksellisten ominaisuuksien tai kapasiteetin lisääminen voi auttaa, mutta satunnaisten ominaisuuksien lisääminen voi kasvattaa kohinaa ja ylisovittamista.
Malli ylisovittuu, kun sen tehokas kapasiteetti on liian suuri suhteessa harjoitusdatan informaatioon. Esimerkkejä ovat syvä päätöspuu, joka luo pieniä lehtiä, polynomi, joka seuraa satunnaisia vaihteluita, tai neuroverkko, joka muistaa esimerkit.
Harjoitus-, validointi- ja testidatan rooli
- Harjoitusdata sovittaa mallin parametrit.
- Validointidata valitsee arkkitehtuurin, hyperparametrit, kynnysarvot ja pysäytysajankohdan.
- Testidata tarjoaa lopullisen arvion näiden valintojen jälkeen.
Jos testidataa käytetään toistuvasti päätöksenteossa, siitä tulee osa kehitysprosessia eikä se enää anna puolueetonta lopullista arviota. Ristiinvalidointi voi käyttää rajallista dataa tehokkaammin, mutta kaikki esikäsittely ja ominaisuuksien valinta on toteutettava jokaisessa harjoituskierroksessa.
Aikainen pysäytys
Harjoituksen aikana harjoitusvirhe yleensä jatkaa alenemistaan. Validointivirhe voi aluksi laskea ja myöhemmin nousta, kun malli erikoistuu harjoituskohinaan. Aikainen pysäytys tallentaa tarkistuspisteen, jossa validointitavoite on paras, tai pysäyttää, kun validointi ei ole parantunut määrätyn kärsivällisyysjakson aikana.
Oikea tarkistuspiste ei ole alhaisin harjoitusvirhe. Erillinen lopullinen testidatasetti arvioidaan aikaisen pysäytyksen ja säätöpäätösten jälkeen.
Säännöllistämismenetelmät
Painon rangaistukset
L2‑säännöllistäminen tai painon hajoitus estää suuria parametriarvoja. L1‑säännöllistäminen voi kannustaa harvoihin kertoimiin. Niiden vaikutukset riippuvat mallista ja optimointimenetelmästä; esimerkiksi AdamW irrottaa painon hajoituksen adaptiivisesta päivityksestä.
Dropout ja stokastinen säännöllistäminen
Dropout peittää satunnaisesti aktivoinnit harjoituksen aikana. Muita menetelmiä ovat polkujen pudottaminen, ominaisuuksien häiritseminen tai etikettien tasoitus. Nämä tekniikat muuttavat harjoitustavoitetta ja on poistettava käytöstä tai käsiteltävä asianmukaisesti inferenssin aikana.
Datan augmentaatio
Augmentaatio luo todentuntuisia variaatioita — kuten leikkauksia, kiertoja, kohinaa tai parafraaseja — joiden tulisi säilyttää kohde. Virheelliset muunnokset voivat muuttaa etikettiä ja vahingoittaa mallia. Kuvankäsittelyssä työkalut, kuten Albumentations, auttavat toteuttamaan hallittuja putkistoja.
Kapasiteetin säätö
Matalammat puut, vähemmän parametreja, ominaisuuksien valinta, karsiminen ja yksinkertaisemmat hypoteesiluokat voivat vähentää varianssia. Puiden karsiminen perustuu kriteereihin, eikä ole satunnaista oppineen tiedon poistamista.
Datan vuoto voi näyttää poikkeukselliselta suorituskyvylta
Vuoto tapahtuu, kun ennustamisajankohtana ei‑saatavilla oleva tieto pääsee harjoitus‑ tai arviointivaiheeseen. Yleisiä esimerkkejä ovat normalisoinnin sovittaminen koko dataan, toistuvien tietueiden jakaminen eri kierteisiin, tulevan tiedon käyttäminen menneen ennustamiseen tai ominaisuuden sisällyttäminen, joka on johdettu kohteesta.
Vuoto ei ole tavallinen ylisovittaminen, mutta se luo saman harhaanjohtavan aukon offline‑tulosten ja tuotantoon siirtymisen välillä. Jako‑strategian on otettava huomioon aika, identiteetti, sijainti ja datan luontiprosessit.
Jakautuman siirtymä on erillinen ongelma
Malli voi yleistää testijakaumaansa, mutta silti epäonnistua, kun tuotantodata muuttuu. Uudet laitteet, politiikat, väestöt, kaudet tai vastustava käyttäytyminen voivat siirtää syötteen tai kohteen välistä suhdetta. Seuranta ja säännöllinen uudelleenarviointi ovat tarpeen, vaikka alkuperäinen malli ei olisi ylisovittanut.
Ylisovittamisen diagnosointi
Käytä oppimisvirtoja, ristiinvalidoinnin varianssia, alaryhmämittareita, kalibrointia ja virheiden tarkastelua. Jos sekä harjoitus- että validointisuoritus on heikko, keskity alisovittamiseen, ominaisuuksiin, etiketöintiin tai optimointiin. Jos harjoitus on vahva ja validointi heikko, tutki kapasiteettia, vuotoja, säännöllistämistä ja edustavuutta ennen kuin keräät vain lisää dataa.
Miksi ylisovittaminen tapahtuu ja miten se havaitaan
Ylisovittaminen tapahtuu, kun malli oppii kaavoja, jotka vähentävät harjoitusvirhettä, mutta eivät yleisty kohdepopulaatioon. Syitä ovat liiallinen kapasiteetti suhteessa tehokkaaseen dataan, etikettikohina, toistuvat entiteetit, joustava ominaisuuksien valinta, vuoto ja säätö samassa validointidatassa. Laajeneva aukko harjoitus- ja validointisuorituksen välillä on yleinen todiste, mutta pieni aukko ei sulje pois ylisovittamista, jos molemmat joukot jakavat kontaminaation tai poikkeavat tuotannosta. Oppimisvirrat eri datamäärien ja kapasiteetin suhteen auttavat erottamaan varianssin ja vinouden.
Vuoto on erityisen harhaanjohtava: tuleva tieto, kaksoiskappaleet, kohteiden päällekkäisyys, esikäsittelyn sovittaminen kaikkiin dataan tai metatietoon koodatut etiketit voivat tuottaa erinomaisia erillistuloksia. Jaa data sen yksikön mukaan, joka on uusi tuotannossa — potilas, asiakas, kone, sijainti tai aika — ennen kuin sovitat muunnoksia tai augmentaatioita. Pidä lopullinen testidatasetti suljettuna ominaisuuksia, arkkitehtuuria ja kynnysarvoja valittaessa. Jos tiimit tarkastelevat testituloksia toistuvasti, testidatasetti muuttuu toiseksi validointidatasetiksi ja se on korvattava tai korjattava formaalilla tavalla.
Säännöllistäminen, mallin valinta ja tuotantodrifti
Vähennä ylisovittamista edustavammalla datalla, alhaisemmalla kapasiteetilla, painon hajoituksella, dropoutilla, aikaisella pysäytyksellä, augmentaatiolla, yhdistämisellä tai rajoitteilla, jotka heijastavat toimialan rakennetta. Jokaisella menetelmällä on omat kompromissinsa: augmentaatio voi vääristää etikettejä, dropout muuttaa optimointia, ja yhdistelmät lisäävät palvelukustannuksia. Ristiinvalidointi arvioi valinnan vaihtelua, mutta ryhmitellyt tai aika‑herkät kierteet on toteutettava niin, että ne säilyttävät tuotantorajan. Vertaa yksinkertaiseen malliin ja raportoi epävarmuus kierteiden tai siementen välillä sen sijaan, että valitsisit edullisimman suorituksen.
Tuotanto voi paljastaa erilaisen yleistymisvirheen, kun syötteet, käyttäjät, kannustimet tai mittaus muuttuvat. Seuraa ominaisuuksien ja ennusteiden jakautumia, kalibrointia, alaryhmien tuloksia ja viivästynyttä totuustietoa. Älä automaattisesti uudelleenkouluta tarkistamattomasta palautteesta; mallin omat päätökset voivat muokata myöhemmin näkemäänsä etikettiä. Diagnoi, johtuuko epäonnistuminen drifti‑, data‑putki‑, politiikka‑tai kelvottomasta kohteesta. Ylisovittaminen on kokeilusuunnittelun ja elinkaaridisciplinan hallittavissa, ei yhden säännöllistämisasetuksen ratkaistavissa.
Käytännön esimerkki: vuotojen poistaminen petosmallissa
Alkuperäinen petosluokitin sai poikkeuksellisen hyvät pisteet, koska toistuvat kortti‑ ja kauppias‑tapahtumat esiintyivät satunnaisesti harjoitus‑ ja testiriveissä, ja peruutustiedot, jotka on kirjattu viikkoja myöhemmin, sisällytettiin ominaisuutena. Tiimi rekonstruoi jokaisen ominaisuuden saatavuusajan, poisti päätöksen jälkeiset kentät, ryhmitti tilit ja käytti eteenpäin suuntaavaa aikajaksoa. Suorituskyky laski jyrkästi, mutta nyt se arvioi todellista päätöstä. Yksinkertainen sääntöperuste ja oppimisvirrat ohjaavat tarvittavaa mallin monimutkaisuutta.
Säännöllistämistä ja aikaisen pysäytyksen säätöä tehtiin vain historiallisten kierteiden sisällä. Lopullinen arviointi raportoi tarkkuuden tarkistuskapasiteetissa, recall‑arvon, kalibroinnin ja kustannuksen petostyypin sekä asiakassegmentin mukaan. Tuotannossa vahvistetut etiketit saapuvat myöhässä ja ovat puolueellisia sen perusteella, mitkä transaktiot tarkasteltiin, joten seuranta erottaa piste‑drifti‑arvion todellisista tuloksista. Uudelleenkoulutus käyttää käsiteltyjä tapauksia ja toistamista nykyistä politiikkaa vastaan. Projekti suosii alhaisempaa, rehellistä pistemäärää korkeampaan, vuotaneeseen pisteeseen, joka ei selviä tuotannossa.
Toteutus- ja operatiivinen valmius
Tuotantopäätös tarvitsee enemmän kuin onnistuneen demonstraation. Määrittele kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän epäonnistumisen seuraus. Perusta toistettavissa oleva perusta ja versionoitua arviointidatasetti ennen säätöä. Testaa tavallisia tapauksia, reunatiloja, virheellisiä tai puuttuvia syötteitä, jakautuman siirtymää, riippuvuuksien katkoja, väärinkäyttöä ja ryhmiä tai ympäristöjä, joilla on suurin riski alipalveluun. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenon, resurssikustannuksen, saavutettavuuden, tietosuojan ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua määritä vastuualueet julkaisulle, poikkeuksille, muutoksille, peruutukselle ja elinkaaren lopettamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista seuranta tahallisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai sääntörivin versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluontoista dataa. Määrittele hälytysrajanarvot ja vastuualue, tarkista sitten todelliset todisteet käyttöönoton jälkeen sen sijaan, että oletettaisiin offline‑suorituskyvyn pysyvän. Arvioi uudelleen aina, kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidetty järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausoppimisen, poistamis‑ ja säilytyskäytännöt sekä selkeän pisteen, jossa se on poistettava tai korvattava.
Usein kysytyt kysymykset
Voiko yksinkertainen malli ylisovittua?
Kyllä. Toistuva ominaisuuksien valinta, kynnysarvon säätö tai arviointi samassa erillisdatassa voi ylisovittaa kehitysprosessin, vaikka lopullinen malli onkin yksinkertainen.
Auttaako aina enemmän harjoitusdata ylisovittamisen ratkaisemisessa?
Ei. Edustavampi, oikein merkattu data voi auttaa, mutta kaksoiskappaleet, puolueelliset, vuotaneet tai toimialan ulkopuoliset tiedot eivät välttämättä. Oppimisobjektiivi ja arviointisuunnittelu ovat edelleen tärkeitä.
Ensisijaiset viitteet