
AI:n perusteet
Mikä on syväoppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Syväoppiminen on koneoppimismenetelmien perhe, joka käyttää useita käsittelykerroksia sisältäviä neuroverkkoja oppiakseen hyödyllisiä tietojen esityksiä. Nämä mallit ohjaavat monia nykyaikaisia järjestelmiä kielen, kuvien, äänen, suositusten, tieteellisen ennustamisen ja generatiivisen tekoälyn alalla.
Sana syvä viittaa syötteen ja tuloksen väliseen muunnosten määrään, ei koneen syvempään ymmärrykseen. Syvä malli oppii numeerisia suhteita, jotka ovat hyödyllisiä sen koulutustavoitteelle, ja sen suorituskyky on silti testattava uusilla tiedoilla.
Keskeiset havainnot
- Syväoppiminen on koneoppimisen alajoukko.
- Kerrokset muuntavat tensoreita oppimien parametrien, epälineaaristen aktivaatioiden, normalisoinnin ja muiden operaatioiden avulla.
- Takaisinsijoitus (backpropagation) laskee gradientit; optimointialgoritmi käyttää näitä gradientteja päivitääkseen opittavia parametreja, mukaan lukien painot ja biasit.
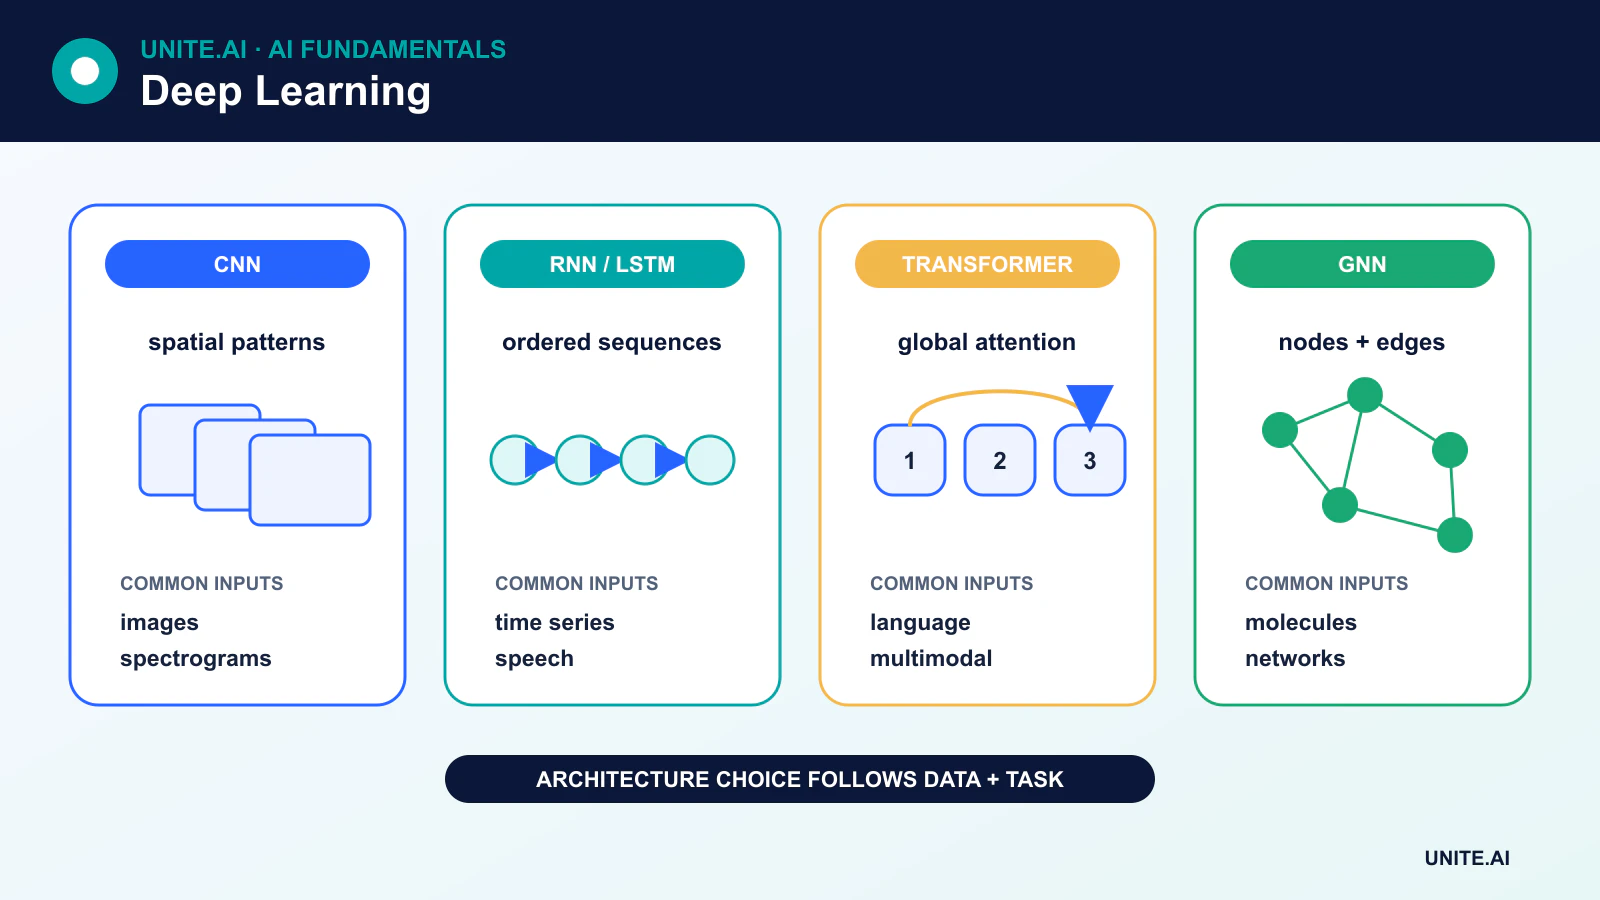
- CNN:t, toistuvat verkot, transformerit, autoenkooderit ja diffuusiomallit omaavat erilaiset rakenteet ja vahvuudet.
Kuinka syvä neuroverkko oppii
Neuroverkko vastaanottaa dataa tensoreina, eli monidimensionaalisina numeroiden taulukoina. Kuvatensori voi sisältää pikselikanavia, kun taas kielimalli käyttää vektoreita, jotka edustavat tokenia. Jokainen kerros suorittaa differentioituvan muunnoksen ja välittää tuloksen seuraavalle kerrokselle.
Perus tiheässä kerroksessa malli laskee syötteidensä painotetun summan, lisää opittavan biasin ja soveltaa sitten aktivaatiofunktion:
output = activation(Wx + b)
Aktivaatiofunktio tuo epälineaarisuutta. Ilman sitä tavallisten lineaaristen kerrosten kasaaminen edustaisi edelleen vain lineaarista muunnosta. ReLU ja sen variantit ovat yleisiä piilokerroksissa, kun taas ulostulon aktivaatio riippuu tehtävästä.
Koulutus noudattaa tyypillisesti neljää vaihetta:
- Eteenpäin kulku tuottaa ennusteita.
- Tappiofunktion avulla mitataan, kuinka ennusteet poikkeavat tavoitteesta.
- Takaisinsijoitus soveltaa ketjusääntöä laskeakseen tappion gradientin jokaiselle opittavalle parametrille.
- Optimointialgoritmi, kuten stokastinen gradienttimenetelmä (SGD) tai AdamW, päivittää parametreja.
Näiden vaiheiden toistaminen monissa erissä voi parantaa mallia, mutta pienempi koulutustappio ei takaa luotettavaa todellisessa maailmassa toimimista. Vahvistus, regularisointi, edustava data ja seuranta ovat edelleen olennaisia.
Merkittävät syväoppimisen arkkitektuurit
Monikerroksiset perceptronit
Monikerroksinen perceptroni (MLP) käyttää täysin yhdistettyjä kerroksia, joissa jokainen ulostuloyksikkö riippuu kaikista edellisen kerroksen syötteistä. MLP:t ovat hyödyllisiä taulukkomuotoisten ominaisuuksien käsittelyssä ja osina suurempia järjestelmiä, mutta ne eivät sisällä oletuksia kuvan paikallisuudesta tai sekvenssijärjestyksestä.
Konvoluutiohermostoverkot
Konvoluutiohermostoverkot (CNN:t) käyttävät opittuja suodattimia paikallisilla alueilla. Painojen jakaminen tekee niistä tehokkaita ruudukkojen, kuten kuvien ja spektrogrammien, käsittelyyn. CNN:t ovat edelleen tärkeitä näkötehtävissä ja reunalaitteiden käyttöönotossa, vaikka näkötransformereita ja hybridimallejakin käytetään laajasti.
Toistuvat verkot, LSTM:t ja GRU:t
Toistuvat neuroverkot (RNN:t) päivittävät piilotilaa sekvenssin käsittelyn aikana. LSTM:t ja porttitoiminnalliset toistuvat yksiköt auttavat säilyttämään tietoa ja vähentävät katoavan gradientin ongelmaa, joka saa perus-RNN:t kamppailemaan pitkien riippuvuuksien kanssa. Ne eivät poista kaikkia pitkän kontekstin rajoituksia, mutta ne ovat edelleen hyödyllisiä signaalien suoratoistossa, aikasarjadatassa ja kompakteissa sekventiaalisissa malleissa.
Transformerit
Transformerit käyttävät huomiointia mallintaakseen suhteita sekvenssin tai joukon elementtien välillä. Niiden kyky käsitellä monia paikkoja rinnakkain auttoi korvaamaan toistuvuuden useimmissa suurissa kielijärjestelmissä, ja transformerin variantit käsittelevät nyt kuvia, ääntä, videota, proteiineja ja multimodaalista dataa.
Autoenkooderit ja generatiiviset mallit
Autoenkooderi pakkaa syötteen esitykseksi ja rekonstruoi syötteen siitä. Tämä luo itsevalvotun rekonstruktio-objektivin; se ei automaattisesti muunna merkitsemätöntä dataa merkittyihin esimerkkeihin.
Generatiiviset vastakkainasettelumallit (GAN:t) kouluttavat generaattoria ja diskriminaattoria kilpailussa. Diffuusiomallit oppivat kääntämään asteittaisen kohinan prosessin. Autoregressiiviset transformerit tuottavat yhden tokenin tai yksikön kerrallaan. Näillä lähestymistavoilla on erilaiset koulutusdynamikat, hallittavuus ja laskenta‑vaatimukset.
Miksi syvyys auttaa – ja miksi arkkitehtuuri on tärkeä
Useat kerrokset antavat mallille mahdollisuuden yhdistää yksinkertaisempia muunnoksia monimutkaisemmiksi. Näkötehtävissä jotkut opitut piirteet voivat kehittyä paikallisista tekstuureista tehtäväkohtaisiksi kuvioiksi. Kielellisissä tehtävissä huomiointikerrokset luovat kontekstiriippuvaisia token-esityksiä. Nämä kuvaukset ovat hyödyllisiä intuitioita, eivät kiinteitä sääntöjä siitä, mitä jokaisen kerroksen on opittava.
Nykyaikaiset verkot turvautuvat myös residual-yhteyksiin, normalisointiin, huolelliseen alustusmenetelmään, regularisointiin ja optimoituun laitteistoon. Pelkkä kerrosten tai parametrien lisääminen voi tehdä mallista vaikeamman kouluttaa, hitaamman tai alttiimman ylisovittamiselle. Mallin mittakaava auttaa vain, kun data, tavoite, optimointi ja käyttöönottoympäristö tukevat sitä.
Koulutus vs. inferenssi
Koulutus säätää parametreja ja on yleensä laskennallisesti intensiivinen vaihe. Inferenssi suorittaa koulutetun mallin tuottaakseen tuloksen. Inferenssi voi silti olla kallista suurille malleille, mistä syystä tiimit käyttävät kvantisointia, destillaatiota, eräajoa, välimuistia, harvaisuutta ja erikoislaitteistoja, kuten neuroprosessointiyksiköitä.
Rajoitukset ja vastuullinen käyttö
Syvät mallit voivat periä harhaanjohtavuutta, muistaa arkaluontoista tietoa, epäonnistua jakautumisen muutoksissa ja tuottaa vakuuttavia mutta vääriä tuloksia. Niitä voi myös olla vaikea tulkita ja niiden kouluttaminen on kallista. Arvioinnin tulisi kattaa muutakin kuin benchmark‑keskiarvo: tiimit tarvitsevat luokka- tai alaryhmätason suorituskykyä, robustiutta, kalibrointia, turvallisuutta, viivettä, energian käyttöä ja epäonnistumisen seurauksia.
Esitykset, optimointi ja arkkitehtuurivalinnat
Syvät verkot oppivat peräkkäisiä esityksiä parametrisoitujen kerrosten kautta. Lineaariset muunnokset sekoittavat syötteitä; epälineaariset aktivoinnit antavat verkolle mahdollisuuden approksimoida monimutkaisia funktioita; normalisointi ja residual-yhteydet auttavat optimointia; huomiointi, konvoluutio, toisto tai tilatilan operaatiot koodaavat erilaisia rakenteellisia oletuksia. Syvyys lisää muunnosten määrää, ei takaa älykkyyttä. Arkkitehtuurin tulisi heijastaa modaliteettia, datamäärää, viivettä, muistia ja tehtävän invariansseja. Pienempi konvoluutioinen malli saattaa ylittää transformerin, kun data on rajoitettua ja paikallinen spatiaalinen rakenne hallitsee.
Koulutus laskee tappion, differentioi sen takaisinsijoituksella ja päivittää parametreja optimointialgoritmilla, kuten stokastisella gradienttimenetelmällä (SGD) tai Adamilla. Erän koko, oppimisnopeus, aikataulu, alustus, regularisointi ja numeerinen tarkkuus vaikuttavat toisiinsa. Koulutus- ja validointitappion käyrät auttavat erottamaan alisovittamisen, ylisovittamisen, epävakauden ja vuodon, mutta ne eivät määrittele todellista hyödyllisyyttä. Käytä itsenäistä arviointidataa, toistettuja suorituksia, joissa varianssi on merkityksellinen, ablaatioita ja vertailua yksinkertaisempiin perusmalleihin. Suuri parametrimäärä lisää myös tarvetta datanhallinnalle, laskennan suunnittelulle ja toistettavalle konfiguraatiolle.
Syvien mallien tarjoaminen turvallisesti ja tehokkaasti
Käyttöönotto voi hyödyntää isännöityä päätepistettä, omistettua kiihdytintä, selainta, puhelinta tai upotettua laitetta. Vienti ja käännös voivat yhdistää operaattoreita, kvantisoida painot ja aktivoinnit tai muuttaa numeerista käyttäytymistä, joten validoi käyttöönotettu artefakti eikä pelkästään koulutuksen tarkistuspistettä. Mittaa kylmäkäynnistys, vakaa viive, läpimeno, muisti, virrankulutus ja laatu realistisilla erä- ja sekvenssikokoilla. Pakkausmenetelmät – leikkaus, destillaatio, kvantisointi ja matalan rajan sovitus – vaihtavat kokoa tai nopeutta tarkkuuden ja insinööri‑kompleksisuuden kustannuksella, ja ne on arvioitava herkissä luokissa ja reunatapauksissa.
Syvät mallit voivat epäonnistua itsevarmasti jakautumisen muutoksissa, hyökkäävässä syötteessä, harhaanjohtavassa korrelaatiossa ja huonosti edustetuissa ryhmissä. Seuraa syötteen ja tulosteen jakaumia, tehtävän tuloksia, kalibrointia, resurssien käyttöä ja riippuvuuksien versioita. Käytä pääsynhallintaa, allekirjoitettuja artefakteja, suojattua koulutusdataa, red‑team‑testausta ja nopeusrajoituksia, jotka sopivat uhkamalliin. Selitykset, kuten salienssikartat tai huomiointinäkymät, ovat diagnostista näyttöä, eivät syy‑seurauksia. Yhdistä ne käyttäytymistesteihin, kontrafaktuaaleihin, ihmistarkasteluun, tapausvastauksiin ja selkeisiin rajoituksiin automatisoiduille päätöksille.
Käytännön esimerkki: kuvan vikadetektorin koulutus
Tehdas kerää tuotteen kuvia eri kameroista, valaistusolosuhteista, materiaaleista ja tunnetuista vikaluokista, ja jakaa ne tuotantolaatikoittain, jotta lähes identtiset kohteet eivät pääse eri osioihin. Pieni konvoluutioinen perusmalli verrataan esikoulutettuun syvään verkkoon. Augmentaatio toistaa validoitua valaistusta ja näkökulman vaihtelua poistamatta vikoja. Arviointi raportoi vikakohtaisen palautuksen, väärä hylkäysprosentin, kalibroinnin, inferenssiviiveen ja kestävyyden sumennusta, heijastusta, kameran vaihtoa ja harvinaisia materiaalivärejä vastaan.
Viedyn mallin ja tarkat koonmuutoksen, värin ja normalisoinnin koodit testataan linjan laitteistossa kestävän läpimenon ja lämpökäyttäytymisen varmistamiseksi. Alhaisen luottamuksen tapaukset ohjataan tarkastajille; itsenäinen sääntö pysäyttää linjan turvallisuuskriittisen anturivian vuoksi. Kuvat säilytetään vain sallituissa määrin ja mallin artefaktit allekirjoitetaan. Seuranta yhdistää ennusteet myöhempiin tarkastustuloksiin ja tuotantolaatikoihin. Uusi kamera tai materiaali laukaisee hallitun uudelleenarvioinnin sen sijaan, että hiljaisesti oppisi verkossa tarkistamattomista tunnisteista.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määrittele kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän epäonnistumisen seuraukset. Perusta toistettavissa oleva perusmalli ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakautumisen muutokset, riippuvuuksien katkokset, väärinkäytökset sekä ryhmät tai ympäristöt, jotka todennäköisesti jäävät huomiotta. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varmistus ja varmista seuranta tarkoituksellisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien kunto, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluontoista dataa. Määrittele hälytyskynnysarvot ja vastuuhenkilö, ja tarkastele todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletat offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Ensisijaiset lähteet












