
AI:n perusteet
Mikä on päätöspuu?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
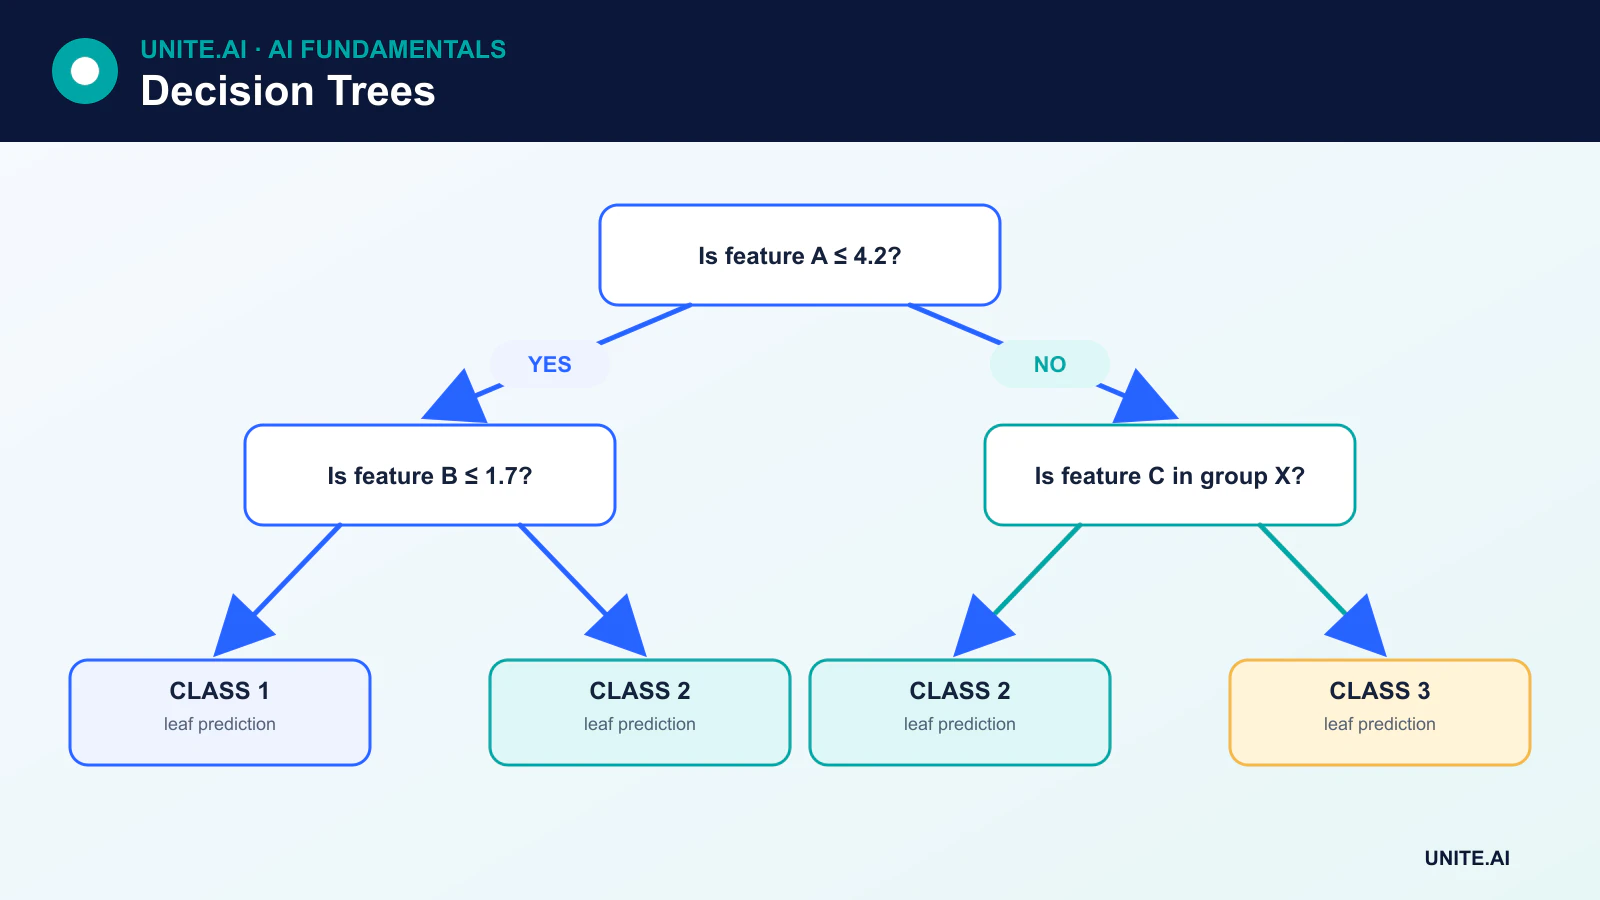
päätöspuu on ohjattuun oppimiseen perustuva malli, joka tekee ennusteen soveltamalla sarjaa jos‑niin‑sääntöjä. Jokainen sisäinen solmu testaa ominaisuutta, jokainen haara edustaa testin tulosta, ja jokainen lehti tuottaa luokkaan liittyvän ennusteen, todennäköisyyden tai numeerisen arvon.
Päätöspuita käytetään luokitteluun ja regressioon. Niiden käytännöllisyys on houkuttelevaa: ne voivat mallintaa epälineaarisia vuorovaikutuksia, vaativat melko vähän esikäsittelyä ja tuottavat polun, jonka ihminen voi tarkastella. Heikkoutena on epävakaus—pienet muutokset opetusdatassa voivat luoda erilaisen puun.
Keskeiset seikat
- Puu jakaa ominaisuusavaruuden rekursiivisesti; sen ei tarvitse eristää jokainen opetushavainto.
- Luokittelun haaroituksessa käytetään tavallisesti Gini‑epäpuhtautta tai entropiaa, kun taas regressiohaarojen tarkoituksena on vähentää ennusteen virhettä tai varianssia.
- Syvyys, vähimmäislehtikoko ja leikkaus ohjaavat monimutkaisuutta ja ylisovittamista.
- Satunnaismetsät ja gradientti‑boostatut puut parantavat ennusteen voimaa yhdistämällä useita puita.
Miten päätöspuu tekee ennusteen
Oletetaan, että malli ennustaa, onko kone todennäköisesti vioittunut. Juurisolmu saattaa kysyä, ylittääkö värähtely opitun kynnyksen. Sen jälkeen haara voi testata käyttö‑lämpötilaa. Havainto saavuttaa lehtisolmun, joka sisältää arvion epäonnistumistodennäköisyydestä opetusesimerkeissä, jotka kulkivat saman polun.
Regressiossa lehti voi palauttaa kyseisen alueen havaintojen keskiarvon. Luokittelussa se voi palauttaa enemmistöluokan tai luokkafrekvenssien jakauman. Lehti voi sisältää monia havaintoja; opetusdatan täydellinen erottaminen on yleensä ei‑toivottua, koska se voi johtaa ylisovitettuun puuhun.
Miten puu valitsee haarautumisen
Koulutus tarkastelee ehdokkaiden ominaisuuksien ja kynnysarvojen yhdistelmiä, ja valitsee sen haarautumisen, joka parantaa eniten määriteltyä tavoitetta. Parannuksen on otettava huomioon, kuinka monta havaintoa kussakin lapsisolmussa on.
Gini‑epäpuhtaus
Luokittelussa Gini‑epäpuhtaus mittaa, kuinka sekoittuneita luokat ovat solmussa:
Gini = 1 - Σ p(k)²
Solmu, joka sisältää vain yhden luokan, on epäpuhtautta nolla. Ehdokas haarautuminen on hyödyllinen, kun sen lasten painotettu epäpuhtaus on alhaisempi kuin vanhemman epäpuhtaus.
Entropia ja informaation kasvu
Entropia on toinen luokan epävarmuuden mittari:
Entropy = -Σ p(k) log₂ p(k)
Informaation kasvu on vanhemman entropian ja lasten painotetun entropian välinen ero. Gini‑epäpuhtaus ja entropia tuottavat usein samankaltaisia puita, vaikka eivät aina ole identtisiä.
Regressiohäviö
Regressio‑puut valitsevat tavallisesti haarautumiset, jotka vähentävät neliövirhettä, absoluuttista virhettä tai muuta regressiokriteeriä. Jokainen lehti sitten ennustaa arvon alueen opetustavoitteiden perusteella.
CART ja muut puu‑algoritmit
CART, eli luokittelu- ja regressiopuut, käyttää binäärisiä haarautumisia ja on taustalla yleisissä toteutuksissa, kuten scikit-learnin päätöspuissa. Muita algoritmeja ovat ID3, C4.5 ja C5.0. Toteutukset eroavat tuetuissa haarautumistyypeissä, puuttuvien arvojen käsittelyssä, leikkausmenetelmissä ja tavoitteissa.
Luokittelevat (kategoriset) muuttujat saattavat vaatia koodausta, suoria alijoukkoharautumisia tai toteutuskohtaista käsittelyä. Puuttuvia arvoja voidaan täyttää tai käsitellä oppimien oletussuuntausten tai korvaavien haarautumisten avulla. On tärkeää ymmärtää kyseisen kirjaston toiminta sen sijaan, että oletetaan jokaisen puun toteutuksen toimivan samalla tavalla.
Puun monimutkaisuuden hallinta
Syvä puu voi muistaa kohinaa. Yleisiä säätimiä ovat:
- Maksimisyvyys: Rajoittaa ennustepolun pituuden.
- Vähimmäisnäytteet per haarautuma tai lehti: Estää hyvin pieniä alueita.
- Vähimmäisepäpuhtauden väheneminen: Vaatii, että haarautuminen tuottaa riittävän hyödyn.
- Lehtien enimmäismäärä: Asettaa ylärajan kokonaismonimutkaisuudelle.
- Kustannus‑monimutkaisuusleikkaus: Poistaa haarat, joiden parannus ei oikeuta lisättyä monimutkaisuutta.
Leikkaus on strukturoitu optimointiprosessi, ei satunnainen poisto. Hyperparametrit tulisi valita validointidatan tai ristiinvalidoinnin avulla, kun taas lopullista testijoukkoa ei muuteta.
Vahvuudet ja rajoitukset
Päätöspuut voivat mallintaa vuorovaikutuksia ja kynnysvaikutuksia ilman ominaisuuksien skaalausta. Ne hyväksyvät numeerisia ja, toteutuksesta riippuen, kategorisia syötteitä. Ennuste on nopea, ja pieni puu on helppo visualisoida.
Kuitenkin, yksittäinen puu voi olla korkean varianssin omaava, aiheuttaa äkillisiä ennustemuutoksia lähellä haarautumista, ja suosia ominaisuuksia, joilla on paljon mahdollisia jakokohteita. Puu myös extrapoloi huonosti regressiossa: havaittujen alueiden ulkopuolella lehti palauttaa silti arvon, joka on opittu sen opetus‑näytteistä. Suuri puu ei välttämättä ole selkeämpi kuin toinen monimutkainen malli.
Yhdestä puusta koontimalleihin
Koontioppiminen yhdistää useita malleja. Satunnaismetsä kouluttaa monia puita uudelleennäytteistettyjen havaintojen ja ominaisuuksien alijoukkojen perusteella, ja sitten keskiarvoistaa niiden ennusteet. Gradientti‑boostaus rakentaa puita peräkkäin, niin että jokainen uusi puu korjaa jäljelle jäävää virhettä. Nämä lähestymistavat ylittävät yleensä yhden puun, mutta ne vähentävät jonkin verran tulkittavuutta ja lisäävät laskentakustannuksia.
Puun tai koontimallin ominaisuuksien tärkeys on tulkittava huolellisesti. Epäpuhtausperusteinen tärkeys voi olla vinoutunutta, eikä ominaisuuden tärkeys todista kausaalisuutta. Permutaatiotärkeys, osittaisriippuvuus‑työkalut ja toimialojen tarkastelu tarjoavat lisäkontekstia.
Miten puu oppii haarautumiset ja ennusteet
Päätöspuu jakaa ominaisuusavaruuden rekursiivisesti. Jokaisessa solmussa koulutusalgoritmi arvioi ehdokkaiden ominaisuuksien kynnysarvoja tai luokkaan jakautumista ja valitsee haarautumisen, joka vähentää eniten epäpuhtautta, kuten Gini‑epäpuhtaus tai entropia luokittelussa ja neliövirhe regressiossa. Lehtisolmut tallentavat luokkajakauman tai numeerisen ennusteen opetushavaintojen perusteella, jotka saavuttavat ne. Ahne haarautuminen on laskennallisesti käytännöllistä, mutta se ei takaa globaalisti parasta puuta, ja eri näytteet tai tasapainottamispäätökset voivat tuottaa erilaisia rakenteita.
Jatkuvia, järjestys- ja kategorisia sekä puuttuvia ominaisuuksia täytyy käsitellä eksplisiittisesti. One‑hot‑koodaus voi luoda monia ehdokkaiden haarautumisia; natiivit kategoriset menetelmät voivat käyttää järjestettyjä tilastoja, mutta ne tarvitsevat vuoto‑turvallisen toteutuksen. Puita ei tarvitse skaalausta, mutta ne voivat suosia suurikortinalaisia muuttujia ja eristää pieniä ryhmiä. Syvyys, vähimmäislehtikoko, vähimmäisepäpuhtauden väheneminen ja kustannus‑monimutkaisuusleikkaus ohjaavat varianssia. Valitse ne validointidatan avulla ja arvioi kalibrointi, koska lehtiprobability, joka perustuu muutamaan tapaukseen, voi olla äärimmäinen ja epävakaa.
Tulkinta, epäonnistumistavat ja tuotantokäyttö
Polku juuresta lehtiin on tarkka sääntö yhdelle mallin ennusteelle, mutta se ei automaattisesti ole kausaalinen selitys. Korreloivat muuttujat voivat korvata toisiaan, pienet datamuutokset voivat muuttaa ylempiä haarautumisia, ja yksinkertaiselta vaikuttava polku voi riippua vinoutuneista merkinnöistä. Globalisaineiden tärkeys perustuen epäpuhtauteen voi olla harhaanjohtavaa; permutaatiotärkeys, osittaisriippuvuus ja kontrafaktuaaliset tarkastukset tarjoavat kontekstia, mutta niillä on myös oletuksia. Raportoi epävarmuus ja testaa, pitävätkö väitetyt säännöt paikkansa itsenäisellä datalla ja merkityksellisissä alaryhmissä.
Yksittäiset puut ovat hyödyllisiä, kun läpinäkyvyys, alhainen viive ja kohtuullinen epälineaarinen rakenne ovat tärkeitä, mutta koontimallit tarjoavat yleensä vahvemman ennusteen suorituskyvyn. Vahvista rajakäyttäytymistä, harvinaisia luokkia, puuttuvuutta ja syötteitä, jotka ovat koulutuksen alueen ulkopuolella. Viedyt säännöt on toteutettava tarkasti vastaamaan koulutuksen esikäsittelyä ja numeerista vertailua. Seuraa lehtien täyttöä, tulosten jakautumista, virhettä ja uusia luokkia. Puu, joka ohjaa monia uusia tapauksia pieneen tai aiemmin tyhjään alueeseen, tulisi tarkistaa, vaikka kokonaispoikkeama olisi pieni. Pidä varajärjestelmä virheellisiä skeemoja varten ja dokumentoi jokainen leikkaus‑ tai kynnys‑päätös.
Työstetty esimerkki: tulkittava lainahakemusten priorisointipuu
Lainantarjoaja käyttää puuta ainoastaan keskeneräisten hakemusten priorisoimiseen manuaalista tarkastusta varten, ei luottopäätösten hyväksymiseen tai hylkäämiseen. Tavoitteena on dokumentoitu täydellisyyden tulos, ja vastaanottohetkellä saatavilla olevat ominaisuudet sulkevat pois myöhemmät päätökset. Ryhmitelty ajallinen validointi vertaa matalaa leikkausta säädeltyä puuta sääntöihin ja logistiseen regressioon. Vähimmäislehtikoko estää sääntöjä, jotka perustuvat muutamaan hakijaan, kun taas kalibrointi ja luokko‑kohtaiset virheet raportoidaan kanavien ja merkityksellisten suojeltujen ryhmien välillä.
Tarkastajat näkevät tarkan polun ja lähdearvot, mutta voivat korjata virheellisiä tietoja ja ohittaa reitityksen. Organisaatio testaa korreloivia proksiyhteyksiä ja kontrafaktuaalisia muutoksia, seuraa lehtien täyttöä ja puuttuvuutta, ja käsittelee äkillistä liikennettä pieneen lehtiin tietolaadun incidenttinä. Politiikan muutokset luovat uuden malliversion ja validoinnin, eivät dokumentoimatonta haarautumisen muokkausta. Koska käyttö vaikuttaa pääsyyn ja kuormaan, hakijoille tarjotaan inhimillinen kanava, eikä puuta koskaan esitetä luottokelpoisuuden kausaalisena selityksenä.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määrittele suunnitellut käyttäjät, toimintaympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen merkittävän vikavirheen seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen viritysprosessia. Testaa tavallisia tapauksia, raja‑ehtoja, virheellisiä tai puuttuvia syötteitä, jakautuman siirtymää, riippuvuuden katkeamista, väärinkäyttöä sekä ryhmiä tai ympäristöjä, joihin on todennäköisesti alipalvelua. Mittaa tehtävän laatua yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnys, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, peruutukselle ja poistamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tuloksen käyttäytyminen, mallin tai säännön versio, riippuvuuksien kunto, ihmisen ohitukset ja vahvistetut tulokset keräämättä turhaa arkaluonteista dataa. Määrittele hälytyskynnykset ja vastuunhaltija, tarkasta sitten todelliset todisteet käyttöönoton jälkeen sen sijaan, että oletettaisiin offline‑suorituskyvyn säilyvän. Arvioi uudelleen aina, kun tietolähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidetty järjestelmä tarvitsee myös dokumentoidun palautumisen, tapaustiedon oppimisen, poistamisen ja säilytyskäytännöt sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Ensisijaiset lähteet












