
AI:n perusteet
Mikä on ansamblioppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Ansamblioppiminen yhdistää useiden mallien ennusteet. Keskeinen ajatus on, että eri virheitä tekevät mallit voivat tuottaa tarkemman tai vakaamman tuloksen, kun niiden tulokset otetaan keskiarvona, äänestetään tai syötetään meta‑oppijalle.
Mallien lisääminen ei riitä. Jos jokainen jäsen oppii saman oikopolun, niiden virheet korreloivat ja ansambli voi vain olla itsevarmempi samassa virheessä.
Keskeiset havainnot
- Ansambelit toimivat parhaiten, kun jäsenmallit ovat yksilöllisesti hyödyllisiä ja tekevät merkittävästi erilaisia virheitä.
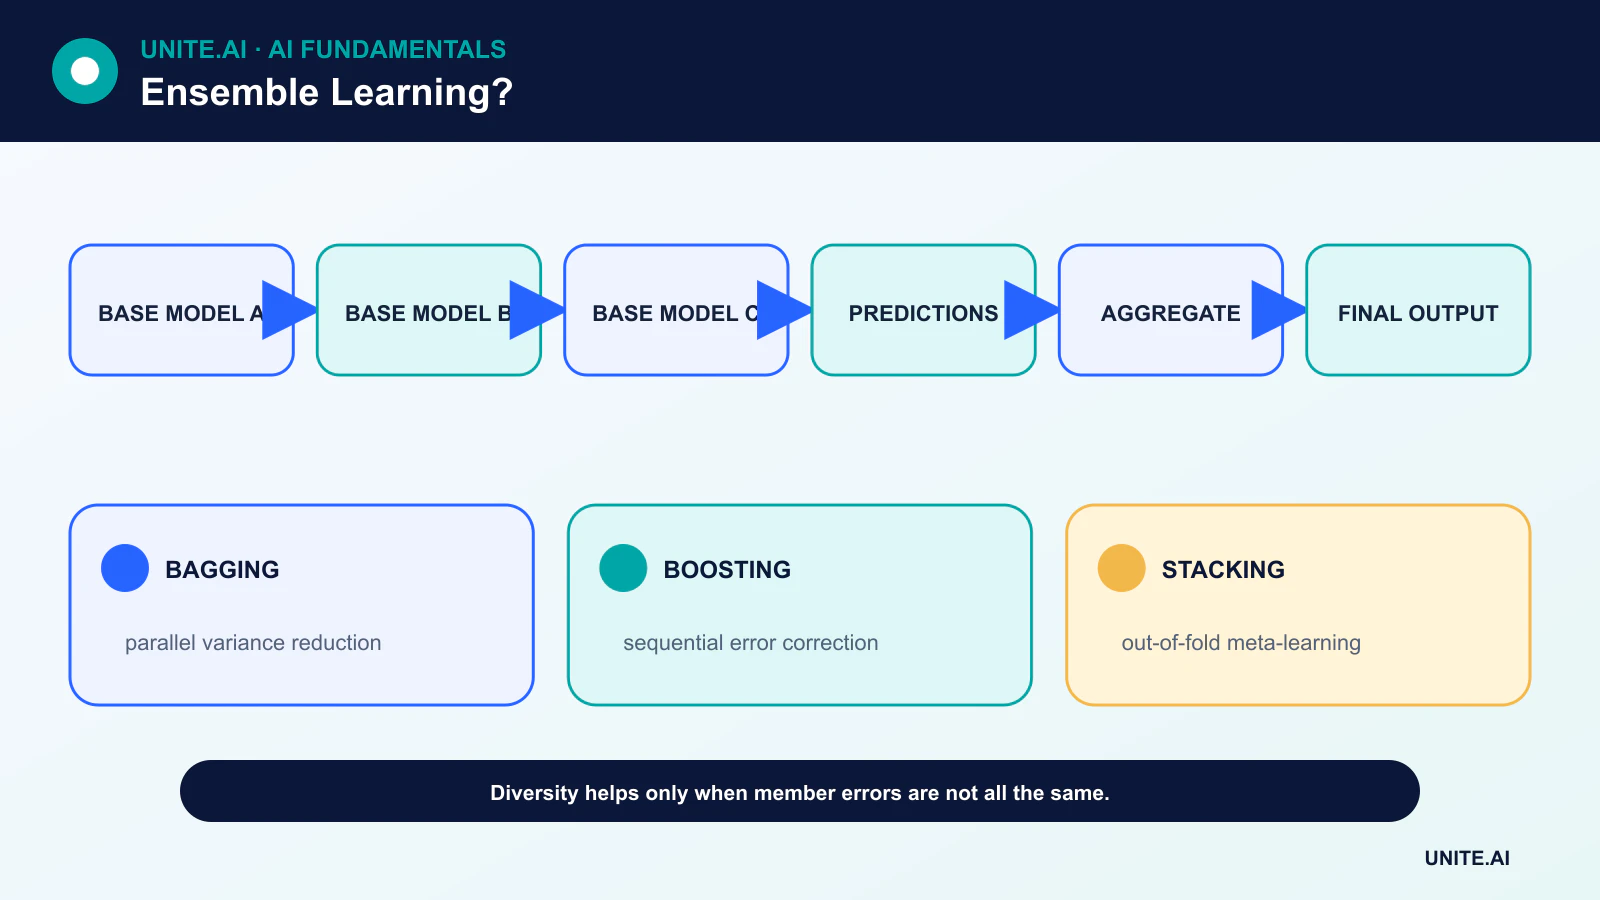
- Bagging kouluttaa jäsenet rinnakkain uudelleennäytteistetyn datan avulla; boosting kouluttaa oppijat peräkkäin virheiden korjaamiseksi.
- Stacking kouluttaa meta‑mallin ulkopuolisilla ennusteilla, ei näytteen sisäisillä ennusteilla.
- Tarkkuusparannuksia on tasapainotettava viiveen, kalibroinnin, tulkittavuuden ja ylläpitokustannusten kanssa.
Äänestys ja keskiarvo
Kova äänestys valitsee luokan, jolla on eniten ääniä. Pehmeä äänestys laskee luokkien todennäköisyydet keskiarvona, yleensä kalibroinnin jälkeen. Regressio‑ansambelit usein keskiarvoistavat numeeriset ennusteet. Painotetut versiot antavat vahvemmille jäsenille enemmän vaikutusvaltaa.
Keskiarvo voi vähentää varianssia, kun virheet eivät ole täydellisesti korreloituneet. Se ei kuitenkaan korjaa jaettua datavirhettä, merkintävirhettä tai puuttuvaa alaryhmää. Monimuotoisuutta tulisi mitata erimielisyyden ja virheiden päällekkäisyyden perusteella, ei olettaa sitä pelkästään eri mallin nimistä.
Bagging ja satunnaismetsät
Bootstrap‑aggregointi (bagging) kouluttaa mallit uudelleennäytteistettyihin tietoaineistoihin ja keskiarvoistaa ne. Päätöspuu on korkean varianssin malli, mikä tekee siitä luonnollisen ehdokkaan baggingiin.
Satunnaismetsät lisäävät satunnaisen ominaisuuksien valinnan jakautumispisteissä, mikä vähentää puiden välistä korrelaatiota. Out‑of‑bag‑esimerkit voivat arvioida suorituskykyä, mutta lopullinen koskematon testijoukko on edelleen arvokas mallin valinnassa ja käyttöönotto‑väitteissä.
Boostaus
Boostaus rakentaa lisättävän mallin vaiheittain. Myöhemmät oppijat keskittyvät esimerkkeihin tai jäännösmalleihin, joita nykyinen ansambli käsittelee heikosti. AdaBoost muuttaa esimerkkien painoja; gradienttiboostaus sovittaa oppijat valitun häviöfunktion negatiivisiin gradientteihin.
Boostatut puut voivat mallintaa monimutkaisia taulukkotietojen suhteita, mutta syvät puut, liialliset kierrokset ja vuoto voivat silti ylisovittaa. Oppimisnopeus, puun syvyys, alinäytteistys ja varhainen pysäytys ovat keskeisiä säätimiä.
Pinottaminen ja sekoittaminen
Stacking luo toisen tason mallin, joka oppii yhdistämään perusennusteet. Vuodon välttämiseksi jokaisen meta‑mallin koulutusrivin on oltava perusmallin tuottama, joka ei ole koulutettu kyseisellä rivillä. Ristiinvalidointi tuottaa nämä ulkopuoliset ennusteet.
Blending käyttää erillistä holdout‑joukkoa meta‑mallille, mikä on yksinkertaisempaa, mutta vähentää koulutukseen käytettävissä olevaa dataa. Molemmat lähestymistavat edellyttävät samaa esikäsittelyä ja versionhallintaa inferenssissä.
Operatiiviset kompromissit
Ansambli voi moninkertaistaa muistin, laskennan ja vikojen määrän. Sen selittäminen, kalibrointi ja jatkuva päivitys voivat olla vaikeampia. Destillaatio voi pakata ansambelin pienempään malliin, mutta opiskelija (opetusmalli) on arvioitava itsenäisesti.
Käytännöllinen valinta vertaa suorituskykyä, latenssia, kalibrointia, resurssien käyttöä ja virhekustannuksia. Joskus yksi hyvin säännöstelty malli on suositeltavampi kuin pieni tarkkuusparannus hauraasta pinosta.
Miksi ansamblit toimivat
Ansamblioppiminen yhdistää useita malleja niin, että niiden virheet osittain kumoutuvat tai niiden vahvuudet kattavat eri alueita. Bagging kouluttaa malleja uudelleennäytteistettyyn dataan ja keskiarvoistaa ennusteet, mikä vähentää varianssia; satunnaismetsät lisäävät satunnaisen ominaisuuksien valinnan puiden korrelaation poistamiseksi. Boostaus kouluttaa oppijoita peräkkäin keskittyen jäännösvirheisiin, mikä usein vähentää harhaa mutta lisää herkkyyttä kohinalle ja säätämiselle. Stacking kouluttaa meta‑mallin perusmallien ennusteista. Monimuotoisuuden on oltava hyödyllistä: identtisten mallien keskiarvo lisää kustannuksia ilman merkittävää virheiden vähenemistä.
Virheiden korrelaatio määrittää hyödyn. Monimuotoisuus voi tulla datan näytteistä, ominaisuuksista, algoritmeista, hyperparametreista, satunnaisesta alustusvaiheesta tai aikaväleistä. Kova äänestys hylkää varmuuden; pehmeä äänestys keskiarvoistaa todennäköisyydet, mutta vaatii yhteensopivan kalibroinnin. Regressio voi keskiarvoistaa tai käyttää vankkaa aggregaatiota. Stackauksessa ulkopuoliset ennusteet ovat olennaisia – meta‑mallin kouluttaminen perusmallien ennusteista samalla sovitetulla datalla aiheuttaa vuotoa. Pidä yksinkertainen keskiarvoinen perusmalli ennen monimutkaisen yhdistäjän käyttöönottoa.
Arviointi, kalibrointi ja epävarmuus
Vertaa kutakin jäsentä ja ansamblia pidätetyllä testijoukolla, jossa on identtinen esikäsittely. Raportoi tehtävän mittarit, kalibrointi, alaryhmien virheet, varianssi eri ristiinvalidointikierrosten tai siementen välillä sekä resurssikustannukset. Ansambli voi parantaa keskimääräistä laatua samalla kun se peittää yhteisen sokean pisteen, joka johtuu yhteisestä datasta tai merkinnöistä. Tarkastele erimielisyyttä: se voi paljastaa epävarmuutta, mutta korreloivat itsevarmat virheelliset mallit voivat olla yhtä mieltä. Kalibroi lopullinen ansambli, ei vain jäsenet, ja vahvista abstoinnikynnys tarkastuskapasiteettiin ja seurauksiin nähden.
Out‑of‑bag‑arviot ovat hyödyllisiä bagged‑malleille, mutta ne eivät korvaa lopullista käyttöönottoa edustavaa testiä. Aikasarjadatassa vältä uudelleennäytteistystä, joka rikkoo järjestyksen. Turvallisuuskriittisissä sovelluksissa testaa jäsenten vika, vanhentuneet mallit ja vihamielinen syöte. Painotetut ansambelit voivat ylisovittaa validointidataa, kun kokeillaan monia ehdokkaita. Tallenna ehdokasvalinta ja käytä sisäkkäistä validointia, kun säätö on laajaa.
Palvelu ja ylläpito
Ansambelit moninkertaistavat muistin, latenssin, energian ja operatiiviset riippuvuudet. Destillaatio voi pakata yhdistetyn käyttäytymisen yhdeksi malliksi, mikä edellyttää uutta validointia. Versioi jäsenet, esikäsittelyn, painot ja reitityksen yhtenä artefaktina; määritä toiminta, kun jäsen aikakatkaisee tai tuottaa virheellisen tuloksen. Seuraa jäsenten ennusteita ja erimielisyyttä, jotta hiljainen vika tulee näkyväksi. Poista tarpeettomat jäsenet ja uudelleenkouluta tarkoituksellisesti. Ansambelit parantavat ennustetta, kun virhemonimuotoisuus on todellista, mutta ne eivät muuta vinoutunutta koulutusdataa tai virheellistä kohdetta luotettavaksi todistukseksi.
Käytännön esimerkki: ansambeli vakavien säävaroitusten tuottamiseen
Ennustustiimi yhdistää fyysisen mallin ominaisuudet, gradienttiboostatun puun, neurosekvenssimallin ja kalibroidun tilastollisen perustason. Ulkopuoliset ennusteet kouluttavat yksinkertaisen meta‑mallin, ja arviointi käyttää tulevia myrskyjä, jotka on täysin poissuljettu jäsenten koulutuksesta. Mittareita ovat tapahtumien palautus, väärät hälytykset, varoitusajankohta, kalibrointi, maantieteellinen suorituskyky ja luotettavuus harvinaisten äärimmäisten olosuhteiden aikana. Jäsenten virheiden korrelaatiota tarkastellaan, koska jaettu syötedata voi luoda yhteisiä sokeita pisteitä.
Palvelu säilyttää jokaisen ennusteen ja yhdistetyn tuloksen. Jos jäsen ei ole käytettävissä, järjestelmä käyttää ennalta validoitua heikennettyä konfiguraatiota sen sijaan, että se hiljaisesti normalisoisi. Erimielisyys käynnistää lisäarvion, mutta sitä ei kaikissa tapauksissa käsitellä epävarmuutena. Seuranta seuraa jäsenten poikkeamaa, latenssia ja myrskyn tuloksia, ja painot päivitetään vain hallitun validoinnin kautta. Julkiset varoitukset pysyvät valtuutettujen meteorologisten päätösprosessien alaisina; ansambli parantaa todistusaineistoa, mutta ei itsenäisesti määrittele hälytyspolitiikkaa uudelleen.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määrittele kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja kunkin tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen säätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakauman siirtymä, riippuvuuksien katkeaminen, väärinkäyttö sekä ryhmät tai ympäristöt, jotka todennäköisesti jäävät vajaaksi. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, latenssin, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnys, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua nimeä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista seuranta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluonteista dataa. Määritä hälytyskynnykset ja vastaavan omistaja, ja tarkastele todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidetty järjestelmä tarvitsee myös dokumentoidut palautus‑, tapausoppimis‑, poistamis‑ ja säilytyskäytännöt sekä selkeän pisteen, jossa se tulee poistaa tai korvata.
Usein kysytyt kysymykset
Onko satunnaismetsä ansambli?
Kyllä. Se yhdistää useita satunnaistettuja päätöspuita, yleensä äänestämällä tai keskiarvoistamalla.
Voivatko identtiset mallit muodostaa hyödyllisen ansambelin?
Ne voivat, jos koulutusdata, alustus tai näytteenotto luovat riittävän erilaisia virheitä, mutta pelkkä monistaminen ei tuo hyötyä.
Ensisijaiset lähteet












