
AI:n perusteet
Mikä on vähäesimerkkinen oppiminen?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Few-shot learning tutkii, miten malli voi sopeutua uuteen tehtävään tai luokkaan vain muutamasta merkittyä esimerkkiä käyttäen. Perinteisissä vertailuarvioissa jakso tarjoaa tukijoukon — esimerkiksi viisi luokkaa, joihin kullekin on yksi tai viisi esimerkkiä — ja pyytää mallia luokittelemaan näkemättömiä kyselyitä.
Termiä käytetään myös kontekstissa tapahtuvaan oppimiseen, jossa esikoulutettu kielimalli saa muutaman demonstraation kehotteessaan päivittämättä parametreja. Näissä asetuksissa tavoitteena on vähän esimerkkejä, mutta ne hyödyntävät erilaisia sopeutumismekanismeja ja vaativat erilaisia arviointisuunnitelmia.
Keskeiset havainnot
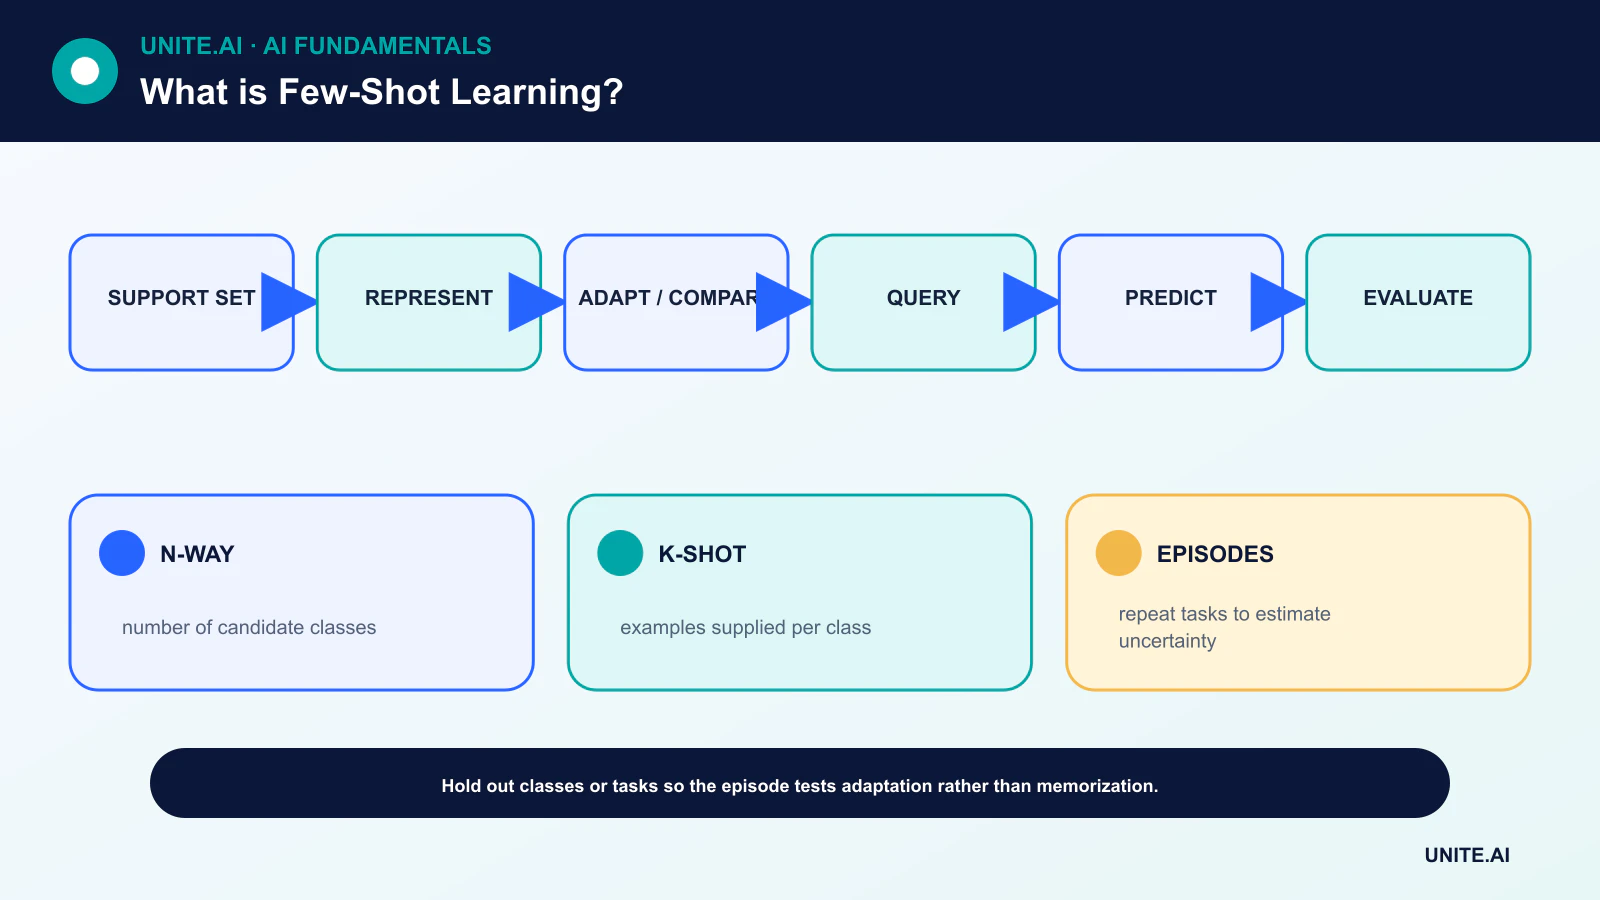
- N‑tapa K‑esimerkki (N‑way K‑shot) kuvaa N luokkaa ja K merkittyä tukiesimerkkiä per luokka.
- Metric‑oppimismenetelmät vertaavat kyselyjä opittuihin tukiesimerkkien esityksiin.
- Meta‑oppiminen optimoi monien tehtävien yli, jotta uusi tehtävä voidaan oppia nopeasti.
- Vähäiset esimerkit suurentavat merkintävirheitä, vuotoja, luokkien epäselvyyttä ja epävarmuutta, joten vertailupohjat ja luottamusraportointi ovat tärkeitä.
Jaksot, tukijoukot ja kyselyjoukot
Vähäesimerkkinen jakso erottaa pienen merkitty tukijoukon arviointiin käytettävästä kyselyjoukosta. Meta‑koulutuksen aikana malli näkee monia tällaisia jaksoja. Vahva arviointi pitää kokonaisia luokkia, tehtäviä tai toimialoja sivussa, jotta testijakso mittaa sopeutumista eikä muistamista.
Raportoi tarkkuusjakaumat useiden jaksojen yli sen sijaan, että käyttäisit yhtä kätevää otosta. Vertaa yksinkertaisiin lähimmän naapurin ja lineaarisiin vertailupohjiin; hienostunut menetelmä, joka ei kykene päihittämään hyvin koulutettua esitystä ja perusluokittelijaa, ei välttämättä oikeuta monimutkaisuuttaan.
Metric‑oppiminen ja prototyypit
Matching‑verkot ja niihin liittyvät menetelmät upottavat tukiesimerkit ja kyselyesimerkit avaruuteen, jossa läheiset vektorit jakavat saman luokan. Prototyypilliset verkot keskiarvoistavat tukupäätteiden upotukset jokaiselle luokalle ja luokittelevat kyselyn etäisyyden perusteella näihin luokkaprototyyppeihin.
Tämä yhdistää vähäesimerkkisen oppimisen esityksen laatuun. Esikoulutettu syväoppimismalli saattaa jo järjestää olennaiset piirteet hyvin, kun taas epäsopiva esitys voi tehdä jokaisesta etäisyydestä harhaanjohtavan.
Optimointiin perustuva meta‑oppiminen
Model‑Agnostic Meta‑Learning (MAML) etsii parametreja, jotka voivat sopeutua muutamalla gradienttiaskeleella. Muut menetelmät oppivat optimointialgoritmin, aloitustilan tai parametripäivityssäännön. Ulkoinen silmukka arvioi sopeutuksen jälkeistä suorituskykyä tehtävien yli.
Meta‑oppiminen olettaa, että hyödyllinen rakenne on jaettu koulutus- ja kohdetehtävien välillä. Kun kohdejakautuma poikkeaa voimakkaasti, nopea sopeutuminen voi epäonnistua. Vahvistusvaiheen tulisi vaihdella esimerkkimäärää, luokkia, toimialoja ja tehtävän vaikeutta sen sijaan, että yksi vertailuarvio olisi universaali.
Siirtäminen oppiminen ja data‑tasoiset strategiat
Siirtäminen oppiminen on usein vahvin käytännöllinen lähtökohta: pakkaa esikoulutettu enkooderi, kouluta pieni päätaso, ja hienosäädä valikoivasti, jos riittävästi dataa on. Datan augmentointi voi tuoda invariansseja, mutta epärealistiset synteettiset esimerkit voivat vahvistaa vinoumaa tai luoda oikopolkuja.
Aktiivinen oppiminen voi priorisoida, mitkä esimerkit merkitään, kun taas puolivalvottu oppiminen voi hyödyntää lisääidinkieltä. Nämä ovat täydentäviä strategioita, eivät synonyymejä vähäesimerkkiselle oppimiselle.
Vähäesimerkkinen kehotteiden käyttö eroaa
Transformer voi päätellä mallin kontekstissa olevista demonstraatioista. Pysyvä parametripäivitys ei ole tarpeen. Järjestys, sanavalinnat ja luokkien tasapaino voivat merkittävästi muuttaa tulosta, ja esimerkit voivat viedä suuren osan kontekstin ikkunasta.
Käytä edustavaa arviointijoukkoa, versioi jokainen kehotus ja demonstraatio, ja testaa nollan esimerkin, vähäesimerkin sekä hienosäädetyt vaihtoehdot. Pieni tukijoukko ei tue vahvoja väestötason väitteitä, erityisesti harvinaisten tai turvallisuuskriittisten tapausten osalta.
Vähäesimerkkisen oppimisen paradigma ja tehtävänrakennus
Vähäesimerkkinen oppiminen pyrkii suorittamaan tehtävän hyvin vähäisistä merkittyistä esimerkeistä. Metric‑pohjaisissa menetelmissä enkooderi kartoittaa esimerkit avaruuteen, jossa lähimmät prototyypit tai naapurit edustavat luokkia. Optimointiin perustuva meta‑oppiminen kouluttaa aloitustilan tai päivityssäännön nopeaa sopeutumista varten. Siirtäminen oppiminen hienosäätää esikoulutetun mallin pienelle kohdejoukolle. Kontekstissa tapahtuva oppiminen tarjoaa esimerkit kehotteessa päivittämättä painoja. Nämä mekanismit eroavat, joten väitteiden tulisi tarkentaa, muuttuvatko parametrit, mikä aiempi koulutus on tapahtunut ja miten esimerkit valitaan.
Arvioinnin tulisi erottaa koulutus- ja testiluokat, tehtävät, kohteet tai toimialat väitetyn yleistettävyyden mukaan. N‑way K‑shot -jakso sisältää N luokkaa ja K tukiesimerkkiä per luokka, sekä kyselyesimerkit pisteytykseen. Toistuvat jaksot arvioivat vaihtelua tukivalinnasta. Kehotteiden osalta esimerkkien järjestys, luokkien sanamuoto, formaatti ja demonstraatioiden samankaltaisuus voivat merkittävästi muuttaa tuloksia. Vertaa nollan esimerkin, lähimmän naapurin, lineaarisen sondauksen ja tavallisten hienosäätövertailupohjien kanssa käyttäen samaa esitystä ja databudjettia.
Datan laatu, epävarmuus ja negatiivinen siirto
Kun esimerkkejä on vähän, virheellisesti merkittyjen tai epätavallisten tapausten vaikutus on suhteettoman suuri. Määrittele annotointisäännöt, tarkasta jokainen tukikohde ja säilytä tuntematon tai pidättäytyvä tulos. Datan augmentointi ja synteettiset esimerkit auttavat vain, jos ne säilyttävät tehtävän ja lisäävät realistista vaihtelua. Esikoulutettu malli voi siirtää oikopolkuja tai vinoumaa lähdealueeltaan. Testaa toimialan ulkopuoliset tapaukset, harvinaiset ryhmät ja herkkyys yhden tukiesimerkin poistoon. Raportoi luottamusvälit tehtävien ja satunnaisten siementen yli, ei yhtä suotuisaa kehotusta.
Aktiivinen oppiminen voi pyytää merkintöjä informatiivisista tapauksista, kun taas puolivalvotut menetelmät käyttävät merkitsemättömiä dataa lisäoletusten alla. Haku voi valita relevantteja demonstraatioita dynaamisesti, mutta sen on vältettävä testimerkintöjen vuotoa. Sopeutuminen voi ylisovittaa nopeasti, joten rajoita päivityksiä, käytä regularisaatiota ja vahvista erillisillä esimerkeillä. Korkean riskin tehtävissä muutama merkintä harvoin oikeuttaa itsenäisiin päätöksiin; käytä mallia priorisoimaan tai avustamaan tarkastusta, kunnes riittävä tulosdata on saatavilla.
Tuotantokäyttö
Versioi perusmalli, upotus tai kehottemalli, demonstraatiot, merkintäkaava ja sopeutusparametrit. Suojaa esimerkit, koska kehotteet tai gradientit voivat paljastaa arkaluonteisia tietoja. Seuraa suorituskykyä luokkien ja kielen muuttuessa, ja päivitä tukiesimerkit hallitun tarkastelun kautta automaattisen itsemerkinnän sijaan. Vähäesimerkkinen oppiminen vähentää merkittyjen kohdetietojen tarvetta hyödyntämällä aikaisempaa rakennetta; se ei poista tarvetta edustavalle arvioinnille, tarkalle tehtävänmäärittelylle, toimialan asiantuntemukselle tai turvalliselle varajärjestelmälle, kun uusi tehtävä poikkeaa tästä aiemmasta.
Käytännön esimerkki: vähäesimerkkinen luokittelu uudelle tuotteelle
Tukitiimi tarvitsee reititysmerkintöjä tuotteelle, jossa on vain viisi tarkistettua esimerkkiä per ongelma. Se vertaa lähimpiä prototyyppejä esikoulutetussa upotuksessa, lineaarista päätasoa, parametritehokasta hienosäätöä ja kontekstissa tapahtuvaa kehotteiden käyttöä. Tuoteperheet, asiakkaat ja myöhemmät viestit pidetään poissa meta‑koulutuksesta ja mallin valinnasta. Toistuva tukijoukon otanta raportoi luokan palautuksen, kalibroinnin, vaihtelun ja herkkyyden yhteen virheelliseen demonstraatioon.
Alhaisen luottamuksen ja tukemattomat viestit ohjataan yleiseen tukeen, ja tarkastajat korjaavat merkinnät hallitun jonon kautta. Esimerkit anonymisoidaan, versioidaan, eikä niitä koskaan valita lopullisesta testijoukosta. Seuranta kirjaa uutta sanastoa, luokkamääriä, korjauksia ja erimielisyyksiä. Kun riittävä määrä merkintöjä kertyy, vähäesimerkkinen järjestelmä verrataan tavalliseen valvottuun koulutukseen. Nopea käyttöönotto on hyödyllinen, mutta se ei oikeuta automaatiota, jos suorituskyky on epävakaa tai uusi tuote poikkeaa merkittävästi aikaisemmista tehtäväperheistä.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tuotokset, riippuvuudet, omistaja ja kunkin merkittävän epäonnistumisen seuraukset. Perusta toistettavissa oleva vertailupohja ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavallisia tapauksia, raja‑ehtoja, virheellisiä tai puuttuvia syötteitä, jakauman siirtymää, riippuvuuksien katkeamista, väärinkäyttöä sekä ryhmiä tai ympäristöjä, jotka todennäköisesti jäävät huomiotta. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Kirjaa jokainen muunnos ja kynnysarvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua nimeä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palautukseen ja elinkaaren lopettamiseen. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista seuranta tahallisesti injektoiduilla virheillä. Operatiivisen telemetrian tulee paljastaa syötteen laatu, tuotoksen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeettomia arkaluonteisia tietoja. Määritä hälytysrajat ja vastaavan omistaja, tarkastele sitten todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletettaisiin offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidut palautus‑, tapaustapaus‑oppimisen, poistamisen ja säilyttämisen menettelyt sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Onko yksiesimerkkinen oppiminen sama kuin vähäesimerkkinen oppiminen?
Yksiesimerkkinen oppiminen on erityistapaus, jossa on yksi merkitty tukiesimerkki per luokka tai tehtävä. Nollaesimerkkinen oppiminen käyttää lainkaan merkattuja kohdeesimerkkejä.
Poistaako vähäesimerkkinen oppiminen datan tarpeen?
Ei. Se siirtää riippuvuuden esikoulutuksen dataan, liittyviin tehtäviin, esityksiin ja oletuksiin. Kohdemerkinnät ovat harvat; oppimishistoria on yleensä laaja.
Ensisijaiset lähteet












