AI:n perusteet
Mikä on generatiivinen vastakkainen verkko (GAN)?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
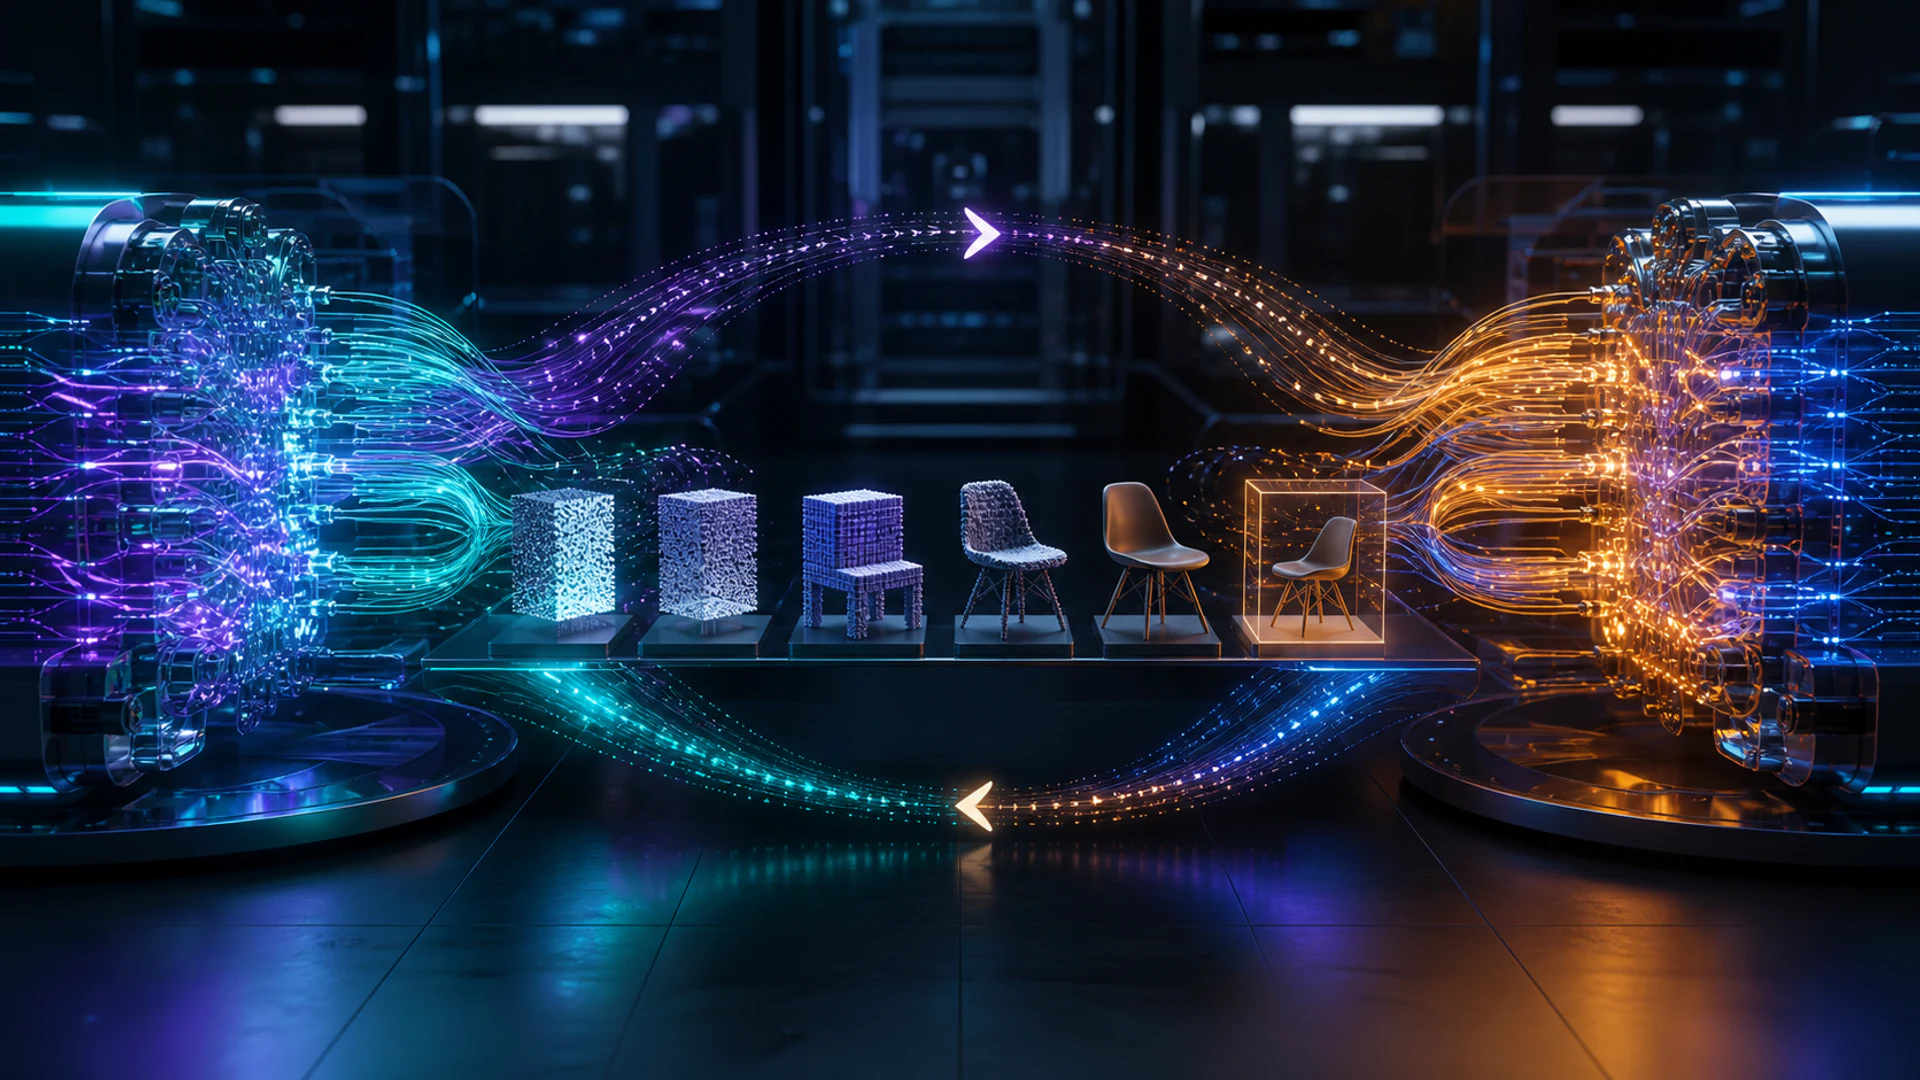
Generatiivinen vastakkainen verkko (GAN) kouluttaa kahta neuroverkkoa kilpaillessaan keskenään. Generaattori muuntaa satunnaisen tai ehdollistetun syötteen synteettisiksi näytteiksi. Diskriminaattori pyrkii erottamaan luodut näytteet todellisista harjoitusesimerkeistä. Kummankin verkon palaute muuttaa toisen oppimisongelmaa.
GANit voivat luoda teräviä kuvia ja hallittavaa synteettistä dataa, mutta vastakkainen koulutus on vaikea vakauttaa. Visuaalinen realismi ei ole todiste monimuotoisuudesta, faktuaalisesta pätevyydestä tai oikeudesta käyttää harjoitusdataa.
Keskeiset havainnot
- Generaattori tuottaa näytteitä; diskriminaattori oppii todellista ja luotua välistä päätössignaalin.
- Koulutus pyrkii tasapainoon, mutta vastustajan vaihtuminen voi aiheuttaa epävakautta, värähtelyä tai tilan romahtamista.
- Ehdolliset GANit ohjaavat generointia tunnisteilla, tekstillä tai muulla kontekstilla.
- Arvioinnin tulisi testata uskollisuutta, kattavuutta, muistamista ja jälkikäteen syntyviä riskejä – ei pelkästään kuvan laatua.
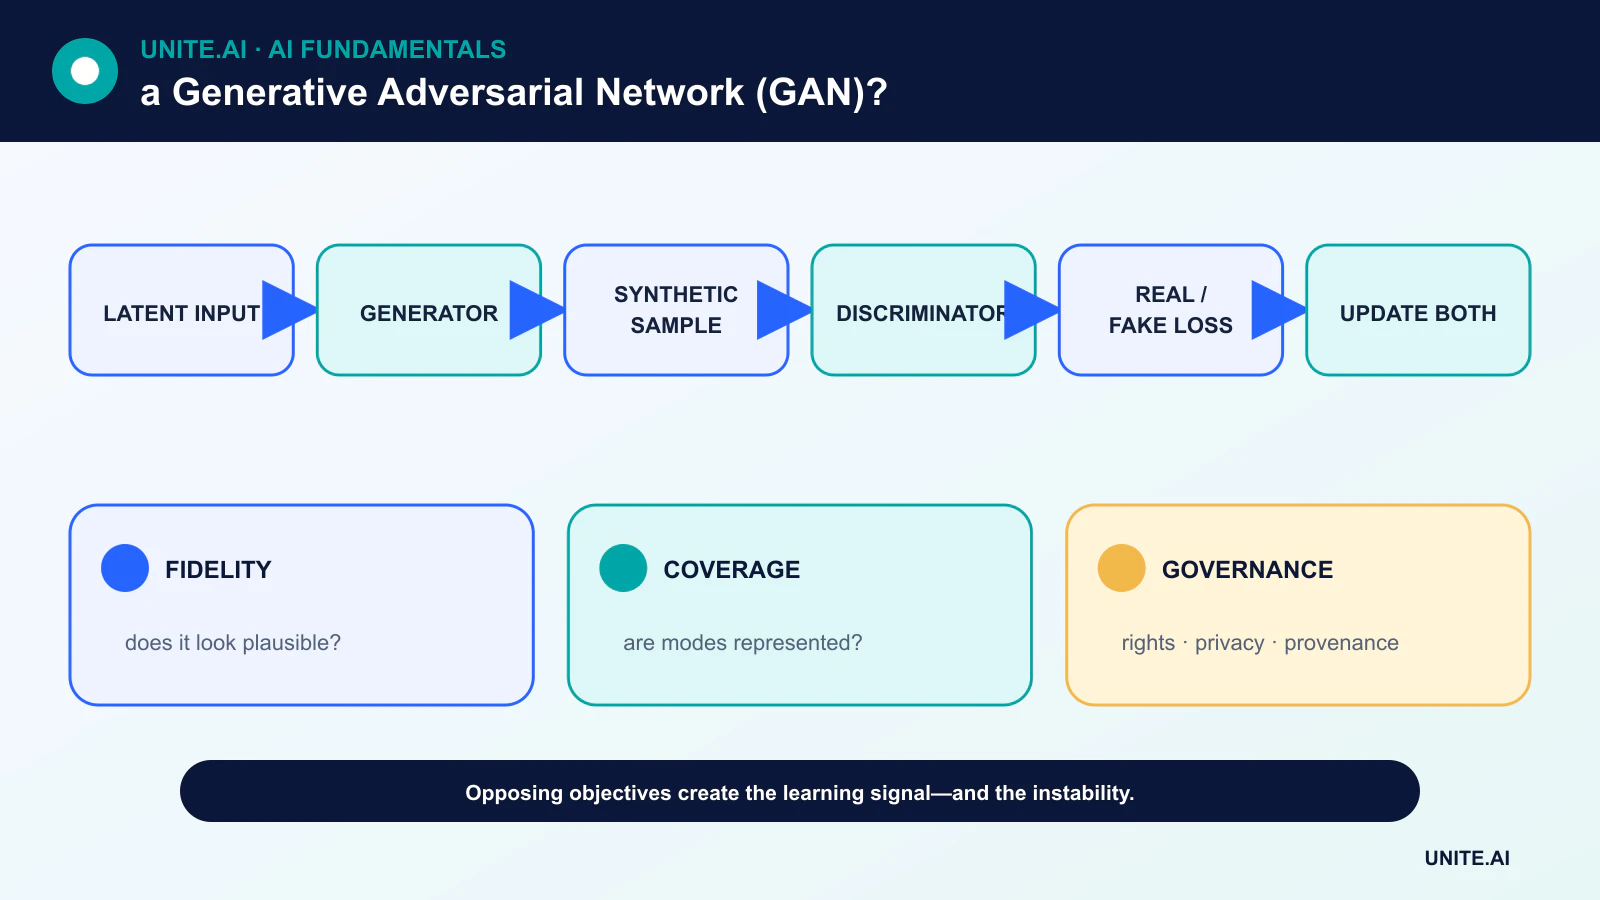
Vastakkainen peli
Alkuperäinen määritelmä on kahden pelaajan minimax-peli. Diskriminaattori parantaa kykyään erottaa todellinen data luodusta datasta, kun taas generaattori parantaa kykyään tuottaa näytteitä, jotka diskriminaattori luokittelee todellisiksi. Molemmat koulutetaan takaisinkytkennällä.
Jos diskriminaattori tulee liian tarkaksi, sen palaute generaattorille voi olla hyödyttömän. Jos se on liian heikko, generaattori voi hyödyntää helppoja oikoteitä. Koulutus siis vuorottelee päivityksiä ja tasapainottaa huolellisesti kapasiteettia, häviöitä ja optimointiasetuksia.
Tilojen romahtaminen ja koulutuksen vakaus
Tilojen romahtaminen tapahtuu, kun monet latentit syötteet tuottavat samankaltaisia tuloksia, jolloin näytteet vaikuttavat uskottavilta, mutta kattavat vain osan datajakaumasta. Muita epäonnistumisia ovat värähtely, räjähtävät gradientit ja herkkyys satunnaiselle alustusmenetelmälle.
Wasserstein-tavoitteet, gradienttipenaltyt, spektrinormointi, arkkitehtuurimuutokset ja viritetyt päivityssuhteet voivat parantaa vakautta. Ne eivät poista tarvetta tarkastaa monimuotoisuutta ja toistaa kokeita useilla siemenillä.
Ehdollinen generointi ja latentti kontrolli
Ehdollinen GAN tarjoaa generaattorille ja diskriminaattorille tunnisteen tai muun kontekstin, mahdollistaen kohdennetut luokat tai attribuutit. Tyylipohjaiset arkkitehtuurit erottavat latentin kontrollin osat eri resoluutioissa ja ovat tuottaneet erittäin realistisia kuvia.
Latentit suuntaukset voivat korreloida ihmiskäsitteiden kanssa, mutta yhden attribuutin muokkaaminen voi muuttaa toisia, koska harjoitusdata sisältää korreloivia piirteitä. Hallittavuusväitteet tulisi testata monipuolisilla identiteeteillä ja konteksteilla.
Arviointi, yksityisyys ja alkuperä
Mittarit kuten Fréchet Inception Distance vertailevat piirrejakaumia, mutta ne perivät oletuksia piirimallista ja voivat ohittaa muistamisen tai alaryhmien epäonnistumiset. Lähimmän naapurin analyysi, tarkkuus/kutsumis-tyyliset kattavuustestit ja ihmisen tarkastus tarjoavat täydentävää evidenssiä.
GAN voi muistaa harvinaisia esimerkkejä, toistaa vinoumia tai tuottaa harhaanjohtavaa mediaa. Tiimien tulisi dokumentoida datasetit, oikeudet, suodatus, vesileima- tai alkuperämekanismit sekä väärinkäyttökontrollit. Synteettinen data ei ole automaattisesti anonyymi.
GANit, VAE:t ja diffuusio-mallit
Variational autoencoders (VAE:t) optimoivat todennäköisyyspohjaista latenttitavoitetta ja vaihtavat usein näytteen terävyyden rakenteelliseen latenttitilaan. Diffuusio-mallit oppivat kääntämään kohinaprosessin ja ovat tulleet yleiseksi perustaksi kuvageneroinnissa.
GANit pysyvät hyödyllisinä, kun nopea yhden läpikäynnin näytteenotto, tietyt kuva-kuva-muunnokset tai kompakti käyttöönotto ovat tärkeitä. Oikea menetelmä riippuu laadusta, monimuotoisuudesta, latenssista, koulutuksen vakaudesta ja hallinnasta – ei siitä, mikä arkkitehtuuri on uusin.
Vastakkaiset tavoitteet ja koulutuksen dynamiikka
Generatiivinen vastakkainen verkko kouluttaa generaattorin tuottamaan näytteitä ja diskriminaattorin erottamaan luodun todellisesta datasta. Alkuperäisessä minimax-pelissä diskriminaattori arvioi tiheys-suhteeseen liittyvän signaalin ja generaattori yrittää huijata sitä. Koulutus vuorottelee päivityksiä, joten jokainen verkko oppii liikkuvaa vastustajaa vastaan eikä kiinteää häviötä. Jos diskriminaattori vahvistuu liikaa, generaattorin gradientit voivat muuttua hyödyttömiksi; jos se on liian heikko, luodun laadun kehittyminen pysähtyy. Pelkkä häviöarvo ei suoraan vastaa näytteen laatua.
Tilojen romahtaminen tapahtuu, kun generaattori tuottaa rajoitettuja variaatioita, jotka huijaavat diskriminaattorin. Värähtely, herkkyys hyperparametreihin ja epävakaa normalisointi ovat myös yleisiä. Wasserstein-tavoitteet, gradienttipenaltyt, spektrinormointi, piirteiden vastaavuus, minibatch-statistiikat ja huolellisesti tasapainotetut päivitysaikataulut käsittelevät eri epäonnistumismekanismeja. Ehdolliset GANit käyttävät tunnisteita, tekstiä tai kuvia ohjaamaan tulosta; tyylipohjaiset arkkitehtuurit erottavat latentit vaikutukset. Datasetin laatu ja kattavuus pysyvät perusasioina, koska generaattori toistaa ja yhdistää näkemänsä jakauman.
Arviointi ja vastuullinen käyttö
Arvioi uskollisuus ja monimuotoisuus erikseen. Fréchet Inception Distance vertailee piirrejakaumia, mutta riippuu otoskooksi, piirimallista, esikäsittelystä ja sovellusalueesta; Inception Score jättää pois vertailun todelliseen dataan. Tarkkuus ja palautus generatiivisille malleille, lähimmän naapurin analyysi, muistamisen tarkistukset ja ihmisen tehtäväarviointi lisäävät evidenssiä. Tieteellisessä tai lääketieteellisessä synteesissä käytä alaan liittyviä mittareita ja jatkokäytön validointia. Säilytä erillinen todellinen testijoukko ja vertaa diffuusio- tai autoregressiivisiin perusmalleihin vastaavilla laskenta- ja resoluutiotasoilla.
GANit voivat täydentää dataa, kääntää alueita, superresolvoida kuvia, synteettisesti luoda mediaa ja tukea simulointia, mutta synteettinen data voi vahvistaa vinoumia tai vuotaa harjoitusesimerkkejä. Varmista lisensointi, suostumus, henkilöllisyys ja alkuperä. Suojaa ei‑suostumukselliselta henkilönimitäykseltä ja harhaanjohtavalta käytöltä, merkitse tai allekirjoita tuotokset tarpeen mukaan ja säilytä generointimetatiedot. Valokuvarealistinen kuva ei ole todiste; epävarmuus ja synteettinen alkuperä on pidettävä näkyvissä, kun tuotokset vaikuttavat päätöksiin.
Käyttöönotto ja toistettavuus
Tallenna generaattorin, diskriminaattorin, optimointialgoritmin, datasetin, satunnaissiementen, truncation- ja näytteenottiasetukset. Kvantisointi tai vienti voi muuttaa normalisointia ja tulostetta, joten validoi palveluartefakti. Seuraa kehotteiden tai ehtojen jakaumaa, turvallisuussuodattimia, tulosteen monimuotoisuutta, latenssia ja raportteja. Käytä nopeusrajoituksia ja henkilöllisyysvarmistuksia julkisissa järjestelmissä. GAN‑koulutus on kytketty optimointikoe: valitut esittelykuvat eivät voi todistaa vakautta, kattavuutta tai muistamisen puuttumista, ja mallia tulisi arvioida koko suunnitellun generointitehtävän jakaumassa.
Käytännön esimerkki: synteettiset vikakuva GANilla
Valmistaja kouluttaa ehdollisen GANin luomaan harvinaisia pintavauriokuvia. Se varmistaa, että harjoituskuvilla on oikeudet ja erottaa tuotantolot ennen koulutusta ja arviointia. Luodut näytteet tarkistetaan lähimmän naapurin muistamisen, vauriogeometrian, taustahäiriöiden, monimuotoisuuden ja asiantuntijan uskottavuuden perusteella. Synteettisellä augmentaatiolla koulutettua luokittelijaa arvioidaan vain itsenäisillä todellisilla vaurioilla, verrattuna samaan luokittelijaan perinteisellä augmentaatiolla.
Synteettinen data hyväksytään vain, jos todellisessa maailmassa tarkkuus paranee ilman väärien hylkäysten tai alaryhmien virheiden lisääntymistä. Generointiasetukset ja alkuperä pysyvät liitettyinä jokaiselle kuvalle, eikä synteettisiä tiedostoja koskaan lisätä testijoukkoon tai todistearkistoon todellisina tarkastuksina. Operaattorit eivät voi käyttää generaattoria luodakseen auditointitietueita. Tiimi vertaa diffuusioalternatiiveja ja todellisten esimerkkien keräämisen kustannuksia, tunnustaen että realistinen ulkonäkö ei ole todiste siitä, että GAN on tallentanut fyysisen vikaprosessin.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versionoitua arviointijoukkoa ennen hienosäätöä. Testaa tavalliset tapaukset, reunaehtoja, virheellisiä tai puuttuvia syötteitä, jakauman siirtymää, riippuvuuksien katkeamista, väärinkäyttöä sekä ryhmät tai ympäristöt, joille palvelu todennäköisesti puuttuu. Mittaa tehtävän laatua yhdessä kalibroinnin tai epävarmuuden, latenssin, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja raja-arvo, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen käyttöönottoa nimeä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistamiselle. Käytä vaiheittaista käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tarkoituksellisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien kunto, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluontoista dataa. Määritä hälytysrajat ja vastaavan omistaja, tarkastele sitten todellisia todisteita käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Ymmärtääkö GAN luomiaan kuvia?
GAN oppii tilastollista rakennetta, joka on hyödyllinen generoinnissa. Tämä ei kuitenkaan itsessään todista ihmisen kaltaista semanttista tai kausaalista ymmärrystä.
Ovatko GANin tuottamat näytteet turvallisia käyttää harjoitusdatana?
Vain tarkistettuasi kattavuuden, tunnisteiden pätevyyden, muistamisen, vinouman sekä sen, auttaako synteettinen jakauma todellisessa erillisessä testijoukossa.
Ensisijaiset viitteet