AI:n perusteet
Mikä on K-means-klusterointi?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
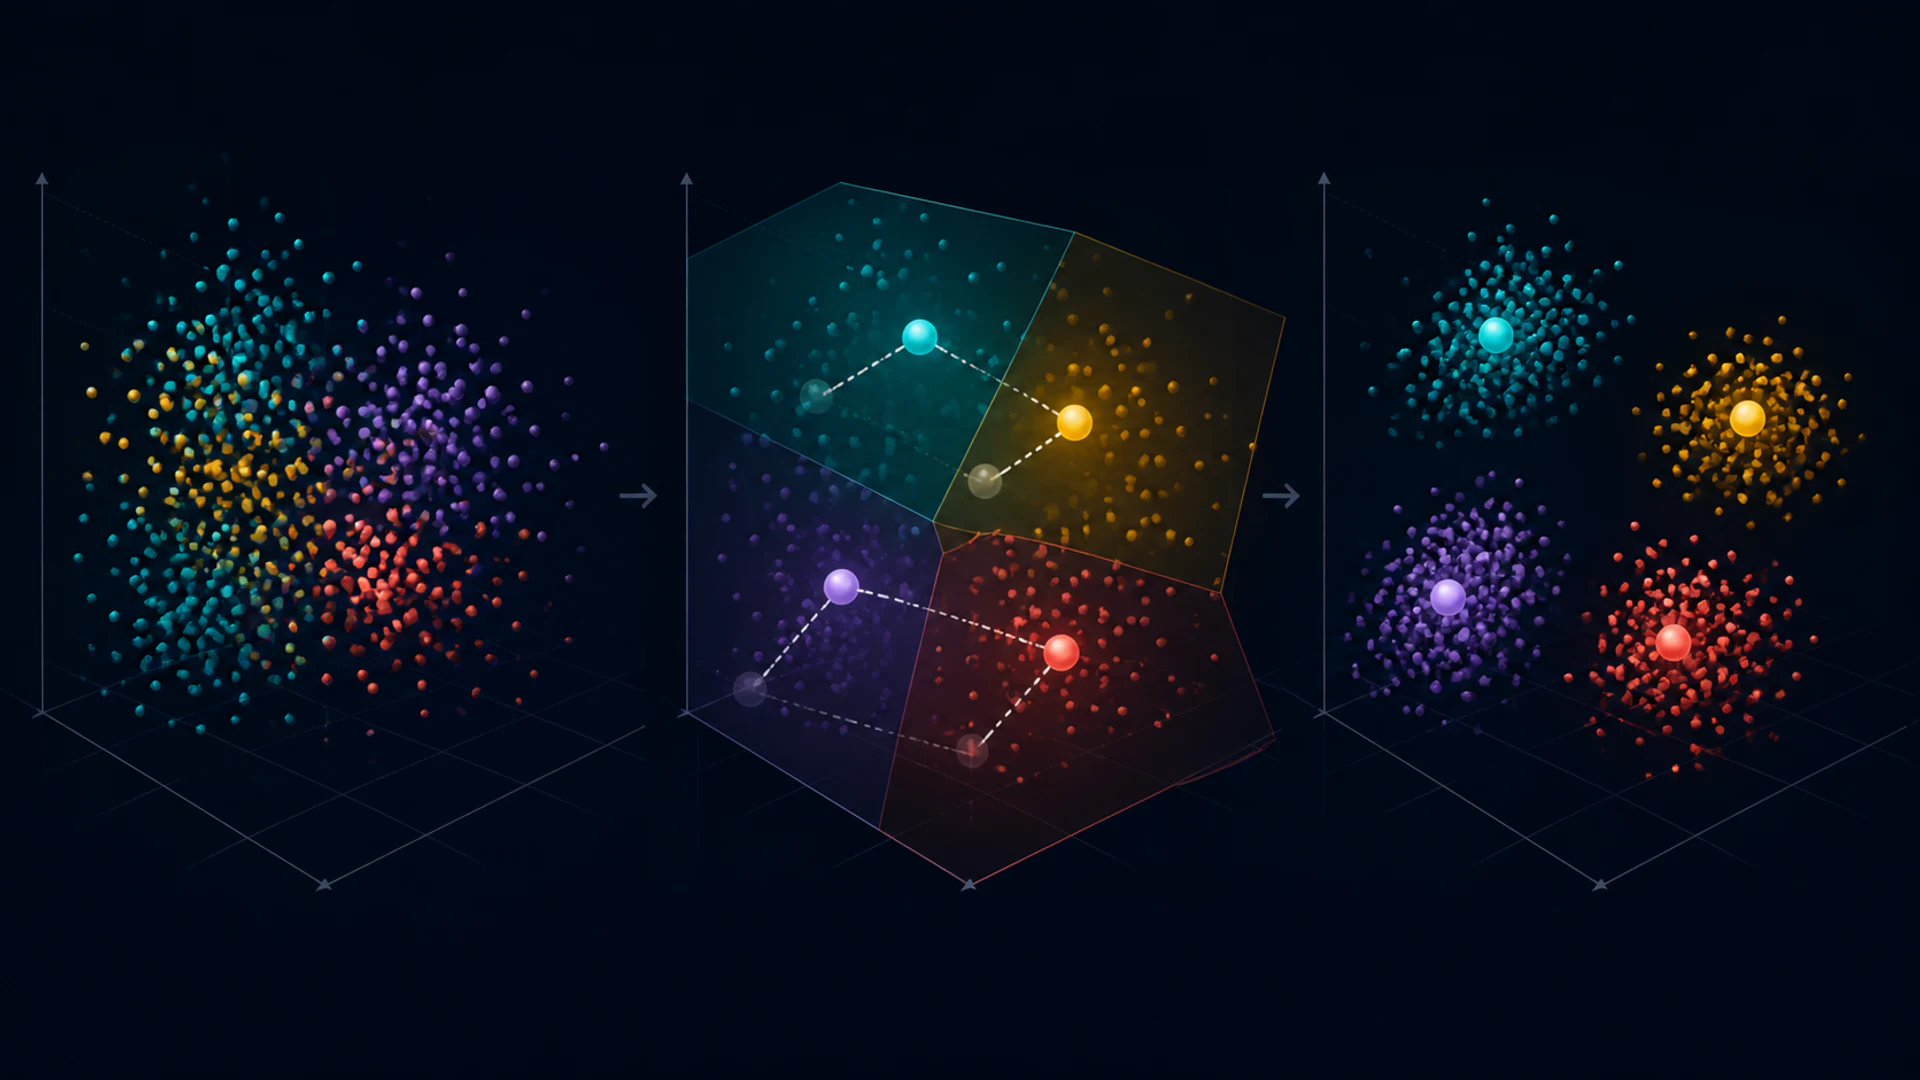
K-means on valvomaton algoritmi, joka jakaa numeeriset havainnot k klusteriin. Se vuorottelee pisteiden kohdistamista lähimpään keskipisteeseen ja jokaisen keskipisteen uudelleenlaskentaa sen kohdistettujen pisteiden keskiarvona.
Algoritmi on nopea ja hyödyllinen, mutta sen tulos riippuu skaalaamisesta, etäisyydestä, alustusmenetelmästä ja valitusta k:stä. Klusteri on matemaattinen jakautuma, ei automaattisesti todellinen maailmallinen luokka.
Keskeiset havainnot
- K-means minimoi klusterin sisäisen neliöllisen euklidisen etäisyyden keskipisteisiin.
- Alustus on tärkeä; k-means++ hajauttaa alkukeskipisteet ja parantaa yleensä tuloksia.
- Standardoi ominaisuudet, kun niiden yksiköiden tai skaalausten tulisi vaikuttaa vertailukelpoisesti.
- K-means kamppailee poikkeavien havaintojen, epäpallomaisten klustereiden, epätasaisen tiheyden ja kategorisen datan kanssa.
Tavoite ja päivityssilmukka
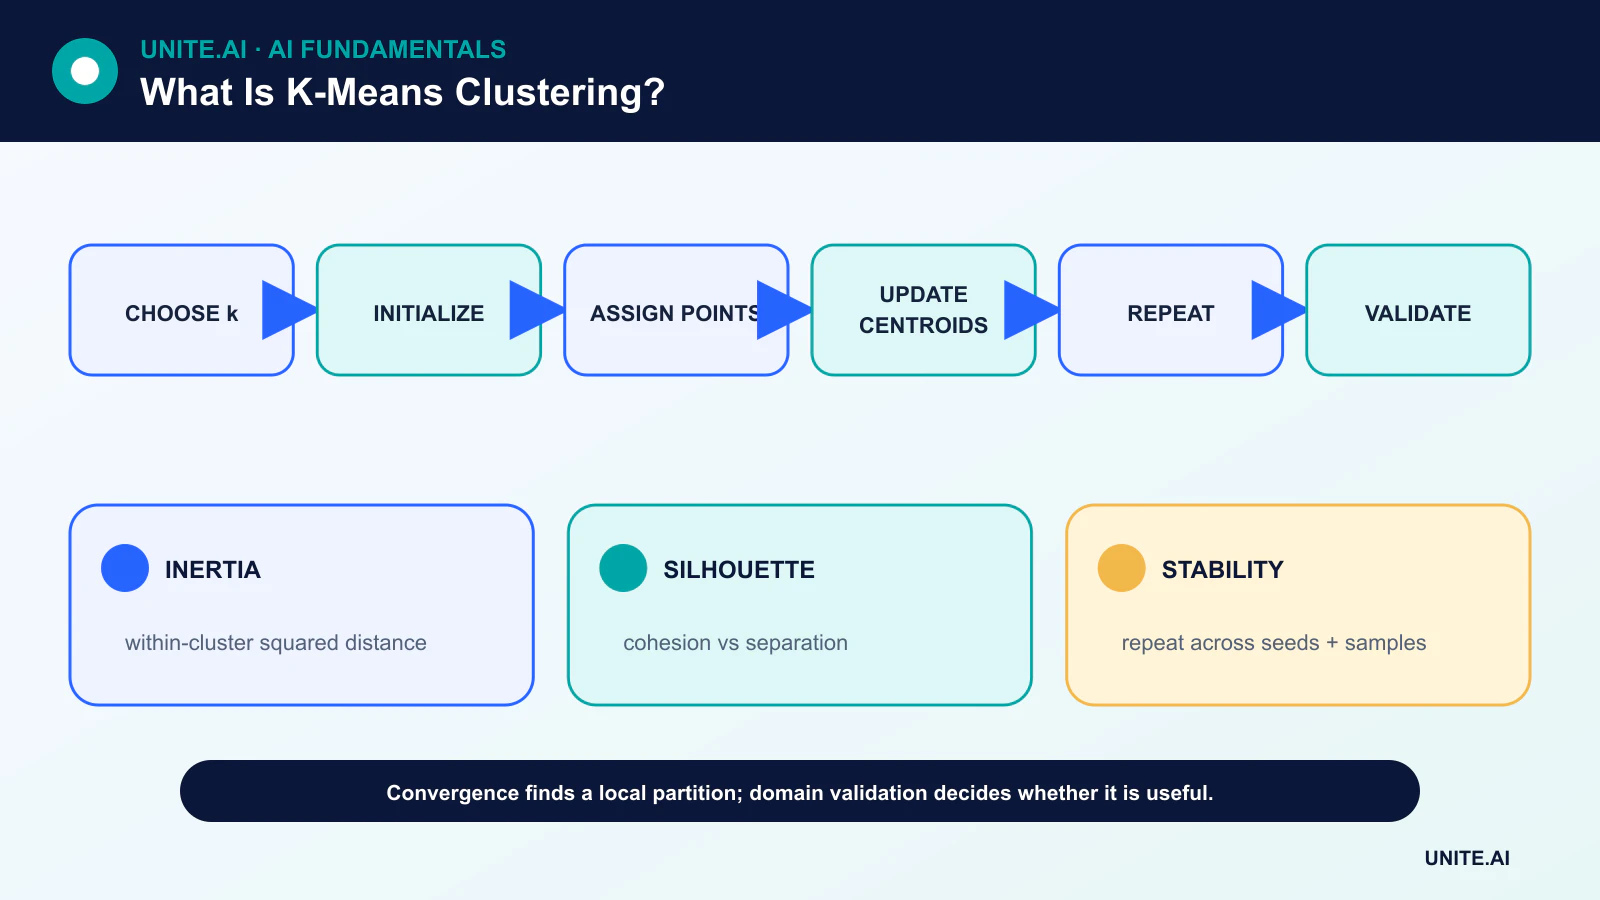
Kun on k keskipistettä, sijoitusvaihe lähettää jokaisen havainnon lähimpään niistä. Päivitysvaihe korvaa jokaisen keskipisteen sen kohdistettujen havaintojen keskiarvolla. Klusterin sisäinen neliösumma ei voi kasvaa näiden vaiheiden aikana, joten prosessi konvergoi paikalliseen optimumiin.
Konvergenssi ei takaa globaalia optimumia. Eri alkukeskipisteet voivat johtaa erilaisiin jakautumiin, minkä vuoksi toteutukset suorittavat useita aloituksia ja säilyttävät ratkaisun, jossa on alhaisin inertia.
Alustus ja k-means++
Satunnaisesti valitut kaikki alkukeskipisteet yhdestä tiheästä alueesta voivat tuottaa huonon ratkaisun tai hidastaa konvergenssia. K-means++ valitsee siemenet todennäköisyydellä, joka riippuu etäisyydestä olemassa oleviin siemeniin, mikä edistää aineiston kattavuutta.
Useita suorituksia on edelleen hyödyllistä. Tallenna satunnainen siemen ja aloitusten määrä, jotta tulokset voidaan toistaa.
Skaalaus ja etäisyys
Neliöllinen euklidinen etäisyys tekee K-meansista herkästi yksiköiden vaikutukselle. Ominaisuus, joka mitataan tuhansissa, voi hallita toista, joka mitataan nollan ja yhden välillä. Standardointi on yleistä, mutta toimialan tuntemus tulisi päättää, heijastaako yhtäläinen standardoitu varianssi yhtä suurta merkitystä.
Poikkeamat voivat vetää keskiarvon kauas tyypillisistä pisteistä. Kestävä skaalaus, leikkaus tai medoidipohjaiset menetelmät voivat olla parempia. Yksi‑kuuma (one‑hot) kategoriset ominaisuudet luovat etäisyysgeometrian, joka ei välttämättä vastaa kategorioiden samankaltaisuutta.
K:n valinta ja klustereiden validointi
Inertia pienenee aina, kun k kasvaa, joten se ei voi yksin valita k:ta. Kylkiluu‑heuristiikka etsii heikentyvää parannusta. Siluettianalyysi vertaa koheesiota ja erottavuutta. Vakavuus eri otoksissa ja siemenissä lisää toisen tarkistuksen.
Vahvin validointi on hyödyllisyys suunnitellussa toimialassa. Vertaa klustereita tunnettuihin tuloksiin, asiantuntijakatselmuksiin tai alavirtaan tehtävään ilman, että väittäisi jälkikäteen löydettyjen tunnisteiden olevan objektiivisesti havaittuja.
Rajat ja vaihtoehdot
K-means suosii kompakteja, suunnilleen pallomaisia ryhmiä, joilla on samankaltainen mittakaava. Gaussisen sekoitusmallit (Gaussian mixture models) edustavat todennäköisiä ellipsoidaalisia komponentteja; DBSCAN‑tyyliset menetelmät tunnistavat tiheitä alueita ja kohinaa; hierarkkinen klusterointi tuottaa yhdistymispuun.
Dimensionality reduction voi parantaa nopeutta tai poistaa kohinaa syötteistä, mutta sen sovittaminen koko aineistoon voi muuttaa validointikysymyksen. Mini‑batch K-means vähentää laskentaa suurille aineistoille tarkkuuden kustannuksella, koska päivitys on likimääräinen.
Tavoite, alustus ja konvergenssi
K-means jakaa numeeriset havainnot k klusteriin minimoimalla klusterin sisäisen neliöllisen euklidisen etäisyyden keskipisteisiin. Lloydin algoritmi vuorottelee pisteiden kohdistamista lähimpään keskipisteeseen ja keskipisteiden uudelleenlaskentaa, kunnes sijoitukset tai tavoite vakautuvat. Se konvergoi paikalliseen optimumiin, ei välttämättä globaaliin parhaaseen. K-means++‑alustus hajauttaa alkukeskipisteet ja yleensä parantaa tuloksia, mutta useat siemenet pysyvät tärkeinä. Standardoi ominaisuudet, kun yksiköiden tulisi vaikuttaa vertailukelpoisesti, koska neliöllinen etäisyys korostaa suurta skaalaa omaavia muuttujia ja poikkeamia.
Menetelmä olettaa suunnilleen kompakteja, pallomaisia ja samankaltaisesti skaalattuja klustereita euklidisen geometrian alla. Se kamppailee venyvien monistojen, epätasaisen tiheyden, kategorisen datan, voimakkaiden poikkeamien ja sisäkkäisen rakenteen kanssa. Tyhjät klusterit ja päällekkäiset pisteet vaativat määritellyn käsittelyn. Mini‑batch k-means skaalautuu suuriin datoihin likimääräisen vaihtokustannuksen avulla. Harvassa tekstissä kosiniin perustuva pallomainen k-means voi paremmin vastata suuntaa, kun taas sekoitukset, tiheysmenetelmät, hierarkkinen klusterointi tai k‑medoidit koodaavat muita oletuksia.
K:n valinta ja merkityksen validointi
Kylkiluu‑käyrät, siluettipisteet, informaatiokriteerit liittyvissä malleissa ja vakavuus voivat ohjata k:n valintaa, mutta mikään ei löydä yksiselitteisesti oikeaa lukua. Liiketoiminnan hyödyllisyys ja toimialan tulkinta ovat tärkeitä. Sovita uudelleen eri otoksissa ja siemenissä, vertaa keskipisteiden liikettä ja sijoituksen johdonmukaisuutta, ja validoi klusterit riippumattomilla tuloksilla, joita ei ole käytetty niiden muodostamiseen. Kaksidimensionaalinen projekti voi vääristää erottavuutta, joten tarkastele etäisyyksiä ja esimerkkejä alkuperäisessä tai validoidussa esitystilassa.
Klusterit ovat kuvailevia ryhmiä, jotka on luotu valittujen ominaisuuksien ja mittarin perusteella; ne eivät ole luonnollisia luokkia tai kausaalisia segmenttejä. Samojen muuttujien perusteella luodut profiilit voivat olla syklisiä. Käytä pidätettyjä attribuutteja ja kvalitatiivista tarkastelua, ja tutki, toistavatko klusterit ensisijaisesti maantiedon, datalähteen tai herkkiä piirteitä. Pienet klusterit voivat olla poikkeamia tai artefakteja. Klusterin nimeäminen ei tee jokaisesta jäsenestä sopivaa nimeä.
Käyttöönotto ja ylläpito
Tallenna skaalaus, ominaisuuksien järjestys, keskipisteet, etäisyyden määritelmä ja klusteritunnisteet yhdessä. Uusille pisteille seuraa etäisyyttä kohdistettuun keskipisteeseen ja osuutta, joka on kaukana koulutuksen tukialueesta; tarjoa tuntematon tila sen sijaan, että pakotetaan jokainen tapaus klusteriin. Seuraa klusterien kokoa, keskipisteitä ja tulosten merkitystä ajan myötä. Uudelleenkoulutus muuttaa klusterien identiteettejä, joten kartoitus tai versiointi alavirran säännöille on suositeltavaa sen sijaan, että hiljaisesti käytettäisiin vanhoja nimiä. K-means on hyödyllinen pakkaus‑ ja segmentointiperusta, kun sen geometria vastaa kysymystä, ei kuitenkaan yleinen löytömoottori.
Käytännön esimerkki: asiakassegmentointi k-meansilla
Tilauksia tarjoava yritys standardoi käyttöominaisuudet kiinteän aikavälin yli, poistaa tilitunnisteet ja testaa k:n eri siemenillä. Vakautta, siluettia ja pidätettyjä liiketoiminnan tuloksia tarkastellaan, mutta tuote‑tiimit myös tutkivat edustavia ja raja‑tilejä. He havaitsevat, että yksi klusteri on yksinkertaisesti uudet asiakkaat, joilla on lyhyempi havaintoaika, joten asiakkuuden kesto käsitellään erikseen. K‑meansia verrataan hierarkkisiin ja tiheysperusteisiin vaihtoehtoihin sen oletetun sopivuuden sijaan. Harjoitus käsitellään valvomattomana oppimisena, ei tunnisteiden löytönä.
Segmentit ohjaavat tutkimus‑ ja viestintä‑kokeita, eivät kelpoisuutta tai hintaa. Uudet tilit, jotka ovat kaukana kaikista keskipisteistä, saavat tuntemattoman sijoituksen. Skaalaus, ominaisuudet, keskipisteet ja nimet versioidaan, ja uudelleenkoulutus kartoittaa uudet klusterit vanhoihin vain todisteiden perusteella. Seuranta seuraa klusterikokoa, etäisyyttä ja tulosten merkitystä. Herkkiä attribuutteja ja välillisiä tekijöitä tarkastellaan, ja tiimi välttää kuvaamasta klustereita luonnollisina persoonallisuustyyppeinä, kun ne ovat valittujen käyttäytymisten matemaattisia jakautumia.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja kunkin tärkeän vikojen seuraukset. Perusta toistettavissa oleva peruslinja ja versioitu arviointijoukko ennen säätöä. Testaa tavalliset tapaukset, reunatilat, virheelliset tai puuttuvat syötteet, jakauman siirtymä, riippuvuuksien katkos, väärinkäyttö sekä ryhmät tai ympäristöt, joilla on todennäköisesti alipalvelua. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenon, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta nimeä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palautukseen ja elinkaaren lopettamiseen. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varmistus ja varmista seuranta tarkoituksellisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeettomia arkaluontoisia tietoja. Määritä hälytyskynnysarvot ja vastuutahot, ja tarkastele todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina, kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa tai korvata.
Usein kysytyt kysymykset
Onko K-means valvottu vai valvomaton?
Se on valvomaton, koska se saa ominaisuuksia ja valitun klustermäärän, eikä kohdetunnisteita.
Luokitteleeko K-means uutta dataa?
Sovituksen jälkeen uusi piste voidaan kohdistaa lähimpään keskipisteeseen. Tämä on klusterisijoitus, ei välttämättä valvottu luokkaprediktio.
Ensisijaiset viitteet