
AI:n perusteet
Mikä on KNN (K‑lähimmät naapurit)?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
K-lähimmät naapurit (KNN) ennustaa tuloksen merkityllisistä koulutusesimerkeistä, jotka ovat lähimpänä hakupistettä. Luokittelussa naapurit äänestävät luokkaa. Regressiossa niiden kohdearvot keskiarvostetaan tai yhdistetään muulla tavoin.
KNN on tapausperusteinen, yleistämätön menetelmä: sovittaminen tallentaa pääosin koulutusesimerkit ja valinnaisen hakemiston. Tämä ei poista tarvetta koulutus‑, validointi‑ ja testijakoihin. Mallin arviointi pidetyn datan avulla on olennaista k:n, etäisyysmetriikan, piirteiden käsittelyn ja äänestyskäytännön valinnassa.
Keskeiset havainnot
- KNN ennustaa paikallisesti; se ei ensin jaa aineistoa klustereihin.
- Piirteiden skaalaus on kriittinen, koska etäisyys määrittää, mitkä esimerkit lasketaan naapureiksi.
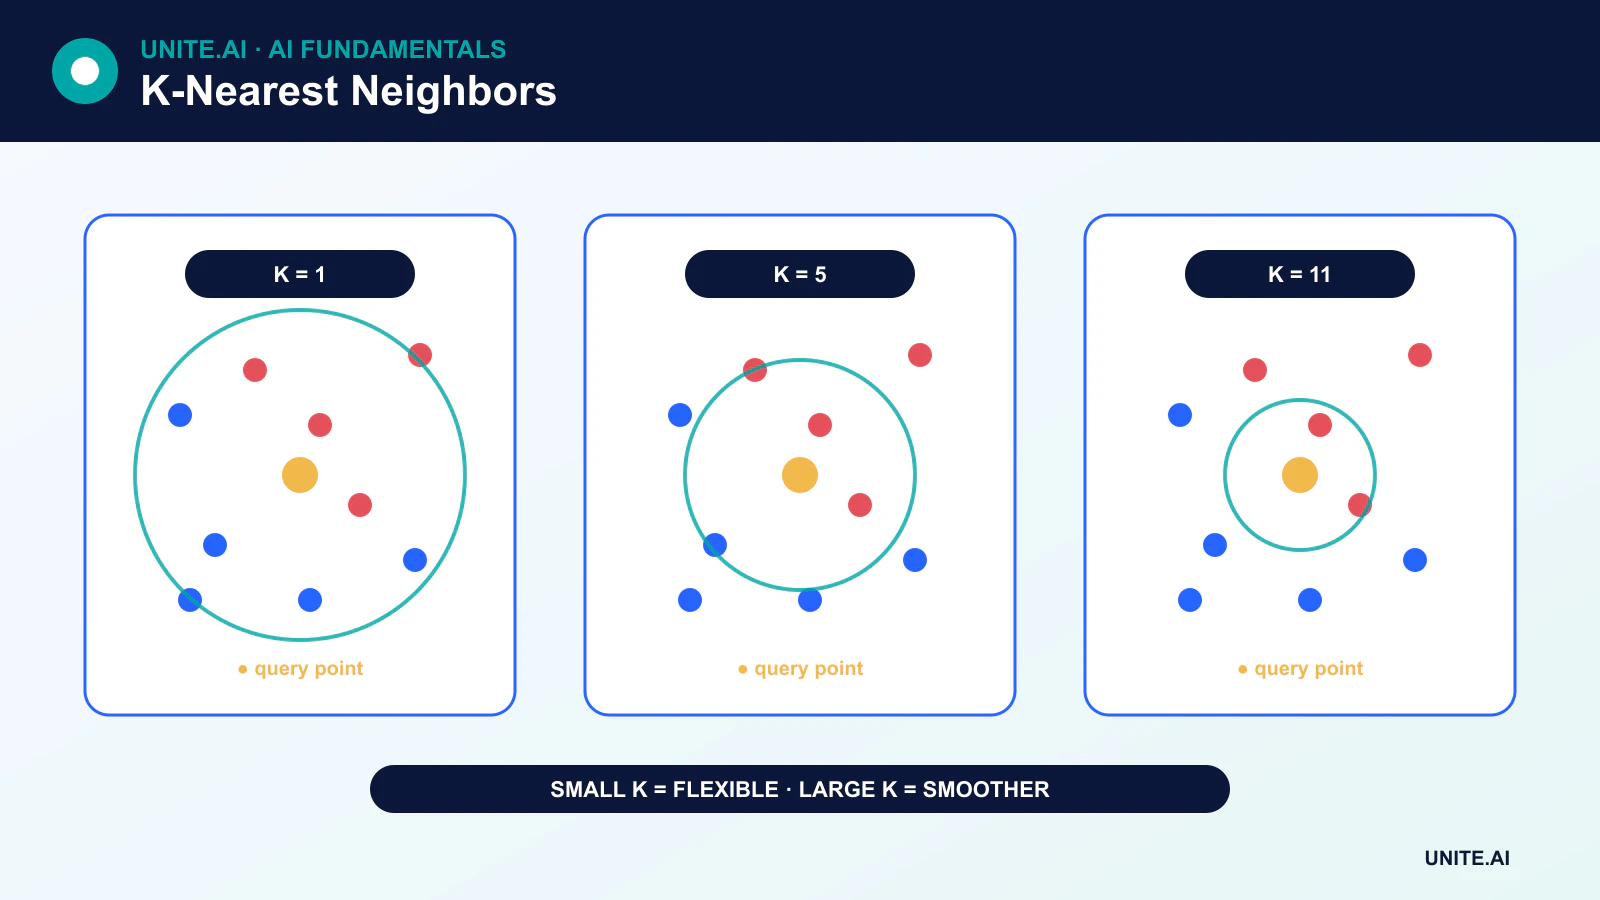
- Pieni k voi olla meluinen, kun taas suuri k voi tasoittaa paikallisen rakenteen.
- Korkeaulotteisuus, merkityksettömät piirteet, luokkien epätasapaino ja hidas haku voivat rajoittaa suorituskykyä.
Miten KNN‑luokittelu toimii
- Esitä kysely ja koulutusesimerkit samassa piirteiden avaruudessa.
- Laske etäisyys kyselystä koulutusesimerkkeihin.
- Valitse k lähintä esimerkkiä.
- Ennusta enemmistöluokka tai käytä etäisyyspainotettua äänestystä.
Painotettu äänestys antaa läheisemmille naapureille suuremman vaikutusvallan. Tasapelit vaativat dokumentoidun säännön, ja yhtä kaukana olevat naapurit, joilla on eri luokat, voivat tehdä tuloksista riippuvaisia järjestyksestä tai toteutuksen yksityiskohdista.
KNN‑regressio
Regressiossa ennuste on tavallisesti naapurien kohdearvojen keskiarvo. Etäisyyspainotus voi vähentää kauempien havaintojen vaikutusta. Mediaani tai kestävä aggregointi voi olla hyödyllistä, kun paikalliset kohteet sisältävät poikkeamia.
Etäisyysmetriikat
Euklidinen etäisyys on yleinen jatkuville piirteille, Manhattan‑etäisyys summaa absoluuttiset erot, ja kosinietäisyys keskittyy suuntaan eikä suuruuteen. Muita metriikoita käytetään binäärisiin, kategorisiin, maantieteellisiin, sekvenssi‑ tai opittuihin upotustietoihin.
KNN:n kutsuminen “ei‑parametriseksi” tarkoittaa, ettei se oletuksena ole kiinteää äärellisen‑ulotteista funktiomuotoa päätösrajalle. Se kuitenkin olettaa, että valittu esitys ja metriikka tekevät lähellä olevista pisteistä merkityksellisiä toistensa suhteen.
Miksi skaalaus on tärkeää
Jos yksi piirre vaihtelee välillä 0–1 ja toinen 0–100 000, tavallinen euklidinen etäisyys hallitsee toinen piirre. Standardisointi, normalisointi tai toimialakohtaiset muunnokset tulisi sovittaa koulutusosioon ja soveltaa validointi‑, test‑ ja tuotantodataan.
Merkityksettömät piirteet vääristävät myös naapurustoja. Piirteiden valinta, ulottuvuuden vähentäminen tai opitut esitykset voivat auttaa, mutta jokainen valinta on validoitava ilman tietovuotoja.
K:n valinta
Kun k = 1, malli voi seurata kohinaa ja väärin merkittyjä esimerkkejä. Kun k kasvaa, ennusteet tasoittuvat ja ovat vähemmän herkkiä yksittäiselle pisteelle. Jos k on liian suuri, kaukaiset luokat tai alueet hallitsevat ja malli alijäsentyy.
Valitse k ristiinvalidoinnin avulla koulutusdatasta. Binäärisessä luokittelussa pariton k vähentää, mutta ei poista tasapelejä. Luokkapainot, stratifioidut jaot, raja‑arvon valinta ja sopivat mittarit ovat tärkeitä, kun luokat ovat epätasapainossa.
Korkeaulotteisuuden kirous
Korkeaulotteisissa avaruuksissa etäisyydet voivat menettää informatiivisuutensa, koska esimerkit ovat harvoja ja lähimmän sekä kauimman etäisyys lähestyvät toisiaan. KNN voi vaatia valtavan määrän dataa merkityksellisten paikallisten naapurustojen ylläpitämiseksi. Tämä on korkeaulotteisuuden kirous.
Ulottuvuuden vähentäminen tai tehtäväkohtaiset upotukset voivat auttaa, mutta upotuksen geometria tulee validoida halutun samankaltaisuuskäsitteen osalta.
Haun suorituskyky
Brute‑force‑kysely vertaa uutta pistettä kaikkiin tallennettuihin esimerkkeihin. KD‑puut ja pallopuut nopeuttavat joitakin tarkkoja hakuja, vaikka niiden hyödyt vähenevät korkeaulotteisuudessa. Approximaalinen lähimmän naapurin indeksi vaihtaa pienen määrän recall‑arvoa suuriin nopeus‑ ja muistihyötyihin. Tämä ajatus on myös vektorisimilaarisuushakujen perusta.
Vahvuudet ja rajoitukset
KNN on yksinkertainen, tukee epäsäännöllisiä päätösrajoja ja tarjoaa intuitiivisen esimerkkipohjaisen selityksen. Se voi kuitenkin vaatia merkittävää muistia, paljastaa arkaluontoisia koulutusesimerkkejä, ennustaa hitaasti ja käyttäytyä huonosti, kun etäisyys ei ole merkityksellinen. Se on hyödyllinen perusmalli — ei menetelmä, joka on oletuksena erittäin tarkka useimmissa ongelmissa.
Etäisyys, naapurustot ja hyperparametrien käyttäytyminen
K‑lähimmät naapurit tallentavat koulutusesimerkit ja ennustavat k:n lähimmän valitun etäisyyden perusteella. Luokittelu käyttää enemmistö‑ tai etäisyyspainotettua äänestystä; regressio keskiarvoistaa naapureiden kohteet. Skaalaus on olennaista, koska suuri‑alueinen piirre voi hallita euklidista etäisyyttä. Kategoriset, harvat, sekvenssi‑ tai maantieteelliset tiedot saattavat vaatia Hamming‑, kosini‑, edit‑, suurympyrä‑ tai opittuja etäisyyksiä. Metriikka on mallinnusolettamus samankaltaisuudesta, ja sen tulee olla validoitu lähellä olevien tapausten todellisen merkityksen perusteella.
Pieni k luo joustavia, korkean varianssin rajoja ja herkkyyttä kohinalle; suuri k tasoittaa ennusteita ja voi poistaa vähemmistörakenteen. Pariton k välttää vain joitakin binääritasapelejä eikä ole yleissääntö. Valitse k, etäisyys, painotus, piirrejoukko ja esikäsittely ristiinvalidoinnin sisällä. Luokkien epätasapaino voi saada paikallisen enemmistöäänestyksen ohittamaan harvinaiset tulokset, joten tarkastele luokko‑kohtaisia recall‑arvoja ja naapuruston koostumusta. Korkeaulotteiset etäisyydet pyrkivät keskittymään, ja merkityksettömät piirteet heikentävät naapurustoja; valinta, ulottuvuuden vähentäminen tai opitut upotukset voivat auttaa.
Indeksointi, epävarmuus ja tuotantokäyttö
Niinpä yksinkertainen inferenssi vertaa kyselyn kaikkiin koulutuspisteisiin. KD‑puut ja pallopuut auttavat sopivissa matalan ulottuvuuden tilanteissa; approximaalinen lähimmän naapurin indeksi vaihtaa tarkkuutta nopeuteen ja mittakaavaan. Mittaa naapurihakujen recall‑arvo erikseen ennusteen laadusta. Muisti sisältää tallennetut piirteet, luokat ja indeksirakenteet. Päivitykset ovat käsitteellisesti yksinkertaisia, mutta voivat vaatia indeksin uudelleenrakennusta, versioyhtenäisyyttä ja poistojen levittämistä. Suojaa arkaluontoiset koulutusesimerkit, koska naapureiden tai etäisyyksien palauttaminen voi paljastaa tietoja.
KNN voi tuoda esiin esimerkkejä, jotka tekevät ennusteen ymmärrettäväksi, mutta läheisyys ei ole syy‑seuraussuhde eikä oikeudenmukaisuus. Tarjoa etäisyys, äänestysmarginaali ja abstinenssisääntö, kun naapurustot ovat harvoja tai ristiriitaisia. Seuraa kyselyn etäisyyttä, naapureiden luokkia, piirteiden muutosta, viivettä ja vahvistettuja tuloksia. Pidä esikäsittely‑ ja indeksiversiot synkronoituna, ja testaa tarkat vs. approksimaattiset tulokset muutosten jälkeen. KNN on tehokas paikallinen perusmalli ja hakumenetelmä, kun etäisyys on merkityksellinen; se kamppailee, kun samankaltaisuutta ei voida esittää käytettävissä olevilla piirteillä.
Käytännön esimerkki: KNN tuotesubstituutiolle
Vähittäiskauppias kuvaa tuotteet standardoiduilla numeerisilla ominaisuuksilla, kategorisella yhteensopivuudella ja opitulla tekstiuudistuksella, ja määrittelee kaupallisten tarkastelijoiden tarkistaman painotetun etäisyyden. K ja painot valitaan myöhempien tuotelanseerauksien perusteella, ei satunnaisista riveistä. Arviointi tarkistaa asiaankuuluvan substituuttien recall‑arvon, yhteensopimattomat suositukset, etäisyyden, kategorian kattavuuden ja harvinaisten tuotteiden tulokset. Suosituimmuusperusta osoittaa, lisääkö paikallinen samankaltaisuus arvoa.
Approksimaattinen indeksi benchmarkataan tarkkoja naapureita vastaan recall‑arvon ja viiveen osalta. Kyselyt, joilla ei ole lähellä olevaa yhteensopivaa tuotetta, palauttavat ehdotuksen puuttumisen sen sijaan, että pakotettaisiin naapuri. Tuotepäivitykset ja attribuuttikorjaukset siirtyvät indeksiin versioitujen päivitysten kautta. Seuranta tallentaa etäisyysjakaumat, tyhjät tulokset, ohitukset ja kaupalliset tulokset sekoittamatta myyntiä todelliseen yhteensopivuuteen. Arkaluontoiset toimittajatermit jätetään selityksistä pois, ja palautetut esimerkit ovat todisteita samankaltaisuudesta — ei väitettä, että tuotteet olisivat yhtäpitäviä.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja jokaisen tärkeän virheen seuraukset. Perusta toistettavissa oleva perusmalli ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavallisia tapauksia, reunatilanteita, virheellisiä tai puuttuvia syötteitä, jakauman siirtymiä, riippuvuuskatkoja, väärinkäyttöä sekä ryhmiä tai ympäristöjä, joilla on suurin riski jäädä vajaaksi. Mittaa tehtävän laatua yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja raja‑arvo, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen lanseerausta määritä vastuuhenkilöt julkaisulle, poikkeuksille, muutoksille, palautukselle ja poistamiselle. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tahallisesti injektoiduilla virheillä. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeetonta arkaluontoista dataa. Määritä hälytysrajat ja vastaavan omistaja, ja tarkastele todellisia todisteita käyttöönoton jälkeen sen sijaan, että oletettaisiin offline‑suorituskyvyn jatkuvan. Arvioi uudelleen aina kun tietolähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Onko KNN:llä koulutusvaihe?
Sillä on vähän parametrien sovittamista, mutta sillä on silti kehitysprosessi: esikäsittely opitaan koulutusdatasta, indeksi voidaan rakentaa, ja k, metriikka, painot ja piirteet valitaan validoinnin avulla.
Onko KNN sama kuin K-means?
Ei. KNN on ensisijaisesti valvottu paikallinen ennustemenetelmä. K-means on valvomaton klusterointialgoritmi, jossa K on klusterikeskusten määrä.
Ensisijaiset lähteet












