AI:n perusteet
Mikä on Bayesin teoreema?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Bayesin teoreema kuvaa, miten hypoteesin todennäköisyyttä päivitetään havaittujen todisteiden perusteella. Se yhdistää todennäköisyyden, että todiste on olemassa hypoteesin ollessa totta, sekä todennäköisyyden, että hypoteesi on totta kyseisen todisteen perusteella.
Tämä ero on keskeinen tilastollisessa päättelyssä ja koneoppimisessa. Testi voi olla erittäin tarkka, kun tila on läsnä, mutta positiivinen tulos voi silti osoittaa vain kohtuullisen todennäköisyyden tilan olemassaololle, jos tila on harvinainen.
Keskeiset havainnot
- Jälkijakauma yhdistää ennakkotiedon havaittujen todisteiden todennäköisyyteen.
- Todisteiden termi normalisoi mahdolliset hypoteesit.
- Peruslukemat voivat hallita näennäisesti vahvaa todistetta.
- Naive Bayes olettaa, että piirteet ovat ehdollisesti riippumattomia luokan suhteen, eivät että ne olisivat riippumattomia kaikissa olosuhteissa.
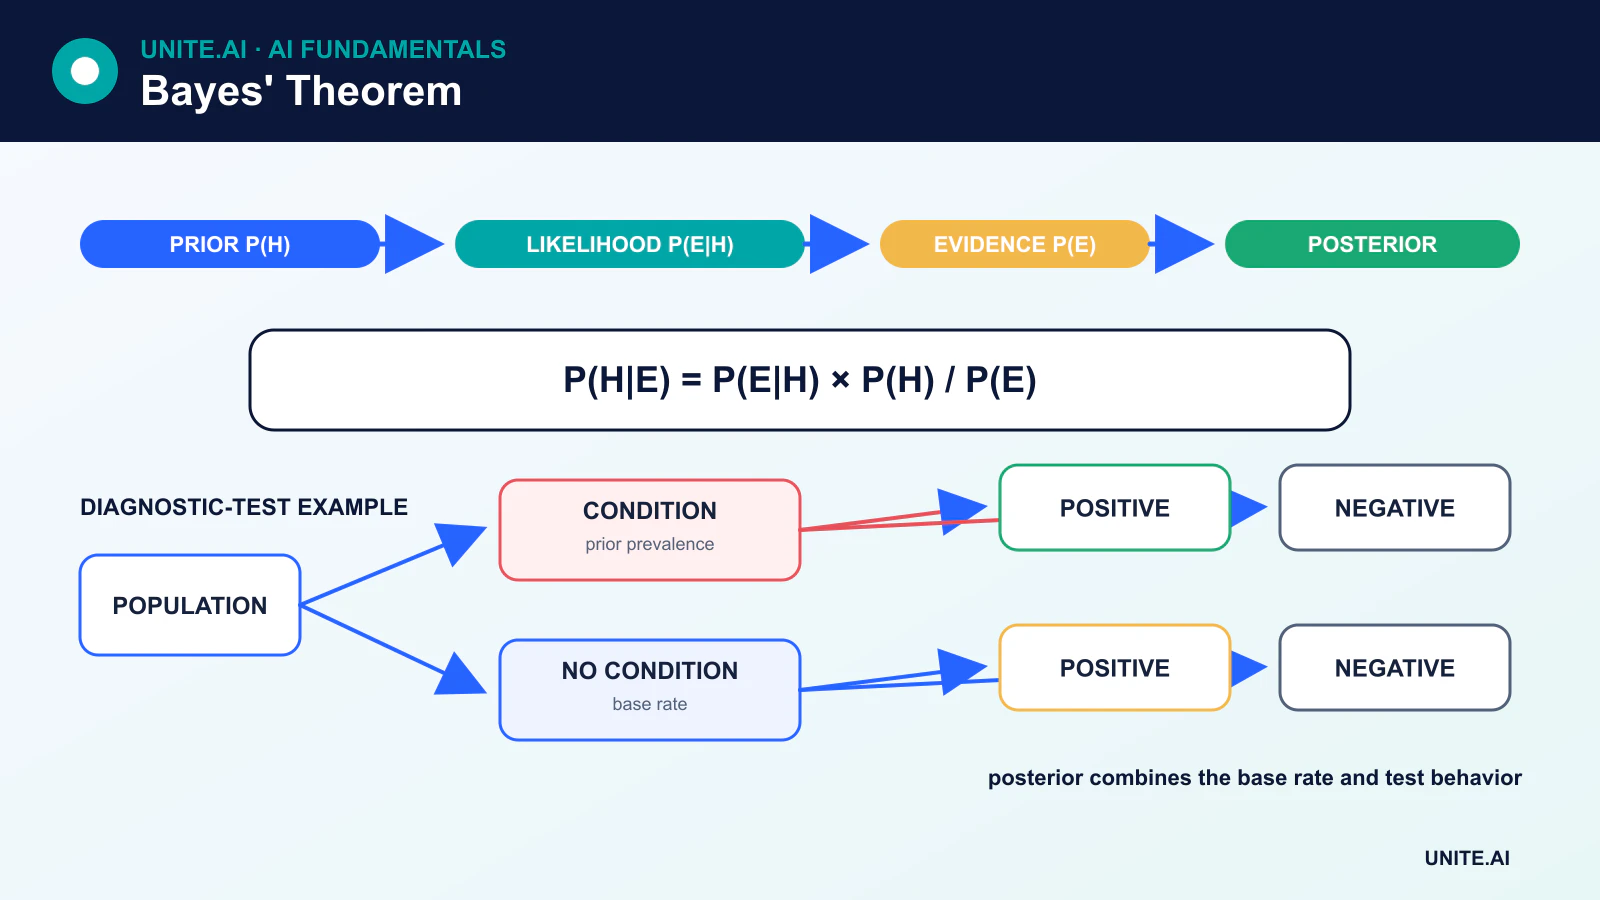
Kaava
P(A|B) = P(B|A)P(A) / P(B)
- P(A) on hypoteesi A:n ennakkotodennäköisyys.
- P(B|A) on todennäköisyys havaita todiste B, jos A on totta.
- P(B) on todisteen kokonaistodennäköisyys.
- P(A|B) on hypoteesi A:n jälkijakauma B:n havainnon jälkeen.
Teoreema seuraa kahdesta yhtäpitävästä lausekkeesta yhteistodennäköisyydelle: P(A ∩ B) = P(B|A)P(A) ja P(A ∩ B) = P(A|B)P(B).
Numerinen peruslukuesimerkki
Oletetaan, että tila vaikuttaa 1 %:iin väestöstä. Testillä on 90 % herkkyys ja 5 % väärä positiivinen osuus. Tarkastellaan 1 000 henkilöä:
- Noin 10:lla on tila; testi havaitsee 9 oikein.
- Noin 990:lla ei ole tilaa; 5 % väärä positiivinen osuus antaa noin 50 väärää positiivista.
- Saadaan siis noin 59 positiivista tulosta, joista 9 on todellisia positiivisia.
Tilan todennäköisyys positiivisen tuloksen jälkeen on noin 9 / 59 ≈ 15 %, ei 90 %. Testin herkkyys vastaa P(positiivinen | tila); käyttäjä yleensä haluaa P(tila | positiivinen). Bayesin teoreema yhdistää ne peruslukeman avulla.
Bayesin päivitys
Kun uusia todisteita saapuu, jälkijakauma voi toimia ennakkotodennäköisyytenä seuraavaa päivitystä varten. Täydellinen Bayesin malli määrittelee mahdolliset hypoteesit, ennakkotodennäköisyydet, todennäköisyysfunktion ja päätettävän suureen. Epävarmuus esitetään jälkijakaumana eikä pelkkänä pistearviona.
Ennakkotieto tulisi dokumentoida ja testata herkkyyden suhteen. Heikosti informoitu ennakkotieto voi regularisoida epärealistisia arvoja, kun taas huonosti valittu vahva ennakkotieto voi hallita rajallista dataa.
Naive Bayes -luokittelijat
Naive Bayes ennustaa luokan y piirteistä x₁ … xₙ käyttäen Bayesin teoreemaa ja oletusta:
P(x₁, …, xₙ | y) = Π P(xᵢ | y)
Piirteet oletetaan ehdollisesti riippumattomiksi, kun luokka on tiedossa. Tämä on usein epärealistista, mutta luokittelija voi silti toimia hyvin, kun luokkakohtaiset pisteet ovat käyttökelpoisia.
Yleisiä variantteja
- Multinomial Naive Bayes mallintaa laskumaisia piirteitä ja on yleinen asiakirjojen luokittelussa.
- Bernoulli Naive Bayes mallintaa binääristä piirteen läsnäoloa.
- Gaussian Naive Bayes mallintaa jokaisen jatkuvan piirteen luokasta riippuvaa Gaussin jakaumaa.
- Categorical Naive Bayes mallintaa diskreettejä kategorioita.
Tasoitus ja numeerinen vakaus
Jos piirteen arvo ei koskaan esiinny luokan kanssa harjoittelussa, tasoittamaton todennäköisyysestimaatti voi muuttua nollaksi ja poistaa koko tulon. Additiivinen tai Laplace-tyylinen tasoitus estää tämän. Toteutukset laskevat logaritmitodennäköisyydet, jolloin monien pienten arvojen kertominen muuttuu vakavien logaritmien yhteenlaskuksi.
Todennäköisyydet, pisteet ja kalibrointi
Naive Bayes -todennäköisyyslaskelmat voivat olla huonosti kalibroituja, koska korreloituneet piirteet lasketaan käytännössä useammin kuin kerran. Luokittelija saattaa järjestää luokat hyvin, mutta yliarvioida luottamuksen. Kalibrointi tulisi arvioida erillisellä testidatalla, kun todennäköisyyksiä käytetään päätöksenteossa.
Bayes Naive Bayesia laajemminkin
Bayesin inferenssi tukee hierarkkisia malleja, A/B-testejä, tieteellistä parametrien arviointia, ennustamista, epävarmuuteen perustuvaa päätöksentekoa ja probabilistisia graafisia malleja. Lähestymistavat kuten Markovin ketju Monte Carlo (MCMC) ja variatiivinen inferenssi otetaan käyttöön, kun jälkijakaumaa ei voida laskea suljetussa muodossa.
Yleisiä päättelyvirheitä
- Erottaa
P(A|B)jaP(B|A)toisistaan. - Ohittaa harvinaisen tai yleisen peruslukeman.
- Käsittelee ennakkotietoa objektiivisena tai jättää sen dokumentoimatta.
- Olettaa, että suuri todennäköisyysfunktion arvo automaattisesti merkitsee suurta jälkijakaumaa.
- Tulkitsee ennustavan yhteyden syy-yhteydeksi.
Ehdollinen todennäköisyys, kertoimet ja todisteet
Bayesin teoreema yhdistää hypoteesin jälkijakauman sen ennakkotodennäköisyyteen, todennäköisyysfunktion, jolla havaitaan todiste hypoteesin alla, sekä todisteen kokonaistodennäköisyyteen. Kertoimena esitettynä jälkijakauman kertoimet ovat ennakkokertoimet kerrottuna todennäköisyysfunktion kertoimella. Tämä erottaa sen, mitä ennen testiä uskottiin, siitä, kuinka voimakkaasti testi erottaa hypoteesit. Vaikka testi vaikuttaisi erittäin tarkalta, se voi silti tuottaa paljon vääriä positiivisia, jos tila on harvinainen, koska peruslukema vaikuttaa jälkijakaumaan.
Todennäköisyysfunktio on hypoteesin funktio kiinteän havaintodatan suhteen, eikä sitä tule sekoittaa hypoteesin todennäköisyyteen. Todisteiden normalisointi summaa tai integroi eri hypoteesien yli. Ehdollisen riippumattomuuden oletukset voivat yksinkertaistaa laskentaa, kuten naive Bayesissa, mutta ne on tarkistettava niiden seurauksista. Useita todisteita ei voida kertoa riippumattomina, jos ne jakavat syitä tai toistavat tietoa. Myös kausaalinen suunta on merkityksellinen: P(todiste|hypoteesi) ei yleensä ole P(hypoteesi|todiste), klassinen käänteistodennäköisyysvirhe.
Mallinnusvalinnat, laskenta ja päätöksenteon käyttö
Bayesin analyysi määrittelee ennakkotiedon, todennäköisyysfunktion ja jälkijakauman ennusteen. Ennakkotieto voi koodata vakiintunutta tietoa, regularisoida pieniä otoksia tai olla heikosti informoitu; sen tulee olla perusteltu ja testattu herkkyysanalyysin avulla. Konjugoidut mallit antavat analyyttiset päivitykset, kun taas Markovin ketju Monte Carlo, variatiivinen inferenssi ja sekvenssimenetelmät approksimoivat monimutkaisia jälkijakaumia. Diagnosoi konvergenssi, tehokas otoskoko, approksimaatiovirhe ja ennakkotiedon plausibiliteetti sen sijaan, että raportoidaan pelkkä jälkijakauman luku ilman laskentatarkistuksia.
Jälkijakauma informoi, mutta ei itsessään valitse toimintaa. Päätökset vaativat tappioita, hyötyjä, rajoitteita ja vaihtoehtoja. Arvioi probabilistiset mallit kalibroinnin, oikeiden pistemittareiden ja jälkijakauman ennusteen tarkistuksilla uudessa datassa. Päivitä vain todisteilla, jotka on kerätty mallinnetussa prosessissa; valikoiva otanta ja datasetin siirtymä voivat tehdä todennäköisyysfunktion virheelliseksi. Viesti luottamusväliä ja oletuksia ilman, että ne esitetään taattuna frekvenssialueena. Bayesin teoreema on tarkka todennäköisyyslaskenta, kun taas Bayesin johtopäätöksen laatu riippuu mallista ja annetuista todisteista.
Työstetty esimerkki: diagnostisen testin tulkinta
Testillä on 95 % herkkyys ja 90 % spesifisyys, mutta tila vaikuttaa vain 1 %:iin seulotusta populaatiosta. 10 000 henkilölle odotetaan noin 95 todellista positiivista ja 990 väärää positiivista, jolloin positiivisen ennusteen arvo on alle 9 %. Bayesin teoreema tekee peruslukema‑vaikutuksen selväksi. Laskenta esittää väestön, testirajan ja epävarmuuden sen sijaan, että markkinoitaisiin herkkyyttä positiivisen tuloksen oikeellisuuden mittarina. Tämä ero on myös perustavanlaatuinen huolellisessa tietojenkäsittelytieteessä.
Lääkärit päivittävät todennäköisyyttä lisätodisteiden avulla vain, kun testien välinen riippuvuus on mallinnettu. Päätöskynnys ottaa huomioon sairauden hylkäämisen vahingon, vahvistavatestien riskin, kustannukset ja potilaan mieltymykset. Kalibrointi tarkistetaan paikallisessa populaatiossa, ja prevalenssin muutokset käynnistävät tarkistuksen. Jälkijakauma tukee keskustelua ja seuraavia askeleita; se ei korvaa vahvistavaa diagnoosia. Raportointi käyttää luonnollisia frekvenssejä ja herkkyysanalyysiä, jotta potilaat ja ammattilaiset näkevät, miten johtopäätös muuttuu kohtuullisilla oletuksilla.
Toteutuksen todisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määrittele kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja kunkin tärkeän vian seuraukset. Perusta toistettavissa oleva peruslinja ja versionhallittu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunat, virheelliset tai puuttuvat syötteet, jakautuman siirtymä, riippuvuuksien katkeaminen, väärinkäyttö sekä ryhmät tai ympäristöt, jotka todennäköisesti jäävät alipalveltaviksi. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, tietosuojan ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnys, jotta riippumaton tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen käyttöönottoa nimeä vastuuhenkilö julkaisuun, poikkeuksiin, muutoksiin, palautuksiin ja poistamiseen. Käytä vaiheistettua käyttöönottoa, säilytä turvallinen varmistus ja varmista valvonta tarkoituksellisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai säännön versio, riippuvuuksien tila, ihmisen ohitukset ja vahvistetut tulokset ilman tarpeettomien arkaluontoisten tietojen keräämistä. Määrittele hälytysrajat ja vastaavan omistajan, tarkastele sitten todellista näyttöä käyttöönoton jälkeen sen sijaan, että oletetaan offline‑suorituksen jatkuvan. Arvioi uudelleen aina, kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidetty järjestelmä tarvitsee myös dokumentoidun palautumisen, tapausten oppimisen, poistamisen ja säilyttämisen menettelytavat sekä selkeän pisteen, jossa se tulee poistaa tai korvata.
Usein kysytyt kysymykset
Mikä on ero todennäköisyysfunktion ja todennäköisyyden välillä?
Kun parametrit on kiinnitetty, malli antaa todennäköisyyden mahdolliselle datalle. Kun havaittu data on kiinnitetty, sama lauseke voidaan nähdä todennäköisyysfunktiona mahdollisten parametrien arvojen suhteen. Numerinen kaava voi olla sama, mutta tulkinta eroaa.
Onko Naive Bayes täysimittainen Bayesin inferenssi?
Se käyttää Bayesin teoreemaa luokitteluun vahvan ehdollisen riippumattomuusmallin alla. Laajempi Bayesin inferenssi asettaa jakaumat tuntemattomille määrille ja päätyy päättelyyn jälkijakauman avulla.
Keskeiset lähteet