
AI:n perusteet
Mitä on sentimenttianalyysi? Menetelmät, käyttötarkoitukset ja rajoitukset

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Sentimenttianalyysi arvioi arvioivaa kieltä tekstissä, puhetranskripteissä tai muussa sisällössä. Järjestelmä voi luokitella polariteetin, kuten positiivisen, negatiivisen tai neutraalin; havaita aspektitasoisia mielipiteitä; arvioida intensiteettiä; tai tunnistaa kantaa tiettyä väitettä kohtaan.
Kohde on määritettävä huolellisesti. Sentimentti ei ole sama kuin tunne, aikomus, toksisuus, tyytyväisyys tai totuus. Positiivinen lause voi kuvailla vahingollista tapahtumaa sarkastisesti, kun taas negatiivinen tuotearvio voi silti suositella tuotetta kokonaisuudessaan.
Keskeiset havainnot
- Määritä yksikkö, kohde, luokat ja konteksti ennen esimerkkien keräämistä.
- Sanastot ovat läpinäkyviä perusmalleja; valvotut ja transformer-mallit voivat sisällyttää enemmän kontekstia, mutta ne tarvitsevat edustavaa dataa.
- Negaatio, sarkasmi, toimialakohtainen sanasto, monikielinen teksti ja aspektirajat ovat edelleen haastavia.
- Arvioi luokittain, alaryhmittäin, toimialoittain ja aikajaksoittain; sisällytä ihmisen tarkastus merkittäviin käyttötarkoituksiin.
Tasot ja kohteet
Dokumenttitason analyysi tuottaa yhden luokan koko kohteelle. Lauseen tasoinen analyysi erottaa väitteet, kun taas aspektipohjainen analyysi yhdistää sentimentin entiteettiin tai ominaisuuteen – esimerkiksi positiivinen kuvanlaadusta, mutta negatiivinen akun kestosta.
Kanta kysyy, tukeeko puhuja tiettyä väitettä, mikä voi poiketa tunneilmauksesta. Nämä erot tulee määritellä annotointiohjeessa ennen tekstiluokittelu-menetelmien käyttöönottoa.
Sanastot, perinteiset mallit ja transformer-mallit
Sanasto antaa sanoille pisteitä ja yhdistää ne sääntöihin negatiivisuuden tai intensiteetin osalta. Se on tulkittavissa ja edullinen, mutta kamppailee kontekstin kanssa. Perinteiset valvotut mallit käyttävät sana- tai n-grammi-ominaisuuksia, kun taas transformerit oppivat kontekstuaalisia esityksiä ja niitä voidaan hienosäätää.
Vähäiskertainen kehotus voi olla kätevää, mutta tulokset riippuvat esimerkeistä ja sanavalinnoista. Vertaa jokaista monimutkaista lähestymistapaa perusmalliin ja käytä vähäiskertaista oppimista vain erillisellä, versionoidulla arviointidatalla.
Data- ja kielihaasteet
Luokat voivat heijastaa annotaattorin näkökulmaa eikä objektiivista faktaa. Toimialan siirtymä on voimakas: ‘ennustamaton’ voi olla kehu elokuvalle ja kritiikki ajoneuvolle. Koodinvaihto, murre, emoji-merkinnät, lainattu puhe ja ironia monimutkaistavat token-tason signaaleja.
Tasapainota luokkia tarkoituksellisesti ja estä samankaltaisten tekijöiden, tuotteiden tai keskustelujen vuotaminen koulutus- ja testijoukkojen välillä. Malli, joka muistaa brändin tai puhujan, voi vaikuttaa tarkalta oppimatta sentimenttiä.
Arviointi ja vastuullinen käyttö
Raportoi tarkkuus, palautus, F1 ja sekaannusmatriisi pelkän tarkkuuden sijaan. Tarkastele virheitä aspektin, pituuden, murteen ja ajan mukaan, ja kalibroi kynnysarvot kunkin virheen operatiivisen kustannuksen perusteella.
Kokonaistrendit voivat tukea tutkimusta tai priorisointia, mutta yksilön tilan päätteleminen tai työllisyys-, luotto-, terveys- tai poliisipäätösten tekeminen lisää riskiä. Tarjoa epävarmuus, lähdekonteksti, tietosuojakontrollit ja ihmisen tarkastus.
Annotointi ja aineistojen rakentaminen
Laadi annotointiohje, jossa määritellään kohdeentiteetti, analyysiyksikkö, luokkien määritelmät, sekoitettujen ja neutraalien käsittely, lainauskäytännöt, sarkasmapolitiikka ja toimialakohtaiset esimerkit. Pilotoi useiden annotaattorien kanssa, laske yhteensopivuus, keskustele erimielisyyksistä ja tarkenna tehtävää ennen luokkien skaalaamista.
Näytteenotto määrää, mitä malli oppii. Someettinen sosiaalisen median virta voi ylikirjoittaa erittäin aktiiviset tilit; tukipyynnöt voivat jättää tyytyväiset asiakkaat pois; tähtiarviot eivät välttämättä vastaa arvostelutekstiä. Säilytä lähde- ja aikametatiedot, kunnioita alustan ehtoja ja yksityisyyttä, ja luo testijoukko väestöstä, jossa päätökset tehdään.
Luokkavuoto voi tapahtua arvostelujen, keräysjärjestelmän lisäämien emoji-merkintöjen, mallipohjaisten allekirjoitusten tai sentimenttiin korreloivien tuotemerkkien kautta. Poista lähes identtiset julkaisut ja ryhmittele keskustelut tai tekijät niin, etteivät niiden kieli ilmene molemmilla puolella jakoa.
Mallinnusvalinnat ja kalibrointi
Sanastojärjestelmät summaavat sanapisteet ja säätävät ne negatiivisuuden, intensiivisien sanojen, välimerkkien tai emojien perusteella. Ne tarjoavat hyödyllisen tarkistuksen ja voidaan mukauttaa toimialatermeillä. Lineaariset mallit, joissa on TF–IDF-ominaisuuksia, pysyvät kilpailukykyisinä joillakin aineistoilla ja paljastavat vaikuttavat n-grammit.
Kontekstuaaliset enkooderit esittävät sanat ympäröivän tekstin mukaan ja niitä voidaan hienosäätää polariteetin tai aspektien osalta. Pitkät dokumentit saattavat tarvita hierarkkisia malleja, lauseiden aggregointia tai relevanttien segmenttien hakua. Monikieliset lähestymistavat voivat kouluttaa yhden yhteisen mallin, kääntää välikielelle tai ylläpitää paikallisia malleja; jokaisella on kattavuus- ja kulttuuriset kompromissit.
Todennäköisyyden kalibrointi on tärkeää, kun pisteet käynnistävät toimintoja. Luotettavuuskaaviot ja odotettu kalibrointivirhe paljastavat, vastaako ilmoitettu 0,8:n luottamus noin 80 prosentin oikeellisuutta. Kynnysarvot voivat luoda abstinenssivyöhykkeen ihmisen tarkastusta varten, ja erilliset kynnysarvot voivat olla perusteltuja, kun virhekustannukset eroavat – ei piilottaakseen epätasaista laatua.
Sovellukset ja yleiset väärinkäsitykset
Kokonais sentimentti voi auttaa priorisoimaan teemoja, vertailemaan kampanjareaktioita tai ohjaamaan kiireellisiä palveluviestejä. Aspektianalyysi on usein toimivampi kuin yleinen polariteetti, koska se tunnistaa, mistä ihmiset puhuvat.
Älä yhtälöi negatiivisten julkaisujen yleisyyttä väestön mielipiteeseen. Julkaisemiskäyttäytyminen, botit, moderointi, alustan demografia, kampanjat ja keräyskyselyt muokkaavat otosta.
Yksilöllisissä päätöksissä virheelliset luokitukset voivat olla leimaavia ja vaikeita kiistää. Vältä sentimentin käyttöä työntekijöiden sitoutumisen, mielenterveyden, luottokelpoisuuden, aikomuksen tai petoksen indikaattorina. Kun ihmiset vaikuttavat, näytä lähdekonteksti, salli korjaus ja vaadi ihmispäätöksentekijä, jolla on todellinen harkintavalta.
Käytännön esimerkki: sentimenttianalyysi asiakaspalautteessa
Yrityksen, joka analysoi tukikommentteja, tulisi määrittää, tarvitseeko se dokumenttisentimenttiä, aspektisentimenttiä, tunteita, kiireellisyyttä tai ongelmaluokittelua. ‘Toimitus oli nopea, mutta tuote rikkoutui’ ei voida esittää uskollisesti yhdellä positiivis- tai negatiivisella luokalla. Laadi annotointiohje kohteille, negatiivisuudelle, sarkasmille, sekoitetuille väitteille, lainatulle puheelle ja tuntemattomille tapauksille, ja mittaa yhteensopivuus ennen luokkien käsittelemistä totuutena.
Vertaa sanastopohjaista tai lineaarista perusmallia hienosäädettyyn enkooderiin tai kehotettuun kielimalliin. Jaa data aikavälin tai asiakkaan mukaan estääksesi lähes identtisen vuodon, ja säilytä luokkien esiintyvyys. Raportoi tarkkuus, palautus, F1, kalibrointi ja sekaannus kielen, kanavan, tuotteen ja demografisten indikaattorien mukaan vain, jos se on laillista ja perusteltua. Tarkastele korkean luottamuksen virheitä, koska ne ovat vaarallisempia automatisoidussa reitityksessä kuin epävarmat tulokset, jotka eskaloidaan.
Käytä sentimenttiä yhtenä signaalina aggregoinnissa tai priorisoinnissa, ei epäilemättömänä mittarina henkilön tilasta. Seuraa sanaston ja tuotteiden muutoksia, uudelleenkouluta tarkastetuilla esimerkeillä ja salli agenteille luokkien korjaus. Älä koskaan päättele suojattuja piirteitä tai rangaise työntekijöitä vahvistamattomista sentimenttipisteistä. Johtoryhmän raportoinnissa näytä otoskoko, epävarmuus, puuttuvat tiedot ja muutostekijät, jotta vaihtuva piste johtaa tutkimukseen eikä yksinkertaiseen johtopäätökseen.
Monikielinen käyttöönotto ei saa olettaa, että syötteiden kääntäminen säilyttää sävyn, negatiivisuuden, idiomit tai kulttuuriset konventiot. Vahvista jokainen tuettu kieli ja monikielinen malli natiivikatselijoilla, ja tarjoa tuntematon tulos, kun todisteet ovat heikot. Toimialan sopeutuminen on myös tärkeää: sanat, jotka kuulostavat negatiivisilta tavallisessa keskustelussa, voivat olla neutraaleja teknisiä kuvauksia. Säilytä erilliset kynnysarvot tai mallit vain, kun operatiivinen näyttö oikeuttaa lisäkompleksisuuden ja hallintovaateet.
Käytännön toteutustarkistuslista
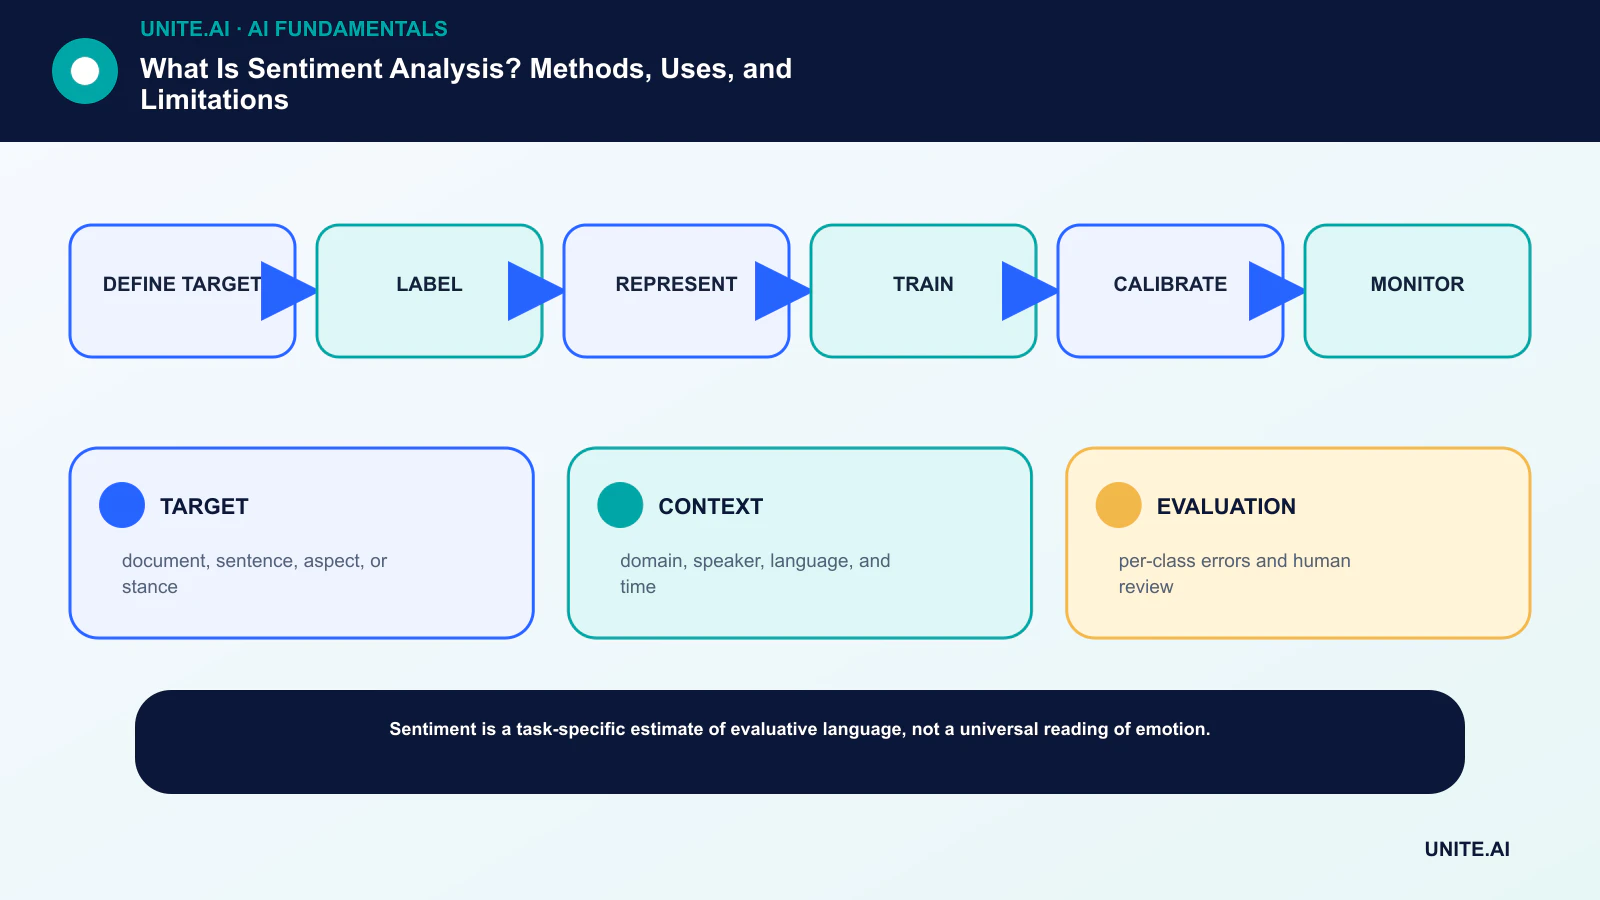
Muunna käsite rajoitetuksi, testattavaksi työnkuluksi: määritä kohde → luokka → esitys → koulutus → kalibrointi → seuranta. Nimeä vastuullinen omistaja, dokumentoi data ja riippuvuudet, perusta yksinkertainen perusmalli, aseta hyväksymis- ja pysäytyskriteerit, testaa edustavat epäonnistumiset ja määritä seuranta, palautus ja tarkastus ennen laajuuden laajentamista. Tallenna versiot ja oletukset, jotta toinen tiimi voi toistaa tuloksen ja ymmärtää, mitä on muuttunut.
Ennen käyttöönottoa suorita dokumentoitu valmiustarkastus niiden ihmisten kanssa, jotka rakentavat, ylläpitävät, turvaavat ja joihin järjestelmä vaikuttaa. Testaa normaaleja tapauksia, reunaehtoja, riippuvuuksien epäonnistumisia ja väärinkäyttöä; säilytä todisteet ja ratkaisemattomat riskit. Määritä, kuka voi hyväksyä julkaisun, muuttaa kynnysarvoa, ohittaa tuloksen tai pysäyttää toiminnan. Tarkastele päätöstä uudelleen, kun todelliset tiedot saapuvat, sillä teknisesti onnistunut pilotti ei takaa luotettavaa suorituskykyä laajemmassa mittakaavassa.
- KOHDE: dokumentti, lause, aspekti tai kanta.
- KONTEKSTI: toimiala, puhuja, kieli ja aika.
- ARVIOINTI: luokkakohtaiset virheet ja ihmisen tarkastus.
Usein kysytyt kysymykset
Onko sentimenttianalyysi objektiivinen?
Ei. Se arvioi tehtävän ja annotointiprosessin määrittelemiä luokkia. Jotkut tekstit ovat todellakin moniselitteisiä, sekoitettuja, kontekstisidonnaisia tai lukijoiden tulkitsemia eri tavoin.
Voiko sentimenttianalyysi havaita sarkasmia?
Mallit voivat oppia joitakin kuvioita, mutta sarkasmi riippuu usein puhujan historiasta, jaetusta tiedosta ja kontekstista, joka on tekstin ulkopuolella. Se on edelleen yleinen epäonnistumismalli.
Ensisijaiset viitteet












