
AI:n perusteet
Miten tekstiluokittelu toimii?

 Lisää Unite.AI suosikkilähteisiisi Google-palvelussa
Tekstiluokittelu antaa yhden tai useamman tunnisteen asiakirjalle, viestille tai tekstiosuudelle. Esimerkkejä ovat roskapostin havaitseminen, tarkoituksen ohjaus, tunteiden analyysi, aiheiden merkkaus, moderointi ja tukipyyntöjen priorisointi.
Tuotantoluokitin on enemmän kuin malli. Se riippuu tarkasta tunnisteluokittelusta, edustavista annotaatioista, vuotoa estävistä jaoista, kalibroidusta päätössääntöstä sekä kielten ja luokkien esiintymistiheyden muutosten seurantajärjestelmästä.
Keskeiset havainnot
- Määritä tunnisteet ja epäselvät tapaukset ennen arkkitehtuurin valintaa.
- Yksinkertaiset bag-of-words-perustasot ovat edelleen arvokkaita; esikoulutetut enkooderit lisäävät kontekstia ja siirtooppimista.
- Tarkkuus voi piilottaa heikon vähemmistöluokan suorituskyvyn, joten käytä luokkaan liittyviä mittareita ja virheanalyysiä.
- Todennäköisyyden kalibrointi, abstinenssi ja ihmisen tarkastus muuttavat pisteet turvallisemmiksi päätöksiksi.
Määritä taksonomia ja annotointipolitiikka
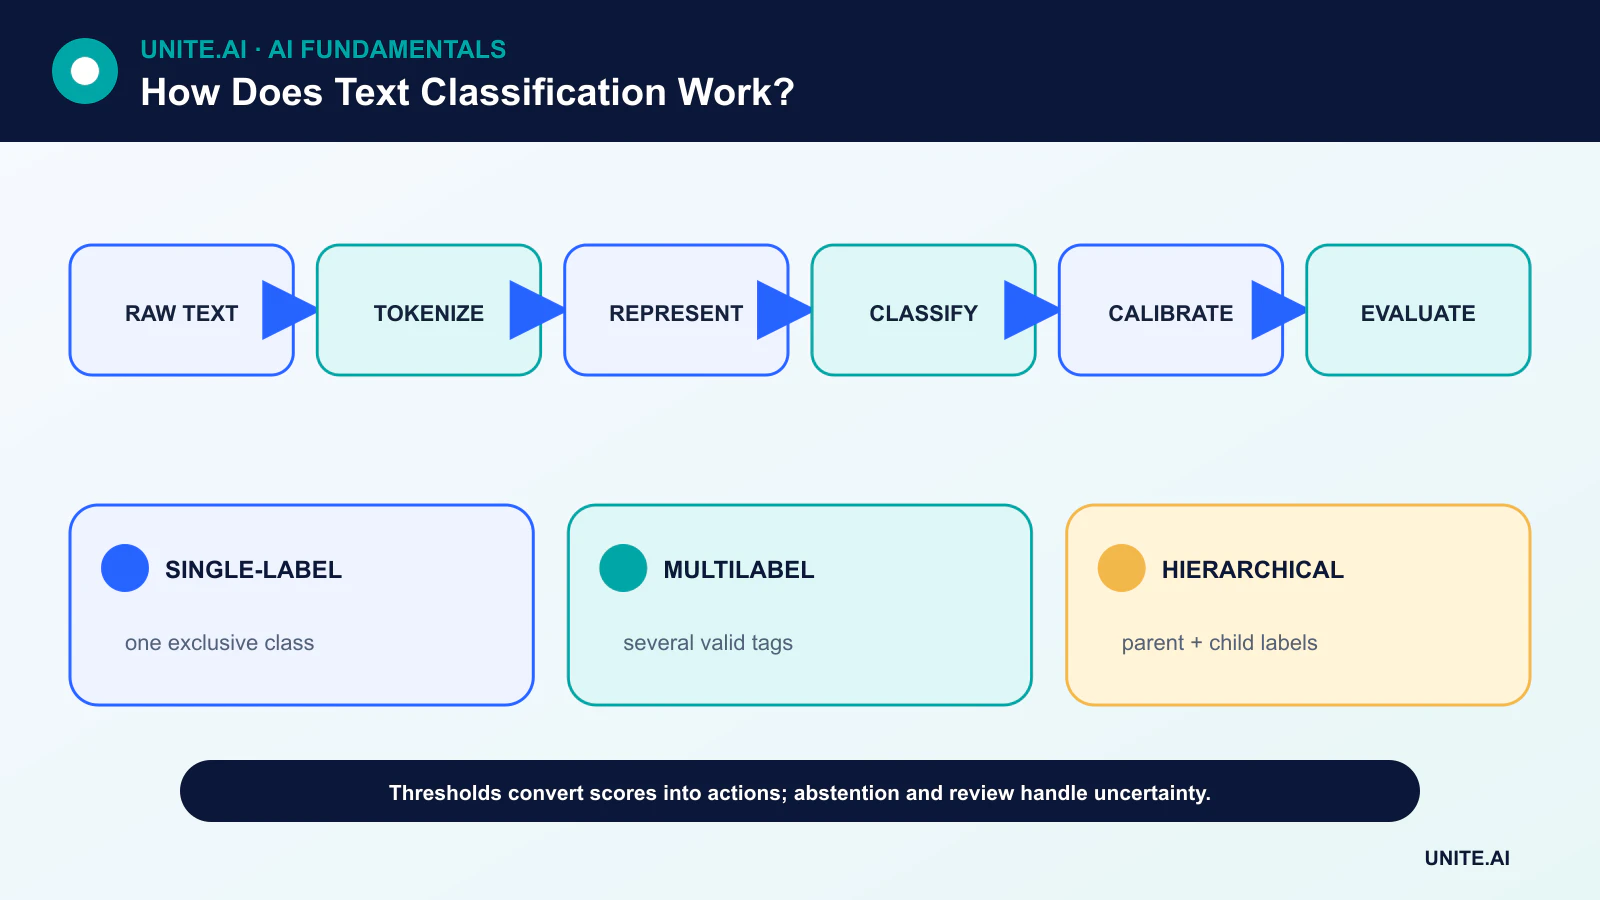
Yhden tunnisteen tehtävä valitsee yhden toisensa poissulkevan luokan. Monitunnisteinen tehtävä voi antaa useita itsenäisiä tunnisteita. Hierarkkiset taksonomiat sisältävät ylä- ja alaluokkia. Nämä ovat erilaisia oppimisongelmia ja vaativat erilaisia tulosteita ja mittareita.
Annotaattorit tarvitsevat määritelmät, positiiviset ja negatiiviset esimerkit, säännöt puuttuvan kontekstin varalta sekä eskalointipolun. Yhdenmukaisuustilastot voivat paljastaa epäselvän tehtävän, mutta erimielisyys voi myös edustaa todellista epäselvyyttä, jonka järjestelmän tulisi säilyttää.
Tekstin esittäminen
Perinteiset putkistot käyttävät token-määriä, n-grammeja ja TF-IDF:ta lineaaristen luokittimien tai tukivektorikoneet kanssa. Ne kouluttavat nopeasti, paljastavat vaikuttavat termit ja tarjoavat vahvan perusmallin.
Neuraaliset järjestelmät kartoittavat tokenit upotuksiin. Esikoulutetut transformer-enkooderit käyttävät huomiointia tuottaakseen kontekstuaalisia esityksiä, ja niitä voidaan hienosäätää merkittyjen esimerkkien avulla. Kehote- tai nollakertaluokittimet voivat vähentää alkuperäistä merkintää, mutta niiden tunnisteiden sanamuoto, malliversio ja kalibrointi on arvioitava todellisessa toimialassa.
Koulutus ilman vuotoa
Aineisto jaetaan koulutus-, validointi- ja lopulliseen testidataan. Lähesidenttiset asiakirjat, viestit samasta keskustelusta tai samasta lähteestä peräisin olevat mallipohjat tulisi pitää samassa jaossa. Aikariippuvaassa käytössä kronologinen jako kuvaa käyttöönottoa paremmin.
Luokkien epätasapainoa voidaan käsitellä painotuksen, uudelleennäytteenoton, kynnysvalinnan tai lisädatan avulla. Synteettisiä esimerkkejä ei tule korvata todellisten vähemmistöluokan virheiden tarkastelulla, ja ne voivat tuoda artefakteja, jotka malli oppii liian helposti.
Mittarit ja kalibroidut päätökset
Sekamatriisi näyttää, mitkä tunnisteet sekoittuvat. Tarkkuus mittaa, kuinka monta ennustettua positiivista on oikea; palautus mittaa, kuinka monta todellista positiivista löydetään. Makrokeskiarvot painottavat luokkia tasaisesti, kun taas mikrokeskiarvot painottavat yksittäisiä esimerkkejä.
Raaka softmax-piste ei automaattisesti ole luotettava todennäköisyys. Kalibrointi vertaa luottamusta havaittuun oikeellisuuteen. Tiimit voivat asettaa luokkokohtaisia kynnysarvoja, pidättäytyä, kun luottamus on alhainen, ja ohjata herkät tapaukset tarkastajalle.
Käyttöönotto, monikielinen käyttö ja poikkeama
Teksti muuttuu tuotteiden, tapahtumien, slangin ja vastustavan käyttäytymisen myötä. Valvonnan tulisi seurata syötteen kieltä, pituutta, sanaston ulkopuolisia malleja, luokkien esiintymistiheyttä, luottamusta ja viivästyneitä tuloksia. Uudelleenkoulutus vaatii versioitua dataa ja regressiotestisarjan tärkeistä esimerkeistä.
Monikielinen suorituskyky on testattava jokaiselle kielelle ja dialektille. Kaiken kääntäminen yhteen kieleen voi muuttaa tunteita tai entiteettejä; monikielinen enkooderi saattaa silti toimia epätasaisesti, koska sen esikoulutus ja tunnisteet eivät ole tasapuolisesti edustavia.
Esitykset ja luokitinperheet
Tekstiluokittelu kartoittaa asiakirjan, lauseen tai tokenijonon yhteen tai useampaan tunnisteeseen. Määritä, ovatko tunnisteet toisensa poissulkevia, monitunnisteisia, hierarkkisia, järjestettyjä tai avoimia. Perinteiset putkistot tokenisoivat tekstin, rakentavat bag-of-words- tai TF–IDF-ominaisuudet ja kouluttavat logistista regressiota, naiivia Bayesia tai lineaarista SVM:ää. Neuraaliset järjestelmät oppivat upotuksia konvoluutiolla, rekurrenttiyksellä tai transformereilla. Kehotettuja kielimalleja voidaan käyttää luokitteluun ilman tehtäväkohtaista koulutusta, mutta lähtörajoitukset, kustannukset, poikkeama ja todisteet on edelleen arvioitava yksinkertaisempia perusmalleja vastaan.
Esikäsittely riippuu esityksestä. Pienikirjaimiksi muuntaminen tai välimerkkien poistaminen voi tuhota signaaleja nimille, tunteille, koodille tai kielelle; juurrutus voi yhdistää erilaisia merkityksiä. Transformer-tokenisoijat toimivat alisanoilla ja niillä on pituusrajoituksia, joten katkaisustrategia on tärkeä. Pitkät asiakirjat saattavat vaatia pilkkomista ja aggregointia. Säilytä raaka teksti ja muunnosversio, ja jaa aineisto kirjoittajan, keskustelun, lähteen tai ajan mukaan, jotta lähesamanlaiset asiakirjat ja toistuvat mallipohjat eivät leikkaa koulutus- ja testijoukkojen väliin.
Tunnisteet, mittarit ja virheanalyysi
Annotointiohjeessa tulisi määritellä laajuus, esimerkit, epäselvät tapaukset sekä tuntematon- tai pidättäytymisvaihtoehto. Mittaa yhdenmukaisuus ja ratkaise erimielisyydet sen sijaan, että piilotetaan ne enemmistöäänestyksellä. Epätasapainoisille luokille tarkkuus on riittämätön; raportoi tarkkuus, palautus, F1, sekamatriisi, kalibrointi ja kynnyskohtainen työkuorma luokittain. Monitunnisteiset tehtävät tarvitsevat mikro-, makro- ja tunnistekohtaiset mittarit. Arvioi kielet, dialektit, toimialat, viestin pituus ja aika. Satunnainen jako voi yliarvioida laatua, kun sanasto tai mallipohjat poikkeavat.
Virheanalyysin tulisi erottaa esityksen epäonnistuminen, riittämätön konteksti, tunnisteen epäselvyys, harvinainen sanasto, kieltosana, sarkasmi ja harhaanjohtavat vihjeet. Käytä kontrafaktisia testejä, jotka muuttavat nimiä, dialektimerkkejä tai merkityksettömiä metatietoja säilyttäen merkityksen. Tarkastele korkean luottamuksen virheitä ja hylättyjä tapauksia. Malli saattaa oppia, että asiakaskanava tai allekirjoitus ennustaa tunnisteen sen sijaan, että se tulkitsee sisällön. Poista vuoto ja tarkista data ennen kuin kasvatat pelkästään mallin kapasiteettia.
Tuotantosuunnittelu
Tarjoa kiinteä tokenisoija ja malli skeeman validoinnilla, pituusrajoituksilla, eräkäsittelyllä ja varajärjestelmällä tukemattomille kielille tai alhaiselle luottamukselle. Seuraa syötteen jakautumista, tunnisteiden määriä, kalibrointia, viivettä ja tarkastettuja tuloksia. Suojaa teksti, koska se voi sisältää henkilökohtaisia, luottamuksellisia tai vastustavia ohjeita. Automaattisessa moderoinnissa, kelpoisuudessa tai ohjauksessa tarjoa valitusmahdollisuus ja mittaa eroja aiheuttavia virheitä. Versioi tunnisteet ja kynnysarvot liiketoimintapolitiikan mukaisesti. Tekstiluokittelu on luotettava vain määritellyssä tunnistusjärjestelmässään ja datan jakautumisessa; sujuvat malliselitykset eivät todista, että luokitus on oikea.
Käytännön esimerkki: saapuvien tukipyyntöjen luokittelu
Tukitiimi määrittelee toisensa poissulkevat ohjaustunnisteet sekä kiireellisyys-, monikielisyys- ja tuntemattomuusliput. Annotaatioiden tekijät merkitsevät anonymisoituja viestejä ohjeiden mukaan monipuolisille ongelmille ja mittaavat yhdenmukaisuutta. TF–IDF-logistinen perusmalli, hienosäädetty enkooderi ja kehotettu malli käyttävät samaa aikapohjaista testijoukkoa. Arviointi raportoi luokan tarkkuuden ja palautuksen, kiireellisten väärien negatiivien, kalibroinnin, skeeman kelpoisuuden, viiveen ja kustannuksen, ja ryhmittelee lähesamanlaiset mallipohjat vuotojen välttämiseksi.
Käyttöönotettu luokitin tarkistaa kielen ja pituuden, pidättäytyy heikon evidenssin perusteella ja antaa agenttien korjata reititykset. Kehotteita ja viestejä pidetään epäluotettavina; työkalun käyttöoikeutta ei ole. Valvonta seuraa tunnisteiden yleisyyttä, luottamusta, korjauksia, vasteaikaa ja nousevia aiheita. Politiikka- tai tuoteuudistus päivittää taksonomiaa ja uudelleenkoulutusdataa tarkastelun kautta. Järjestelmä parantaa jonon sijoittelua, mutta se ei koskaan päättele asiakkaan tunteita tai oikeutuksia validoitujen tunnisteiden ulkopuolelta.
Toteutustodisteet ja operatiivinen valmius
Tuotantopäätös vaatii enemmän kuin onnistuneen demonstraation. Määritä kohdekäyttäjät, käyttöympäristö, syötteet, tulosteet, riippuvuudet, omistaja ja kunkin tärkeän vian seuraukset. Perusta toistettavissa oleva perusmalli ja versioitu arviointijoukko ennen hienosäätöä. Testaa tavalliset tapaukset, reunatilanteet, virheelliset tai puuttuvat syötteet, jakautumisen muutokset, riippuvuuksien katkokset, väärinkäytökset ja ryhmät tai ympäristöt, joille palvelu todennäköisesti puuttuu. Mittaa tehtävän laatu yhdessä kalibroinnin tai epävarmuuden, viiveen, läpimenoajan, resurssikustannusten, saavutettavuuden, yksityisyyden ja turvallisuuden kanssa. Tallenna jokainen muunnos ja kynnysarvo, jotta itsenäinen tarkastaja voi toistaa tuloksen ja erottaa todisteet houkuttelevasta prototyypistä.
Ennen julkaisua määritä vastuuhenkilöt julkaisuun, poikkeuksiin, muutoksiin, palautukseen ja elinkaaren päättämiseen. Käytä vaiheittaista käyttöönottoa, säilytä turvallinen varajärjestelmä ja varmista valvonta tahallisesti injektoiduilla vioilla. Operatiivisen telemetrian tulisi paljastaa syötteen laatu, tulosteen käyttäytyminen, mallin tai sääntön version, riippuvuuksien kunto, ihmisen ohitukset ja vahvistetut tulokset keräämättä tarpeettomia arkaluontoisia tietoja. Määritä hälytyskynnys ja vastaavan omistaja, tarkastele sitten todellisia todisteita käyttöönoton jälkeen sen sijaan, että olettaisit offline-suorituskyvyn jatkuvan. Arvioi uudelleen aina kun datalähteet, käyttäjät, mallit, toimittajat, politiikat, laitteisto tai tavoitteet muuttuvat. Ylläpidettävä järjestelmä tarvitsee myös dokumentoidut palautus-, tapausoppimis-, poistamis- ja säilytyskäytännöt sekä selkeän pisteen, jossa se tulee poistaa käytöstä tai korvata.
Usein kysytyt kysymykset
Onko tunteiden analyysi tekstiluokittelutehtävä?
Yleensä kyllä, mutta tunteet voivat olla monitunnisteisia, aspektipohjaisia tai jatkuvia sen sijaan, että ne olisivat yksi positiivinen/ neutraali/ negatiivinen tunniste.
Milloin tekstiluokittimen tulisi pidättäytyä?
Kun luottamus on alhainen, teksti on aihepiirin ulkopuolella, tarvittava konteksti puuttuu tai virheellisen automaattisen toiminnon kustannus ylittää tarkastuksen kustannuksen.
Ensisijaiset lähteet












