
Fundamentos de la IA
¿Qué es TinyML? Aprendizaje automático en microcontroladores

 Añade Unite.AI a tus fuentes preferidas en Google
TinyML lleva la inferencia de aprendizaje automático a dispositivos altamente restringidos, como microcontroladores, pequeños procesadores de señal digital y sensores de bajo consumo. Estos sistemas pueden contar con kilobytes o megabytes de memoria, presupuestos de energía estrictos, sin conexión continua a la red y con plazos en tiempo real.
El valor no reside simplemente en un modelo más pequeño. Procesar cerca del sensor puede reducir la latencia, el ancho de banda y la exposición de datos sin procesar, al tiempo que permite productos que funcionan durante largos períodos con baterías o energía cosechada.
Conclusiones clave
- TinyML se define por el presupuesto total de hardware y software, no por un umbral de tamaño de modelo.
- La cuantización, arquitecturas compactas, kernels optimizados y un cuidadoso almacenamiento intermedio hacen posible el despliegue.
- La inferencia en el dispositivo puede mejorar la privacidad, pero las actualizaciones seguras y la gobernanza de datos siguen siendo importantes.
- Evalúe la precisión junto con la latencia, la memoria máxima, la energía, el ciclo de trabajo y la robustez.
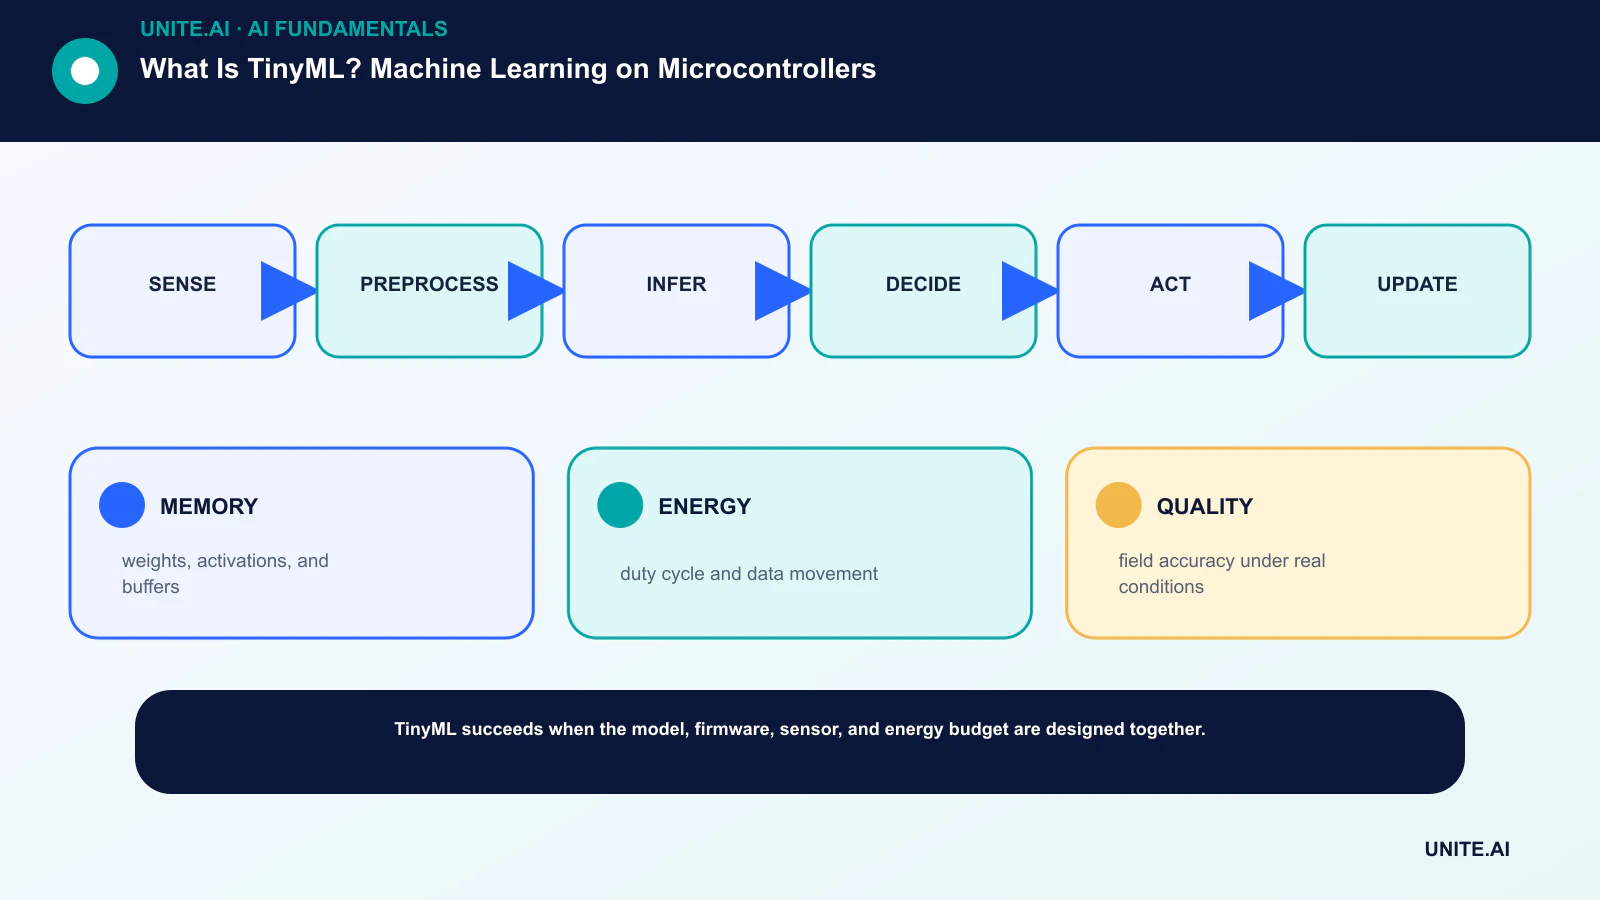
La pila TinyML
Un sensor captura audio, movimiento, vibración, imágenes u otra señal. El firmware lo preprocesa en características o tensores; un modelo compacto se ejecuta a través de un runtime incrustado; la lógica de la aplicación decide si despertar un sistema mayor o actuar localmente.
Esto es una forma restringida de IA de borde. El hardware puede incluir una MCU, memoria, interfaces de sensores y, a veces, un acelerador neuronal. Cada búfer, operador y copia compiten por recursos limitados.
Ajustar el modelo
La cuantización reemplaza los valores de alta precisión por representaciones enteras más pequeñas. La poda, destilación, ingeniería de características y la búsqueda de arquitectura pueden reducir el cómputo o el almacenamiento. El soporte de operadores en el runtime de destino limita qué modelos son prácticos.
El entrenamiento suele realizarse en hardware más grande, luego el modelo se convierte y compila para el dispositivo. El aprendizaje por transferencia puede reducir la necesidad de datos, pero el artefacto final debe evaluarse después de la conversión porque los cambios numéricos pueden alterar la precisión.
Datos y cambio ambiental
Las grabaciones de laboratorio rara vez representan cada micrófono, posición de montaje, temperatura, patrón de vibración, acento o condición de fondo. Recopile datos de dispositivos y entornos representativos, mantenga las fuentes de entrenamiento y prueba independientes, e incluya casos de “ninguna de las anteriores”.
Un disparo falso puede desperdiciar energía o molestar al usuario; una anomalía no detectada puede ser costosa. Seleccione umbrales basándose en los costos reales de error y supervise el rendimiento en campo mediante resúmenes que preserven la privacidad o diagnósticos muestreados, según corresponda.
Medir todo el dispositivo
El número de operaciones del modelo no equivale al rendimiento del producto. Informe la frecuencia de activación, el tiempo de preprocesamiento, la latencia de inferencia, la RAM máxima, el uso de flash, la potencia media y pico, el comportamiento térmico y el impacto en la batería bajo un ciclo de trabajo explícito.
Planifique actualizaciones firmadas de firmware y modelo, retrocesos, identidad del dispositivo y respuesta a vulnerabilidades. Los dispositivos diminutos pueden permanecer desplegados durante años, por lo que la mantenibilidad forma parte de la calidad del modelo. Los controles de ciberseguridad no pueden posponerse porque el dispositivo es pequeño.
Presupuesto de memoria y cómputo
La flash almacena firmware, pesos del modelo y constantes; la RAM contiene búferes de sensores, activaciones intermedias y el estado del runtime. La memoria máxima de activación puede superar el tamaño de los pesos, especialmente en las capas convolucionales iniciales. Los planificadores de memoria reutilizan búferes cuyas vidas no se solapan, mientras que las características en streaming evitan almacenar una ventana completa de la señal.
El recuento de operaciones es una estimación inicial, pero la eficiencia del kernel depende de la forma del tensor, la alineación, el soporte de instrucciones y el acceso a la memoria. Una convolución depthwise puede reducir la aritmética pero ejecutarse pobremente en hardware sin un kernel optimizado. Evalúe el modelo compilado en la placa objetivo, no solo en un perfilador de escritorio.
El ciclo de trabajo domina muchos productos. El sensor y la MCU pueden estar en modo sueño, despertarse por un disparo económico, ejecutar un modelo pequeño y activar una radio o un procesador mayor solo cuando sea necesario. Mida todo el ciclo de trabajo, incluyendo sensor, conversión, preprocesamiento, activación, inferencia, comunicación y fugas en reposo.
Desarrollo y conversión del modelo
Comience con las limitaciones de despliegue y recopile datos de sensores representativos. El preprocesamiento usado en el entrenamiento debe coincidir exactamente con la implementación de punto fijo o incrustada. Diferencias en la tasa de muestreo, ventana, conversión de color, normalización o extracción de características pueden hacer que un modelo falle incluso cuando la conversión tiene éxito.
La cuantización posterior al entrenamiento calibra rangos a partir de muestras representativas; el entrenamiento consciente de la cuantización simula menor precisión durante el aprendizaje. Las escalas de peso por canal a menudo preservan mejor la calidad convolucional que una única escala. Las operaciones no compatibles pueden reescribirse, aproximarse o trasladarse a un respaldo más lento, lo que requiere una nueva evaluación.
La compresión debe basarse en hipótesis. Podar pesos no estructurados puede no acelerar un kernel incrustado denso; la eliminación estructurada de canales es más fácil de explotar por el hardware. La destilación transfiere el comportamiento de un maestro más grande, pero también puede transferir sus sesgos y errores. Compare con procesamientos de señal y líneas base de umbrales.
Aplicaciones, pruebas de campo y mantenimiento
Las tareas comunes de TinyML incluyen detección de palabras clave, detección de palabra de activación, reconocimiento de gestos, detección de anomalías de vibración, ocupación, eventos acústicos y visión sencilla. El modelo puede actuar como una puerta en lugar de la decisión final, conservando ancho de banda mientras envía casos inciertos o importantes a un sistema más capaz.
Las pruebas de campo deben cubrir tolerancias del dispositivo, envejecimiento del sensor, montaje, estado de la batería, temperatura, clima, usuarios e interferencia de fondo. Registre disparos falsos por hora o eventos perdidos por ciclo operativo, no solo la precisión equilibrada de la prueba. Un umbral elegido en el laboratorio puede necesitar calibración específica del producto.
Planifique actualizaciones OTA firmadas, retrocesos, telemetría de versiones de modelo y períodos de soporte prolongados. Si las actualizaciones son imposibles, use modelos conservadores y documente la deriva ambiental esperada. La desactivación debe revocar credenciales del dispositivo y abordar los datos almacenados, no simplemente dejar de vender el producto.
Ejemplo práctico: un monitor de vibración TinyML
Un pequeño acelerómetro en un motor muestrea vibraciones bajo cargas normales y condiciones de falla conocidas. El dispositivo segmenta la señal, elimina el offset, calcula características compactas en dominio temporal o de frecuencia y ejecuta un detector de anomalías o clasificador. La tasa de muestreo debe capturar frecuencias relevantes de rodamientos y ejes sin sobrecargar la memoria o la energía. Las etiquetas deben provenir de inspecciones verificadas, no solo de una alarma que podría estar equivocada.
El entrenamiento se realiza en una estación de trabajo, seguido de cuantización, conversión y compilación para el microcontrolador objetivo. Mida el flash del modelo, la RAM máxima, el tiempo de ejecución, la energía y la precisión en el dispositivo físico. La aritmética entera y la disponibilidad de operadores pueden cambiar los resultados del modelo de entrenamiento. Pruebe la orientación del sensor, el montaje, la temperatura, el voltaje, la variación de componentes y la vibración de fondo real, no solo archivos de laboratorio curados.
El dispositivo desplegado necesita calibración, actualizaciones seguras de firmware, reporte de versiones, comportamiento a prueba de fallos y un plan para la deriva. Puede transmitir solo una puntuación de salud o características seleccionadas para ahorrar energía y proteger los datos sin procesar, pero las alarmas falsas locales aún generan costos de mantenimiento. Use un umbral escalonado, requiera persistencia y combine la evidencia del modelo con el estado operativo. TinyML es más valioso cuando la latencia local, la privacidad, la conectividad o las limitaciones energéticas justifican sus límites de ingeniería.
Las pruebas de producción deben incluir recuperación tras ciclos de energía, deriva del reloj, desconexiones del sensor, entradas corruptas, agotamiento de memoria y actualizaciones interrumpidas. Defina qué ocurre cuando el modelo no puede ejecutarse o la confianza colapsa: un valor predeterminado seguro, un indicador de falla explícito o una regla convencional pueden ser preferibles a una suposición silenciosa. Rastree las versiones de hardware y firmware de la flota para que un error recién observado pueda aislarse a una revisión del dispositivo, entorno o versión del modelo.
Lista de verificación de implementación práctica
Convierta el concepto en un flujo de trabajo delimitado y verificable: detectar → preprocesar → inferir → decidir → actuar → actualizar. Asigne un responsable, documente los datos y dependencias, establezca una línea base sencilla, defina criterios de aceptación y de detención, pruebe fallas representativas y establezca monitoreo, retroceso y revisión antes de ampliar el alcance. Registre versiones y supuestos para que otro equipo pueda reproducir el resultado y entender qué cambió.
Antes del lanzamiento, realice una revisión documentada de preparación con las personas que construyen, operan, aseguran y se ven afectadas por el sistema. Pruebe casos normales, condiciones límite, fallas de dependencias y usos indebidos; preserve la evidencia y los riesgos no resueltos. Defina quién puede aprobar el lanzamiento, cambiar un umbral, sobrescribir una salida o detener la operación. Reconsidere la decisión cuando lleguen datos del mundo real, porque un piloto técnicamente exitoso no garantiza un rendimiento fiable a mayor escala.
- MEMORIA: pesos, activaciones y búferes.
- ENERGÍA: ciclo de trabajo y movimiento de datos.
- CALIDAD: precisión de campo bajo condiciones reales.
Preguntas frecuentes
¿Es TinyML lo mismo que IA móvil?
No exactamente. Los dispositivos móviles son sistemas de borde con procesadores y memoria comparativamente grandes. TinyML se centra en limitaciones mucho más estrictas de sistemas embebidos y de clase microcontrolador.
¿Pueden los modelos TinyML aprender en el dispositivo?
La mayoría de los despliegues entrenan en otro lugar y realizan inferencia en el dispositivo. La adaptación limitada es posible, pero la memoria, la energía, la estabilidad, la privacidad y los retrocesos hacen que el entrenamiento en el dispositivo sea más difícil.
Referencias principales












