
Fundamentos de la IA
Modelos de aprendizaje generativo vs. discriminativo

 Añade Unite.AI a tus fuentes preferidas en Google
Generativo y discriminativo describen lo que un modelo aprende sobre los datos y los objetivos. En la clasificación supervisada clásica, un modelo generativo aprende una distribución conjunta como P(x, y) o la distribución condicional de clase P(x|y), mientras que un modelo discriminativo aprende P(y|x) o una frontera de decisión directa.
Esta distinción es útil, pero los sistemas modernos a menudo combinan objetivos. Un modelo puede aprender representaciones generativas y luego ajustarse finamente para predicción discriminativa, o compartir una misma arquitectura base entre generación y clasificación.
Conclusiones clave
- Los clasificadores generativos modelan cómo se generan las entradas y las etiquetas; los clasificadores discriminativos modelan la etiqueta dada la entrada o una frontera.
- Los supuestos generativos pueden ayudar cuando hay pocos datos etiquetados, pero también pueden ser incorrectos.
- Los métodos discriminativos suelen enfocar la capacidad en la tarea de predicción y pueden lograr un menor error de clasificación asintótico.
- Los GAN, los VAE y los modelos de lenguaje son sistemas generativos, pero “generativo” no implica que cada componente sea un clasificador generativo.
Factorización de probabilidad
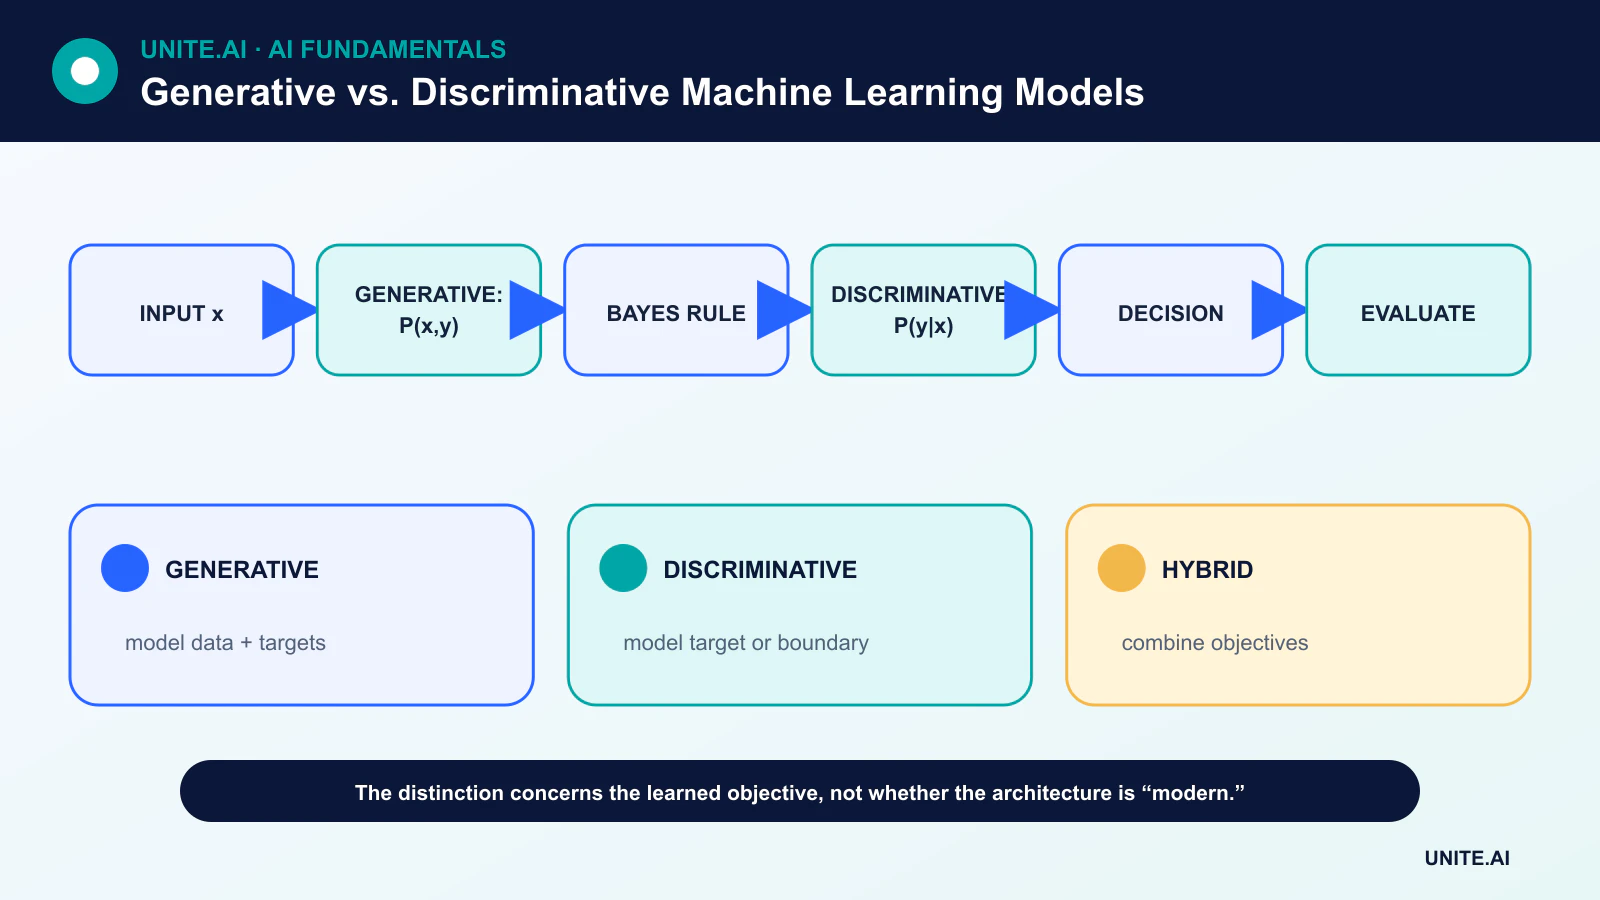
Un clasificador generativo puede estimar P(x|y) y P(y), y luego usar el teorema de Bayes para derivar P(y|x). Naive Bayes es un ejemplo clásico. Un clasificador discriminativo como la regresión logística estima P(y|x) directamente; una SVM aprende una frontera separadora.
Modelar P(x,y) es una tarea más amplia que predecir y a partir de x. Esa estructura adicional puede soportar muestreo o razonamiento con datos faltantes, pero también requiere supuestos sobre la distribución de entrada.
Eficiencia de datos y comportamiento asintótico
La comparación de Ng y Jordan entre Naive Bayes y regresión logística mostró un intercambio útil: bajo sus supuestos, el modelo generativo puede acercarse a su rendimiento límite con menos ejemplos, mientras que el modelo discriminativo puede alcanzar un error asintótico menor.
Esto no es una clasificación universal. Los resultados dependen de si la familia de modelos se ajusta a los datos, la dimensión, la regularización, la optimización y la calidad de las etiquetas. La comparación empírica en un diseño de validación representativo sigue siendo esencial.
Familias de modelos representativas
Los modelos generativos incluyen distribuciones condicionales por clase, modelos de Markov ocultos, modelos de mezcla, autoencoders variacionales, modelos de lenguaje autorregresivos, modelos de difusión y GAN.
Los modelos discriminativos incluyen regresión logística, árboles de decisión, campos aleatorios condicionales, máquinas de vectores de soporte y clasificadores neuronales. La misma arquitectura neuronal puede participar en cualquiera de las categorías según su objetivo de entrenamiento y salida.
Sistemas híbridos y auto‑supervisados
Un modelo de lenguaje o visión preentrenado puede aprender de datos no etiquetados con un objetivo generativo o auto‑supervisado, y luego recibir una cabeza discriminativa para una tarea objetivo. Los métodos semisupervisados pueden optimizar simultáneamente la clasificación etiquetada y un objetivo de datos no etiquetados.
La hibridación hace que las etiquetas de la arquitectura sean menos informativas que todo el pipeline de entrenamiento. La documentación debe indicar el objetivo, los datos, las salidas y la inferencia prevista, no simplemente calificar a un modelo como generativo.
Elegir entre enfoques
Use la tarea para decidir. Si el objetivo es una frontera calibrada con abundantes etiquetas, un modelo discriminativo es una línea base natural. Si el muestreo, la estimación de densidad, la estructura de datos faltantes o los datos no etiquetados son centrales, un componente generativo puede ayudar.
Compare la robustez, la eficiencia de muestreo, el cómputo, la verosimilitud o la calibración según corresponda. Una muestra generada de buena calidad no prueba que el clasificador sea bueno, y un clasificador de alta precisión no implica un modelo realista de la distribución de entrada.
Direcciones de probabilidad y objetivos de modelado
Un modelo discriminativo aprende una frontera o distribución condicional P(y|x): dado los rasgos x, predecir la etiqueta y. La regresión logística, las máquinas de vectores de soporte, los campos aleatorios condicionales y muchos clasificadores son discriminativos. Un modelo generativo aprende una distribución conjunta P(x,y), una distribución condicional por clase P(x|y) o una distribución de datos incondicional, lo que permite muestreo o tareas relacionadas con la verosimilitud. Naive Bayes y el análisis discriminante lineal son clasificadores generativos; los GAN, los autoencoders variacionales, los modelos de difusión y los modelos autorregresivos generan datos mediante diferentes objetivos.
La distinción se refiere a qué distribución o regla de decisión se modela, no a si se utiliza una red neuronal. Un modelo de lenguaje generativo puede ser incitado a clasificar, mientras que un reordenador discriminativo puede guiar la generación. Los supuestos generativos pueden mejorar la eficiencia de datos o manejar variables faltantes, pero generan riesgo de especificación incorrecta del modelo. Los métodos discriminativos a menudo sobresalen con abundantes datos etiquetados porque se enfocan directamente en la frontera de predicción. Compare las familias bajo igualdad de rasgos, datos, ajuste y cómputo, en lugar de considerar una categoría como universalmente superior.
Entrenamiento y evaluación por caso de uso
La evaluación de clasificación utiliza precisión, exhaustividad, calibración, robustez y costo de error. La evaluación generativa debe abordar fidelidad, diversidad, cobertura, verosimilitud o utilidad de la tarea, memorización y seguridad. Un modelo puede producir muestras atractivas mientras pierde modos, o lograr buena verosimilitud con una salida perceptual pobre. La utilidad de datos sintéticos debe probarse entrenando y evaluando modelos posteriores con datos reales independientes, incluidos grupos raros. Mantenga los datos de prueba fuera de los prompts y la selección de generación.
En el aprendizaje semisupervisado, un modelo generativo puede explotar la estructura no etiquetada; en detección de anomalías, la verosimilitud puede fallar cuando datos fuera de distribución reciben alta densidad por razones irrelevantes. En generación aumentada por recuperación, un modelo generativo de respuestas y un recuperador o reordenador discriminativo forman un híbrido. Diagnose las etapas por separado para que la salida fluida no oculte fallos de recuperación. Elija la descomposición que haga la evidencia y el control observables.
Despliegue y gobernanza
Los sistemas generativos añaden riesgos de procedencia del contenido, propiedad intelectual, suplantación, inyección de prompts y moderación de salida; los sistemas discriminativos añaden riesgos de umbral, denegación y errores desiguales. Ambos requieren derechos de datos, artefactos seguros, versionado, pruebas representativas, monitoreo y autoridad humana proporcional a las consecuencias. Registre el objetivo preciso y la semántica de la salida en la documentación. Generativo versus discriminativo es una distinción estadística útil, pero los sistemas reales a menudo los combinan, y la fiabilidad depende de todo el pipeline de datos y decisiones.
Ejemplo práctico: clasificación y generación de respuestas de soporte
Una plataforma de soporte utiliza un clasificador discriminativo para identificar el tipo de problema y la urgencia, y un modelo generativo para redactar una respuesta a partir de políticas aprobadas. El clasificador se evalúa con exhaustividad específica por clase y calibración; el recuperador con exhaustividad de evidencia; el generador con fundamentación, corrección y rechazo. Cada etapa tiene un resultado desconocido, y el modelo generativo no puede modificar la clasificación ni el derecho del cliente mediante texto persuasivo.
Los agentes ven la ruta predicha, las fuentes y el borrador, y aprueban o corrigen antes de enviarlo. Los filtros de permiso se aplican antes de la recuperación, y la inyección de prompts en el texto del cliente no puede autorizar herramientas. El monitoreo separa errores de enrutamiento, brechas de recuperación, declaraciones no respaldadas y ediciones de los agentes. Un cambio de política actualiza las fuentes de inmediato y desencadena pruebas de regresión; el ajuste se reserva para comportamientos estables. El diseño híbrido aprovecha las fortalezas discriminativas y generativas mientras preserva la evidencia y la autoridad humana.
Evidencia de implementación y preparación operativa
Una decisión de producción necesita más que una demostración exitosa. Defina los usuarios previstos, el entorno operativo, las entradas, salidas, dependencias, propietario y la consecuencia de cada falla importante. Establezca una línea base reproducible y un conjunto de evaluación versionado antes del ajuste. Pruebe casos ordinarios, condiciones límite, entradas mal formadas o ausentes, cambios de distribución, interrupciones de dependencias, usos indebidos y los grupos o entornos que probablemente estén desatendidos. Mida la calidad de la tarea junto con calibración o incertidumbre, latencia, rendimiento, costo de recursos, accesibilidad, privacidad y seguridad. Registre cada transformación y umbral para que un revisor independiente pueda reproducir el resultado y distinguir la evidencia de un prototipo atractivo.
Antes del lanzamiento, asigne autoridad para la publicación, excepciones, cambios, retroceso y retiro. Utilice un despliegue por etapas, preserve una alternativa segura y verifique el monitoreo con fallas inyectadas deliberadamente. La telemetría operativa debe revelar la calidad de entrada, el comportamiento de salida, la versión del modelo o regla, la salud de las dependencias, las anulaciones humanas y los resultados confirmados sin recopilar datos sensibles innecesarios. Defina umbrales de alerta y un responsable de respuesta, luego revise la evidencia del mundo real después del despliegue en lugar de asumir que el rendimiento offline persistirá. Reevalue siempre que cambien las fuentes de datos, usuarios, modelos, proveedores, políticas, hardware u objetivos. Un sistema mantenido también necesita procedimientos documentados de recuperación, aprendizaje de incidentes, eliminación y retención, y un punto claro en el que debe desactivarse o reemplazarse.
Preguntas frecuentes
¿El discriminador de un GAN es un modelo discriminativo?
Realiza discriminación durante el entrenamiento, pero el GAN en su conjunto es un marco generativo cuyo output es producido por el generador.
¿El aprendizaje discriminativo es siempre supervisado?
No. El término describe la relación o frontera modelada, mientras que la supervisión describe la señal de entrenamiento. Los objetivos modernos pueden difuminar las categorías.
Referencias principales












